
AI Agent / 系统课时
添加节点与顺序边
添加节点与顺序边
一个可维护的 LangGraph 工作流应把处理步骤拆成职责单一的节点,再用边声明执行顺序。本节把两个普通 Python 函数注册为节点,通过 START、普通边和 END 组成确定性的处理链,并实际运行验证状态如何逐步更新。
学习目标
- 把纯函数注册为
StateGraph节点 - 使用普通边表达无条件的顺序执行关系
- 编译并运行最小图,检查最终状态是否符合预期
节点负责计算,边负责控制流
StateGraph 中的节点接收当前状态,并返回需要更新的部分状态。节点本身不需要决定下一步去哪里;确定性的控制流由图上的普通边表达。这种分工能把业务计算和流程编排分离开。
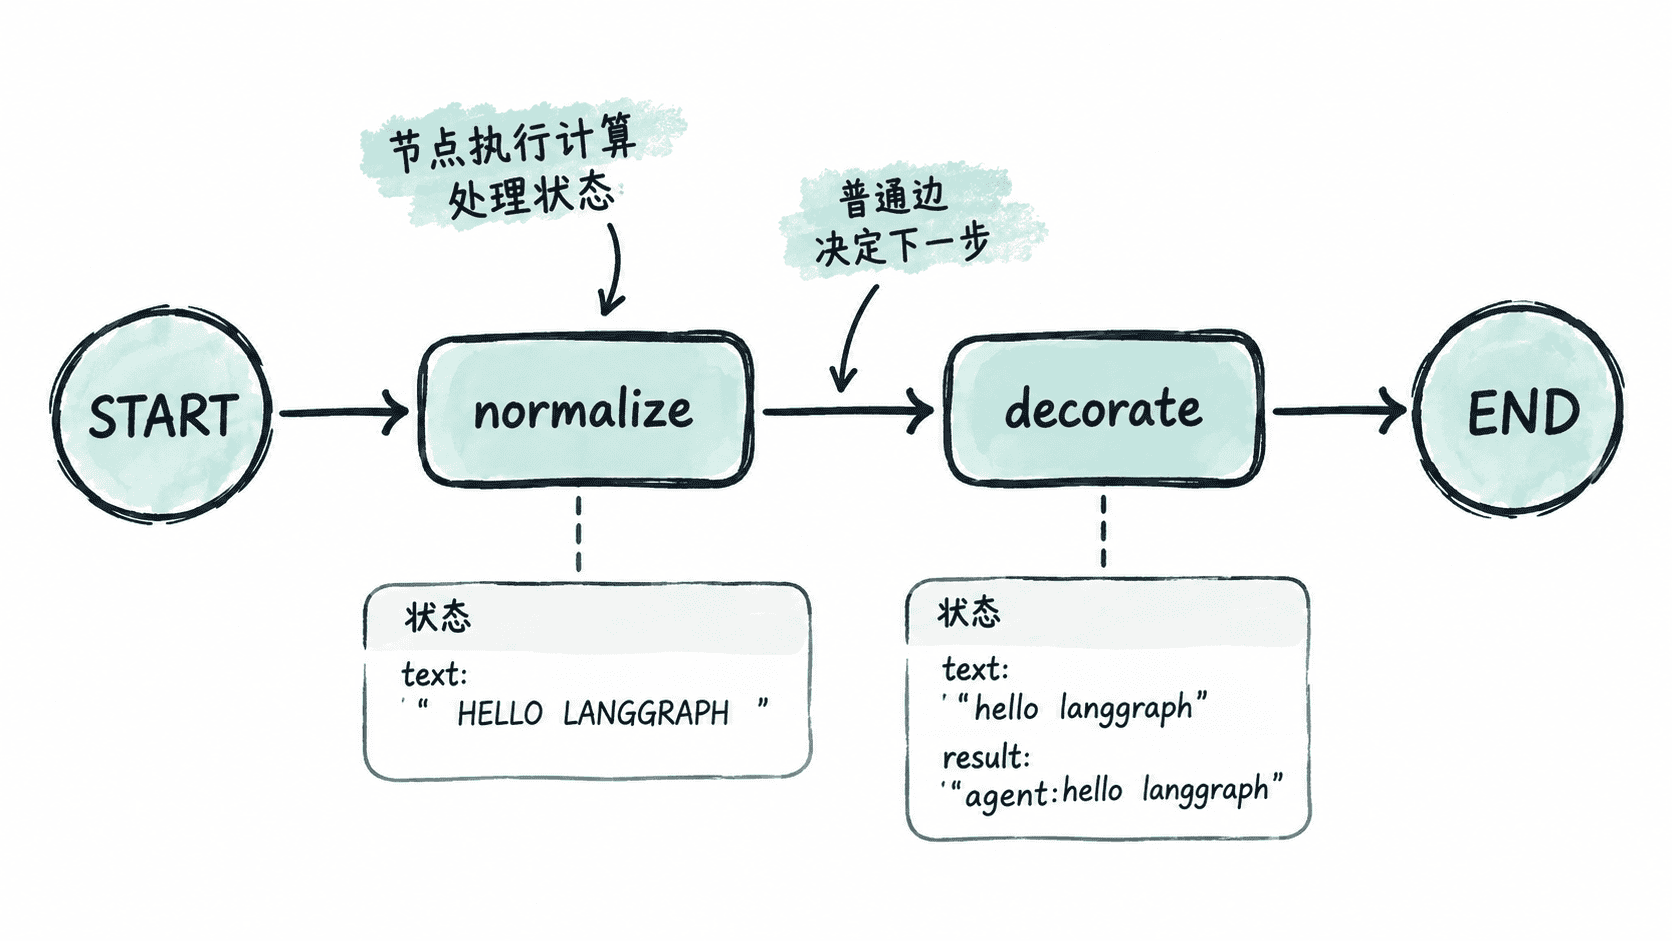
例如,一个文本处理流程可以先执行清洗,再添加业务前缀。清洗节点只关心如何修改文本,格式化节点只关心如何生成结果,而 normalize -> decorate 这条边负责说明二者的先后关系。
注册节点并连接顺序边
下面的状态包含原始文本和最终结果。两个节点都是普通函数,并且只返回自己负责更新的字段。START 和 END 是图的虚拟起点与终点,真正执行的业务节点仍然只有 normalize 和 decorate。
from typing_extensions import TypedDict
from langgraph.graph import END, START, StateGraph

class TextState(TypedDict, total=False):
    text: str
    result: str


def normalize(state: TextState) -> dict:
    # 清洗节点只负责标准化输入文本。
    return {"text": state["text"].strip().lower()}


def decorate(state: TextState) -> dict:
    # 第二个节点读取前一节点写回的新 text。
    return {"result": f"agent:{state['text']}"}


builder = StateGraph(TextState)
builder.add_node("normalize", normalize)
builder.add_node("decorate", decorate)

builder.add_edge(START, "normalize")
builder.add_edge("normalize", "decorate")
builder.add_edge("decorate", END)

graph = builder.compile()
result = graph.invoke({"text": "  HELLO LANGGRAPH  "})
print(result)
预期输出
{'text': 'hello langgraph', 'result': 'agent:hello langgraph'}执行从 START 进入 normalize。它返回的新 text 被写入状态后,普通边把控制权交给 decorate;第二个节点读取更新后的 text 并写入 result,随后沿边到达 END。
保持节点职责单一
节点可以是函数或其他可调用对象,但维护成本最低的做法通常是让一个节点只完成一个清晰动作,并通过返回值描述状态变化。这样可以单独测试节点,也更容易在以后插入重试、持久化或条件分支。
不要把整个智能体流程塞进一个巨大的节点,再把图仅仅当作外壳。那样虽然也能运行,但图本身无法表达实际控制流,出现失败时也很难判断是哪一步产生了错误状态。
同样,节点最好返回局部更新,而不是为了修改一个字段就重新构造全部状态。状态字段增多以后,这能减少节点之间不必要的耦合。
普通边只表达无条件转移
add_edge 适合下一步已经确定的场景,例如预处理后一定进入模型调用、模型输出后一定执行格式化。只要源节点完成,流程就沿固定目标继续。
如果下一步取决于状态内容,例如模型决定调用工具还是直接结束,就不应把两条可能路径都写成普通顺序边来模拟判断。此时需要条件路由,让控制流根据运行时状态选择目标。
因此,设计图时可以先问一个问题:源节点执行完以后,下一节点是否始终唯一且确定? 如果答案是肯定的,用普通边最清晰;如果答案是否定的,就应把分支条件显式建模,而不是隐藏在节点内部。