
AI Agent / 系统课时
配置节点重试与超时边界
配置节点重试与超时边界
外部模型、HTTP 服务和工具调用会遇到短暂抖动,也会遇到不可恢复的业务错误。本篇把“是否重试、等多久、最多几次、单次最长多久”放到节点策略里,避免一个不稳定节点无限占用整张图。
学习目标
- 用
RetryPolicy只重试暂时性异常,并配置退避、抖动与最大尝试次数 - 为异步节点设置单次执行超时,让卡住的调用及时失败
- 区分可重试故障、永久错误与具有副作用的节点边界
先划分哪些失败值得重试
重试不是“捕获所有异常再试一次”。网络断连、限流、临时上游错误通常具有瞬时性;参数校验失败、权限拒绝、业务规则冲突则往往重复执行也不会改变结果。RetryPolicy.retry_on 可以接收异常类型、异常类型序列或判断函数,因此最稳妥的做法是把可恢复错误显式列入白名单。当前 API 中 max_attempts 统计总尝试次数,包含第一次执行。 ([LangChain 参考文档][2])
退避用于避免故障期间立即形成请求风暴。initial_interval 决定首次重试前等待多久,backoff_factor 让后续间隔逐步放大,max_interval 限制最长等待;jitter 可打散大量并发实例同时重试的时间点。
重试与超时如何组合
超时解决“单次尝试卡太久”,重试解决“失败后是否再给机会”。在当前 Python Graph API 中,add_node 可同时设置 retry_policy 与 timeout;超时会产生 NodeTimeoutError,随后仍由重试策略判断是否重试。节点超时只支持可取消的异步节点,同步阻塞函数不能依赖这一机制安全中断。 ([LangChain 参考文档][3])
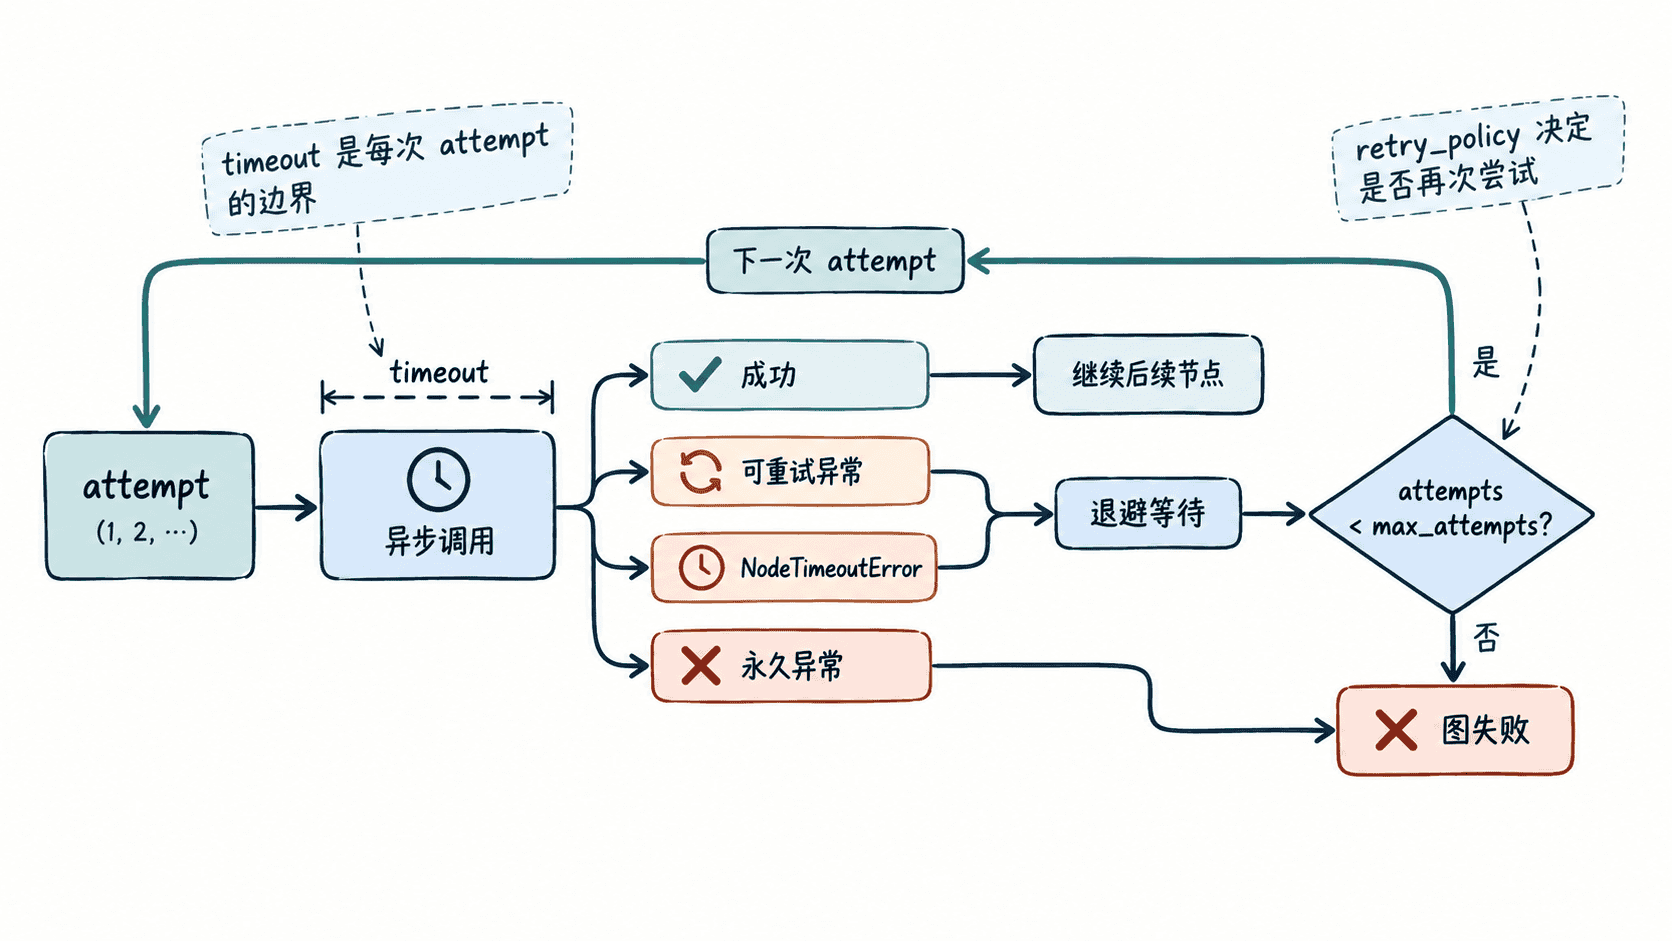
把超时设得极短会把正常慢请求误判为故障,把重试次数设得过高则会放大下游压力。两者必须结合服务的正常延迟分布和调用成本设置,而不是统一套一个全局数字。
完整示例
下面模拟一个前两次失败、第三次成功的异步远程调用。策略只对白名单中的 TransientError 和 NodeTimeoutError 重试,并把每次尝试的硬超时设为 0.2 秒。
import asyncio

from typing_extensions import TypedDict
from langgraph.errors import NodeTimeoutError
from langgraph.graph import END, START, StateGraph
from langgraph.types import RetryPolicy

class State(TypedDict, total=False):
    result: str

class TransientError(RuntimeError):
    pass

attempts = 0

def retry_if_transient(exc: Exception) -> bool:
    return isinstance(exc, (TransientError, NodeTimeoutError))

async def fetch_remote(state: State) -> dict:
    global attempts
    attempts += 1
    print(f"attempt={attempts}")

    # 模拟一次可取消的异步网络等待。
    await asyncio.sleep(0.05)
    if attempts < 3:
        raise TransientError("temporary upstream failure")
    return {"result": "ok"}

builder = StateGraph(State)
builder.add_node(
    "fetch_remote",
    fetch_remote,
    retry_policy=RetryPolicy(
        initial_interval=0.05,
        backoff_factor=2.0,
        max_interval=0.2,
        max_attempts=3,
        jitter=False,
        retry_on=retry_if_transient,
    ),
    timeout=0.2,
)
builder.add_edge(START, "fetch_remote")
builder.add_edge("fetch_remote", END)
graph = builder.compile()

async def main() -> None:
    result = await graph.ainvoke({})
    print(result)

asyncio.run(main())
预期输出
attempt=1
attempt=2
attempt=3
{'result': 'ok'}
如果把节点中的等待时间改成大于 0.2 秒,每次尝试会先触发 NodeTimeoutError;因为判断函数把该异常列为可重试,仍会按同一退避策略再次尝试,直到成功或耗尽 max_attempts。
生产边界
模型推理、网络请求和只读工具通常适合有限重试;扣款、发消息、创建工单等有外部副作用的节点必须先设计幂等键或去重机制,否则一次“超时但服务端实际成功”的请求可能在重试时重复生效。
不要用重试掩盖确定性错误。参数错误、鉴权失败或不可满足的业务条件应尽快失败并交给错误处理分支。对于长时间但持续有进展的异步任务,可以进一步使用 TimeoutPolicy 区分硬运行上限与空闲超时;当前 API 支持 run_timeout、idle_timeout 以及进度刷新策略。 ([LangChain 参考文档][4])