
AI Agent / 系统课时
编排分类检索与工具执行
编排分类检索与工具执行
这一节把工单处理拆成可追踪的 LangGraph 主流程:先分类,再只执行当前工单需要的知识检索、业务查询或处理工具。最终每个节点都留下轨迹,既能解释为什么走这条路径,也便于后续接入监控和人工审批。
学习目标
- 用条件边把分类结果映射到不同处理分支
- 把知识检索、业务查询和处理动作封装为独立工具
- 在共享状态中保留节点轨迹,验证一次工单的完整执行路径
先确定主流程边界
不要让一个大节点同时完成分类、检索、查库和执行动作。更稳定的拆法是让分类节点只产生明确类别,再由图决定下一跳。这里用 faq、order、refund 三类:FAQ 只查知识,订单类查询业务数据,退款类先查订单再调用处理工具。
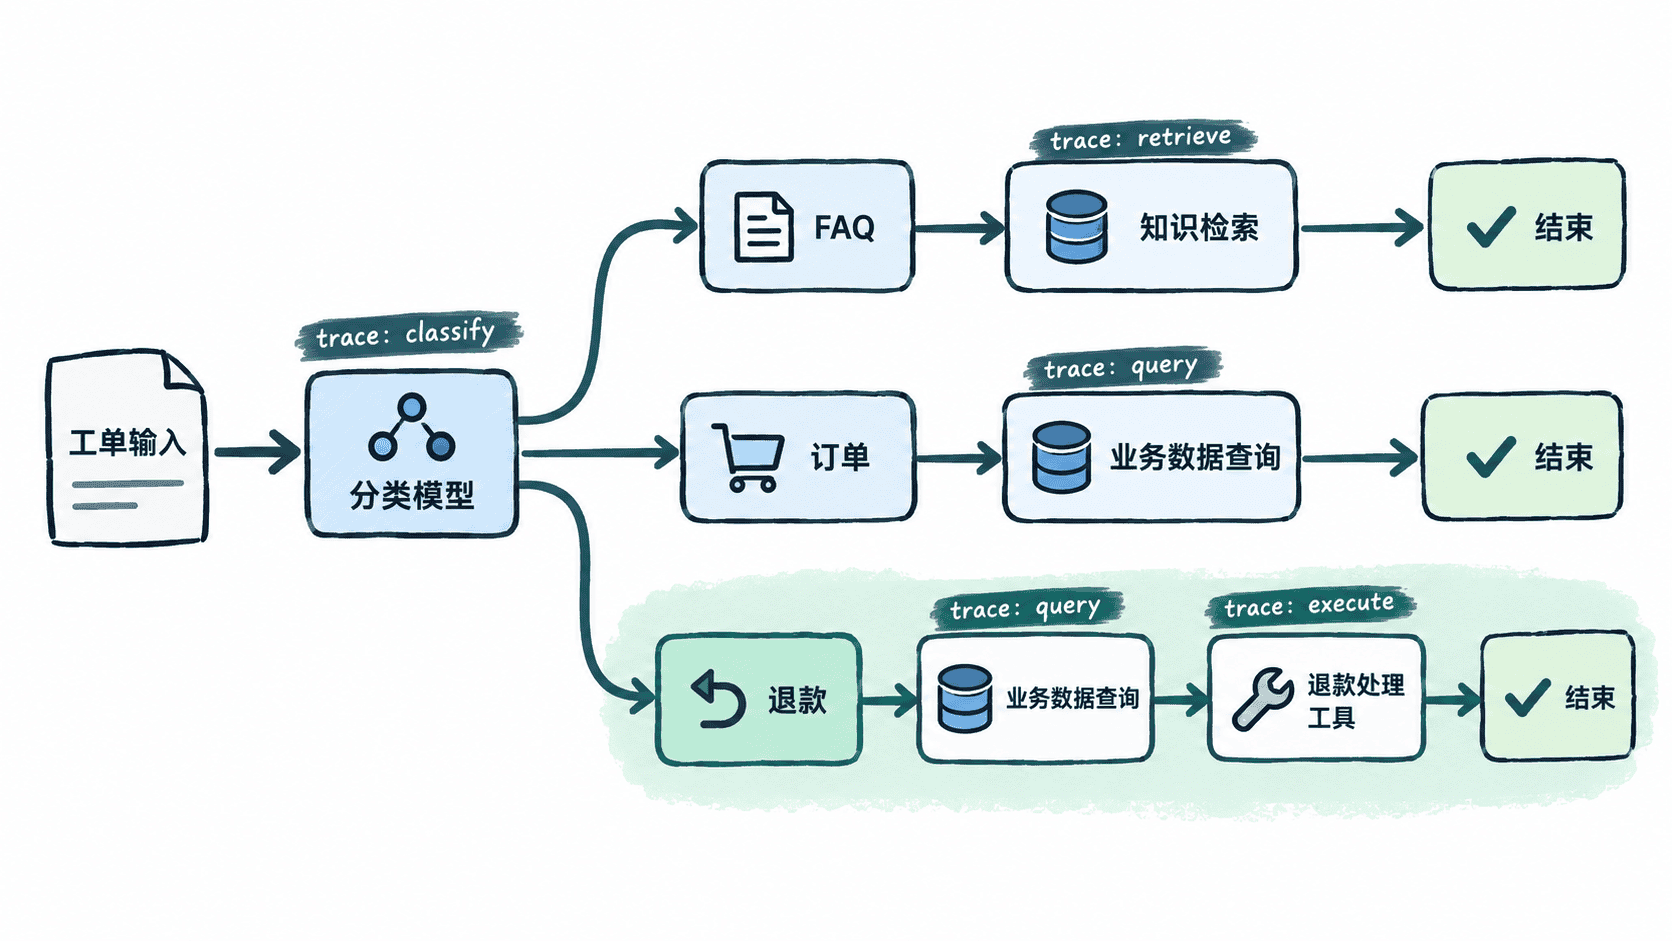
这种结构的关键不是节点数量,而是副作用边界清楚:检索和查询主要读取数据,退款工具会产生真实业务影响,因此它必须位于分类和数据校验之后。
用状态和条件边编排
下面示例为保证本地可复现,用一个可替换的“模型桩”模拟分类结果;生产环境可把 classify_model 换成真实 LLM 的结构化输出,图的分支结构不需要改变。示例中的三个工具分别模拟知识库、订单系统和退款系统。
from operator import add
from typing import Annotated, Literal

from langchain_core.tools import tool
from langgraph.graph import END, START, StateGraph
from typing_extensions import TypedDict

class TicketState(TypedDict, total=False):
    ticket: str
    order_id: str
    category: Literal["faq", "order", "refund"]
    knowledge: str
    order: dict[str, object]
    action_result: str
    trace: Annotated[list[str], add]

def classify_model(text: str) -> Literal["faq", "order", "refund"]:
    # 模型桩只负责给出受控类别;真实项目可替换为 LLM 结构化输出。
    if "退款" in text or "重复扣款" in text:
        return "refund"
    if "订单" in text or "物流" in text:
        return "order"
    return "faq"

@tool
def search_knowledge(query: str) -> str:
    """检索客服知识库。"""
    return "退款规则:重复扣款可原路退回。"

@tool
def get_order(order_id: str) -> dict[str, object]:
    """查询订单系统。"""
    if order_id != "A100":
        raise ValueError("order not found")
    return {"order_id": order_id, "amount": 299, "status": "paid"}

@tool
def refund_order(order_id: str, amount: int) -> str:
    """提交退款处理。"""
    return f"refund_queued:{order_id}:{amount}"

def classify(state: TicketState) -> TicketState:
    category = classify_model(state["ticket"])
    return {"category": category, "trace": [f"classify:{category}"]}

def retrieve(state: TicketState) -> TicketState:
    text = search_knowledge.invoke({"query": state["ticket"]})
    return {"knowledge": text, "trace": ["retrieve:knowledge"]}

def query_order(state: TicketState) -> TicketState:
    order = get_order.invoke({"order_id": state["order_id"]})
    return {"order": order, "trace": [f"query_order:{state['order_id']}"]}

def execute_refund(state: TicketState) -> TicketState:
    order = state["order"]
    result = refund_order.invoke(
        {"order_id": str(order["order_id"]), "amount": int(order["amount"])}
    )
    return {"action_result": result, "trace": [f"execute_refund:{order['order_id']}"]}

def after_classify(state: TicketState) -> Literal["retrieve", "query_order"]:
    return "retrieve" if state["category"] == "faq" else "query_order"

def after_order(state: TicketState) -> Literal["execute_refund", "end"]:
    return "execute_refund" if state["category"] == "refund" else "end"

builder = StateGraph(TicketState)
builder.add_node("classify", classify)
builder.add_node("retrieve", retrieve)
builder.add_node("query_order", query_order)
builder.add_node("execute_refund", execute_refund)
builder.add_edge(START, "classify")
builder.add_conditional_edges(
    "classify",
    after_classify,
    {"retrieve": "retrieve", "query_order": "query_order"},
)
builder.add_edge("retrieve", END)
builder.add_conditional_edges(
    "query_order",
    after_order,
    {"execute_refund": "execute_refund", "end": END},
)
builder.add_edge("execute_refund", END)
graph = builder.compile()

result = graph.invoke(
    {
        "ticket": "订单 A100 重复扣款,请退款",
        "order_id": "A100",
        "trace": [],
    }
)
print(result["category"])
print(result["action_result"])
print(" -> ".join(result["trace"]))
预期输出:
refund
refund_queued:A100:299
classify:refund -> query_order:A100 -> execute_refund:A100
trace 使用列表累加器,因此节点只需追加自己的记录,不必复制整段历史。真实系统可以把同样的节点名、工单 ID、耗时和工具结果摘要写入日志或 tracing 平台。
把分类结果限制成可路由值
分类节点最重要的约束是不要输出自由文本再靠字符串猜路径。类别应该是枚举或其他受控值,并由条件边集中映射到节点。这样即使分类模型更换,路由契约仍然稳定。
知识检索和业务查询也要保持职责单一:检索返回证据,业务查询返回事实,真正改变订单状态的工具放在最后。这样当某个节点失败时,可以明确知道是“判断错”“数据没查到”还是“动作执行失败”。
验收一次完整路径
至少用三类输入分别验证三条路径:FAQ 不应访问订单系统,普通订单查询不应调用退款工具,退款工单必须先拿到订单数据再执行动作。验收重点不是最终文案,而是不需要的节点确实没有运行。
当分类、读取能力和写入型工具被拆成独立节点后,主流程就具备了清晰的控制边界。后续无论加入重试、超时、审批还是持久化恢复,都可以针对具体节点扩展,而不用重新拆整条链路。