
AI Agent / 系统课时
定义工单智能体状态与验收标准
定义工单智能体状态与验收标准
生产级工单智能体必须先约定“什么信息属于共享状态、什么情况下算完成”。本节把分类、上下文、证据、动作计划和审批结果建成可检查的状态契约,再把成功、等待与失败写成机器可判定的验收规则。
学习目标
- 把工单处理过程中的事实、证据、计划和控制状态拆成清晰字段。
- 用
TypedDict定义可被 LangGraph 节点共享和更新的状态结构。 - 把成功、等待审批和失败条件写成确定性的验收函数。
先把共享状态拆成可验证字段
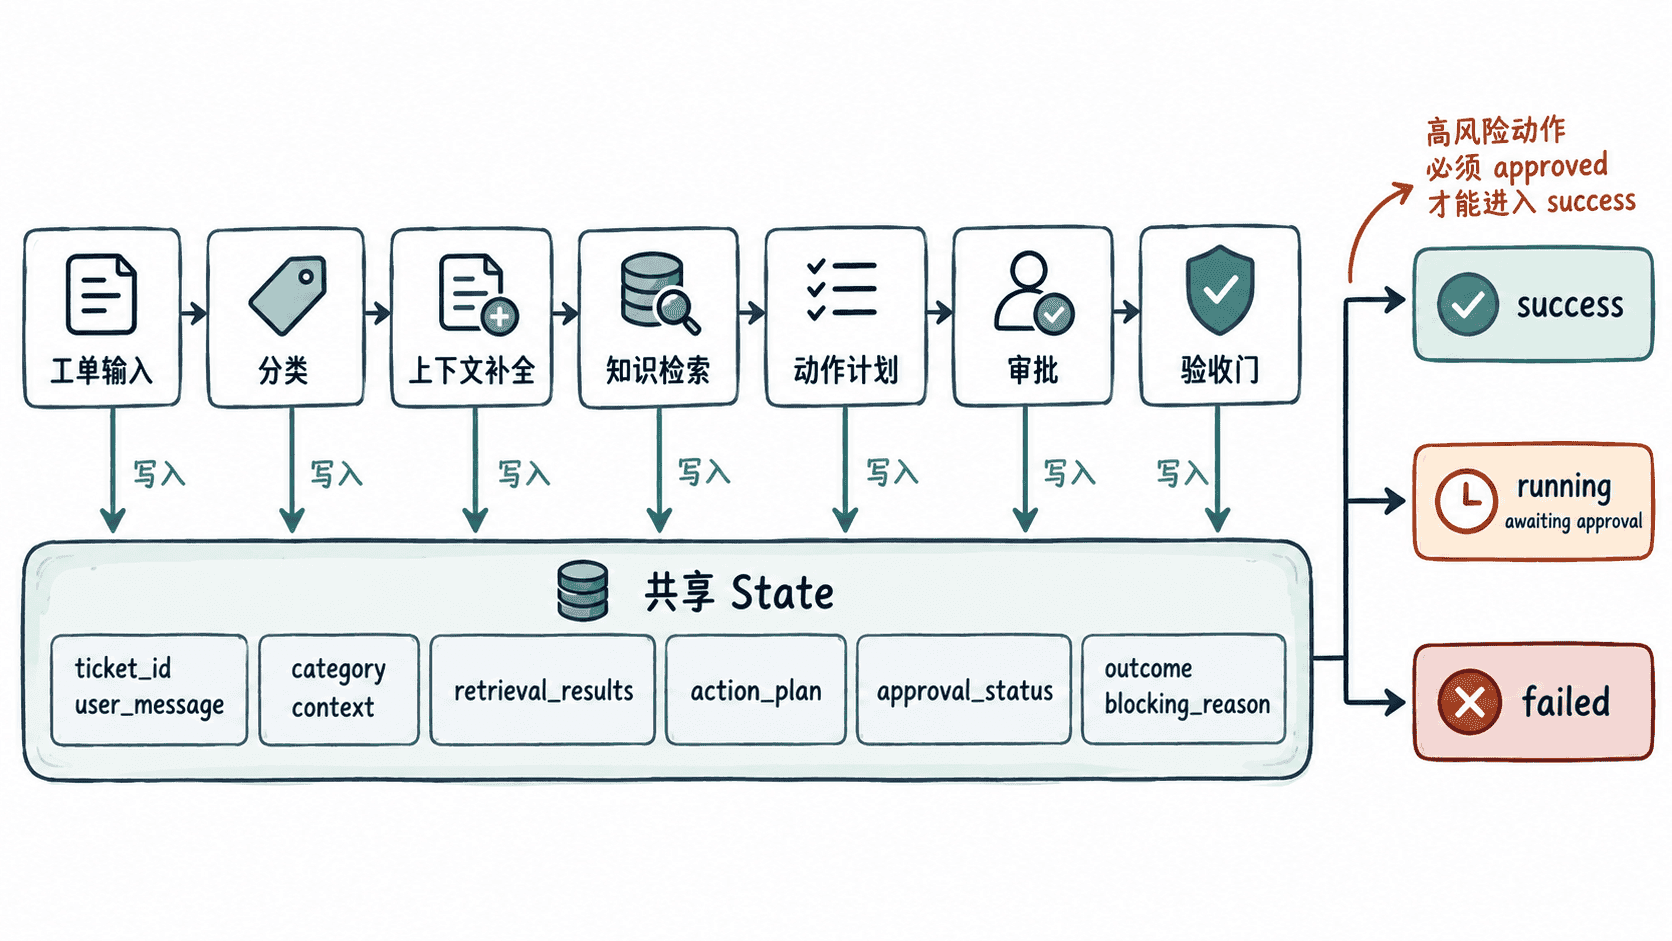
工单智能体的状态不应只是一个不断膨胀的 messages 列表。后续节点需要明确知道“分类结果是什么、查到了哪些证据、准备执行什么动作、是否已经获批”,因此这些信息应成为独立字段,而不是让每个节点重新从自然语言里猜。
| 状态组 | 典型字段 | 作用 |
|---|---|---|
| 工单身份 | ticket_id、user_message |
锁定一次处理对象和原始诉求 |
| 分类与上下文 | category、context |
决定路由,并保存客户或账户事实 |
| 检索证据 | retrieval_results |
让回答和动作有可追溯依据 |
| 动作计划 | action_plan |
明确准备调用的工具及风险级别 |
| 审批与终态 | approval_status、outcome、blocking_reason |
控制高风险动作并给出最终验收结果 |
状态字段应该保存后续节点真正需要的结构化事实。大型文档正文、完整数据库对象或一次性中间日志更适合保存引用 ID 或外部存储位置,避免每一步都复制无关数据。
用类型约束状态与验收结果
下面的最小图只实现“验收门”,但状态结构已经覆盖完整工单链路。实际项目中的分类、检索和工具节点只需要各自返回负责字段的增量更新,最后统一进入验收节点。
from typing import Literal, TypedDict

from langgraph.graph import END, START, StateGraph

# 把检索证据和动作计划也结构化,避免后续节点解析自由文本。
class Evidence(TypedDict):
    source: str
    snippet: str

class PlannedAction(TypedDict):
    name: str
    risk: Literal["low", "high"]

class TicketState(TypedDict):
    ticket_id: str
    user_message: str
    category: Literal["billing", "account", "technical", "unknown"]
    context: dict[str, str]
    retrieval_results: list[Evidence]
    action_plan: list[PlannedAction]
    approval_status: Literal["not_required", "pending", "approved", "rejected"]
    outcome: Literal["running", "success", "failed"]
    blocking_reason: str | None

# 验收门只读取状态并返回终态增量,不调用模型。
def evaluate_acceptance(state: TicketState) -> dict:
    if state["category"] == "unknown":
        return {"outcome": "failed", "blocking_reason": "category_unresolved"}

    if "customer_id" not in state["context"]:
        return {"outcome": "failed", "blocking_reason": "missing_customer_context"}

    if not state["retrieval_results"]:
        return {"outcome": "failed", "blocking_reason": "no_supporting_evidence"}

    if not state["action_plan"]:
        return {"outcome": "failed", "blocking_reason": "empty_action_plan"}

    # 高风险动作必须显式通过审批,pending 仍然属于运行中。
    high_risk = any(action["risk"] == "high" for action in state["action_plan"])
    if high_risk and state["approval_status"] == "pending":
        return {"outcome": "running", "blocking_reason": "awaiting_approval"}

    if high_risk and state["approval_status"] != "approved":
        return {"outcome": "failed", "blocking_reason": "approval_rejected"}

    return {"outcome": "success", "blocking_reason": None}

# 最小图只挂载验收节点,便于单独测试状态契约。
builder = StateGraph(TicketState)
builder.add_node("acceptance", evaluate_acceptance)
builder.add_edge(START, "acceptance")
builder.add_edge("acceptance", END)
graph = builder.compile()

# 样例模拟“高风险退款已批准”,因此应通过验收。
result = graph.invoke(
    {
        "ticket_id": "T-1001",
        "user_message": "请退回重复扣款",
        "category": "billing",
        "context": {"customer_id": "C-9", "order_id": "O-17"},
        "retrieval_results": [
            {"source": "refund-policy", "snippet": "重复扣款可原路退款"}
        ],
        "action_plan": [{"name": "refund_payment", "risk": "high"}],
        "approval_status": "approved",
        "outcome": "running",
        "blocking_reason": None,
    }
)

print(f"outcome={result['outcome']}")
print(f"blocking_reason={result['blocking_reason']}")
预期输出
outcome=success
blocking_reason=None
这个例子刻意把验收逻辑写成普通确定性函数,而不是交给模型“判断是否完成”。这样同一份状态总会得到同一结论,测试也可以直接覆盖每个失败分支。
把完成定义成可测试的契约
success 不应等价于“模型已经生成一句回复”。对这个工单智能体,更可靠的定义是:分类已解析、必要上下文齐全、存在可追溯证据、动作计划非空,并且任何高风险动作都已经获得批准。只有这些条件同时成立,终态才能进入 success。
running 表示流程尚未失败但也未验收,例如高风险退款已经生成计划却仍在等待审批。failed 则表示继续自动执行没有意义或不安全,例如分类仍未知、关键客户信息缺失、没有支撑证据、计划为空,或审批被拒绝。把三种状态分开,可以避免“等待人工”被误报成失败,也避免半成品被误报成成功。
让每个节点只拥有自己的字段
分类节点只更新 category,检索节点只更新 retrieval_results,计划节点只更新 action_plan,审批节点只更新 approval_status。这种“字段所有权”能减少并行节点覆盖彼此结果,也让失败恢复时更容易判断哪个字段已经可信。
进入综合演练前,可以用一组状态样例直接调用验收节点:正常低风险工单应成功,高风险但待审批应保持 running,审批拒绝或关键证据缺失应失败。只要这些状态契约先固定,后续接入模型、检索器和真实工具时,工作流的完成条件就不会随着提示词漂移。