
AI Agent / 系统课时
用 Send 动态拆分批量任务
用 Send 动态拆分批量任务
当待处理项只有在运行时才知道数量时,预先画死边并不合适。本篇用 Send 把一批输入动态扇出到同一个节点并行执行,再通过 reducer 合并结果,得到可复用的 map-reduce 工作流骨架。
学习目标
- 使用
Send根据运行时列表动态创建下游任务 - 用 reducer 安全聚合多个并行节点对同一状态字段的更新
- 识别动态扇出中的输入状态、并发写入与任务粒度边界
为什么 Send 适合运行时批量拆分
普通边在建图时已经确定,适合固定拓扑;Send 则由条件边函数在运行时返回,每个 Send 同时指定目标节点和该次调用专属的输入状态。因此,同一个节点可以针对 N 个元素产生 N 次调用,而 N 无须在编译图时已知。当前 Python Graph API 把它作为动态 map-reduce 的核心控制流原语。 ([LangChain 参考文档][1])
例如输入有 3 个整数时,路由函数可以生成 3 个 Send("double_one", {"item": ...})。三个任务只拿到各自的 item,无需复制整份批量状态。
扇出与聚合如何配合
扇出解决“任务数动态变化”,聚合解决“多个并行结果怎样写回同一个字段”。如果多个任务都直接更新同一普通状态键,LangGraph 无法判断这些值应该覆盖、拼接还是求和;因此 map-reduce 场景通常给结果字段声明 reducer。
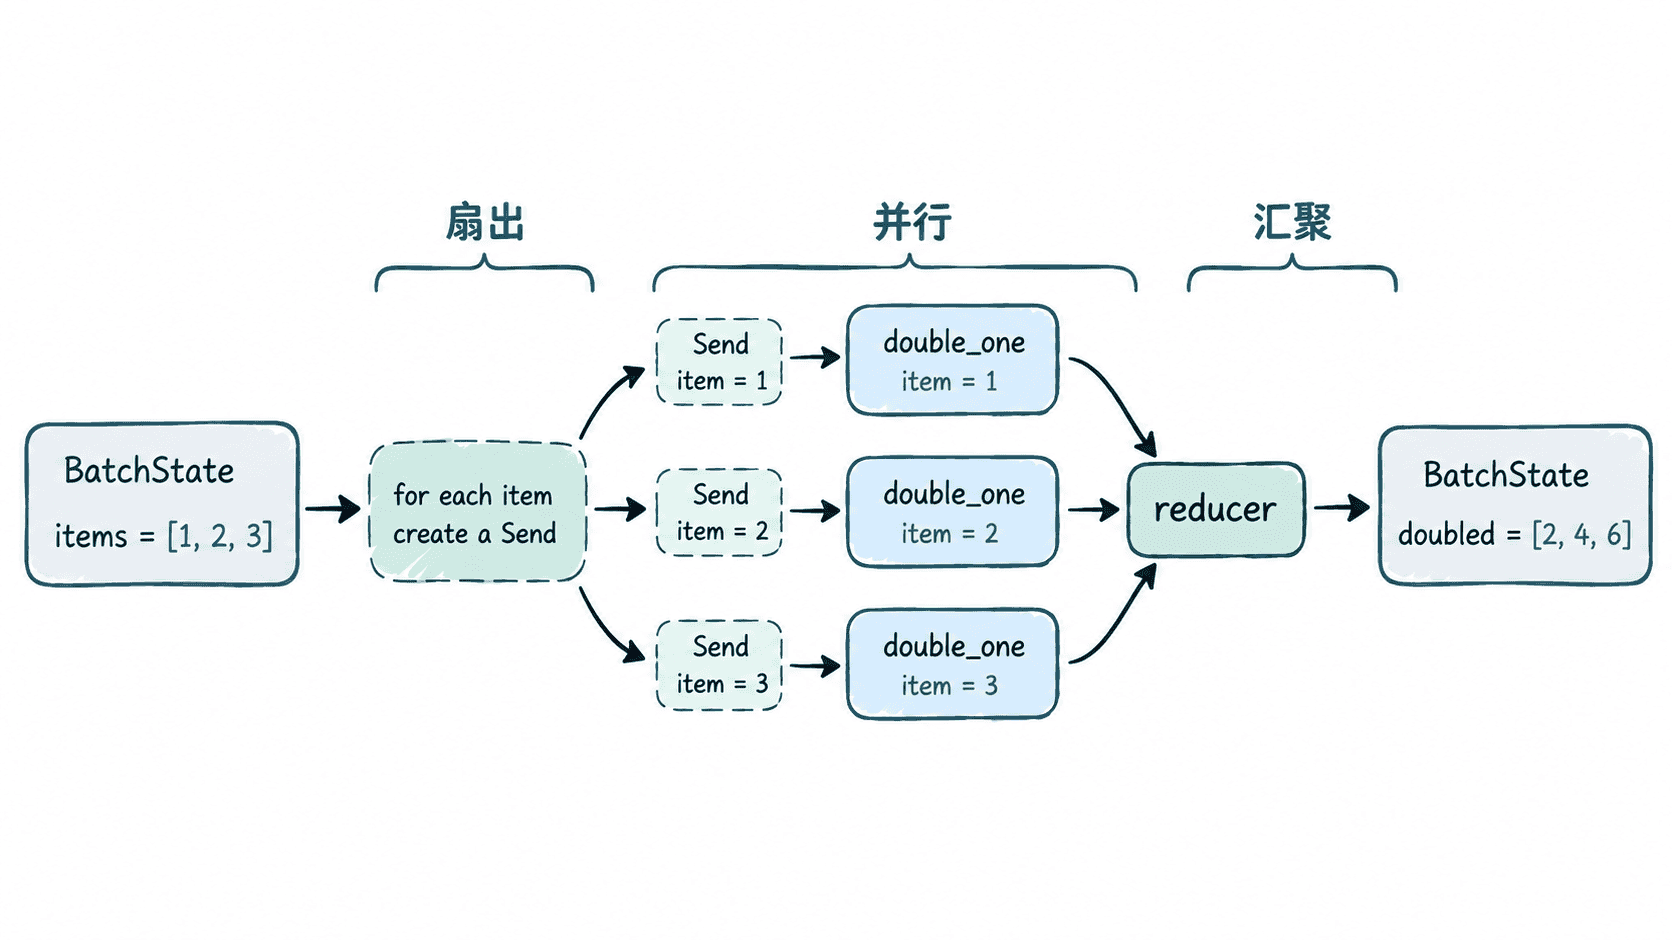
这里的 reducer 只负责合并并发更新,不负责启动任务。Send 与 reducer 分工清楚:前者控制“创建多少次调用以及每次传什么”,后者控制“多个返回值怎样归并”。
完整示例
下面的程序把输入列表动态拆成多个 double_one 调用。doubled 使用 operator.add 作为 reducer,因此每个并行任务返回的单元素列表会被拼接起来。
from operator import add
from typing import Annotated

from typing_extensions import TypedDict
from langgraph.graph import END, START, StateGraph
from langgraph.types import Send

class BatchState(TypedDict):
    items: list[int]
    doubled: Annotated[list[int], add]

def fan_out(state: BatchState) -> list[Send]:
    # 每个 Send 都把同一节点与一份独立子状态绑定起来。
    return [Send("double_one", {"item": item}) for item in state["items"]]

def double_one(state: dict[str, int]) -> dict:
    # Send 传入的子状态只需要包含当前 item。
    return {"doubled": [state["item"] * 2]}

builder = StateGraph(BatchState)
builder.add_node("double_one", double_one)
builder.add_conditional_edges(START, fan_out)
builder.add_edge("double_one", END)
graph = builder.compile()

result = graph.invoke({"items": [1, 2, 3], "doubled": []})
print(sorted(result["doubled"]))
预期输出
[2, 4, 6]示例最后排序只是为了让演示输出稳定;业务逻辑如果依赖原始顺序,应显式携带索引并在聚合后按索引恢复,而不要把并行完成顺序当成输入顺序。
边界与常见错误
Send 适合“同一种处理逻辑作用于运行时产生的一组元素”,例如批量检索、分段摘要、多个候选工具调用。若每个分支的逻辑本身不同,普通条件边通常更直观。
并发任务会独立执行节点函数,因此节点中的外部副作用要具备幂等性;一旦与重试或恢复结合,同一任务可能再次执行。状态聚合字段也要选择符合业务语义的 reducer:列表拼接适合收集结果,数值求和适合计数,覆盖式字段则不应由多个并行任务同时写入。