
AI Agent / 系统课时
把独立流程封装为子图
把独立流程封装为子图
当一个 LangGraph 工作流开始包含清洗、审核、检索或专用智能体等独立流程时,把所有节点继续堆在父图里会让测试和复用变得困难。本篇把一段可独立运行的流程编译成子图,并直接作为父图节点组合,得到清晰的边界与可单测入口。
学习目标
- 将一组内部节点编译为可独立调用的子图
- 在父图与子图共享状态键时,直接把编译后的子图注册为节点
- 判断何时需要包装节点做状态转换,以及持久化应放在哪一层
先确定子图的边界
适合做子图的流程通常同时满足两个条件:内部有自己的多步逻辑,外部只需要关心明确的输入与输出。例如“文本规范化”内部可以先去空白、再统一大小写,但父图只需要提供 text,并接收处理后的 text 与状态。
子图不是把函数换个名字。它仍然是一个编译后的 LangGraph,内部节点、边和执行边界都保留,因此可以独立 invoke() 做测试,也可以被父图当成一个节点组合。如果父图与子图共享同名状态键,最简单的方式就是把编译后的子图直接传给 add_node()。
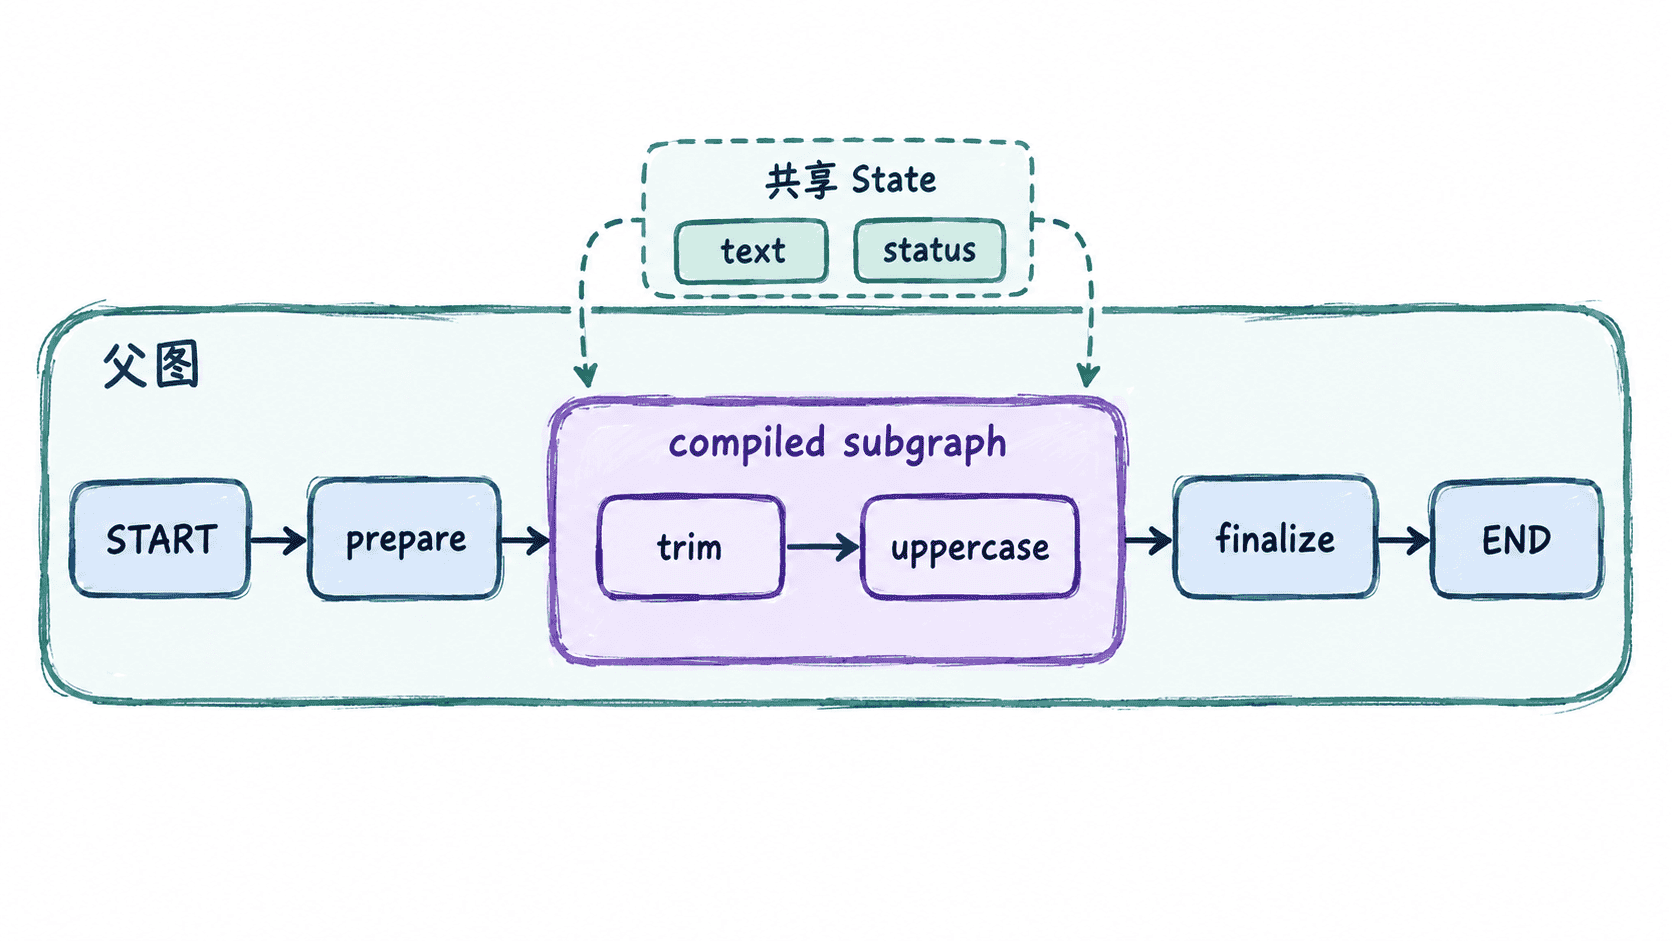
编译子图并接入父图
下面示例先单独编译 child_graph,再把它作为父图的 child 节点。父子图使用同一个 State,所以不需要手写输入输出转换;同时先调用一次子图本身,证明这段流程可以脱离父图独立测试。
from typing_extensions import TypedDict

from langgraph.graph import END, START, StateGraph


class State(TypedDict):
    text: str
    status: str


def trim_text(state: State):
    return {"text": state["text"].strip()}


def uppercase_text(state: State):
    return {
        "text": state["text"].upper(),
        "status": "child_done",
    }


child_builder = StateGraph(State)
child_builder.add_node("trim", trim_text)
child_builder.add_node("uppercase", uppercase_text)
child_builder.add_edge(START, "trim")
child_builder.add_edge("trim", "uppercase")
child_builder.add_edge("uppercase", END)
child_graph = child_builder.compile()


def prepare(state: State):
    return {"status": "parent_prepared"}


def finalize(state: State):
    return {"status": state["status"] + "->parent_done"}


parent_builder = StateGraph(State)
parent_builder.add_node("prepare", prepare)
parent_builder.add_node("child", child_graph)
parent_builder.add_node("finalize", finalize)
parent_builder.add_edge(START, "prepare")
parent_builder.add_edge("prepare", "child")
parent_builder.add_edge("child", "finalize")
parent_builder.add_edge("finalize", END)
parent_graph = parent_builder.compile()

child_result = child_graph.invoke(
    {"text": "  hello langgraph  ", "status": "new"}
)
print("child:", child_result["text"], child_result["status"])

parent_result = parent_graph.invoke(
    {"text": "  hello langgraph  ", "status": "new"}
)
print("parent:", parent_result["text"], parent_result["status"])
预期输出
child: HELLO LANGGRAPH child_done
parent: HELLO LANGGRAPH child_done->parent_done
这个结果同时验证了两件事:子图可以作为独立可运行单元测试,接入父图后又能像普通节点一样读取和更新共享状态。父图不需要知道 trim 与 uppercase 的内部细节。
状态不一致时不要硬接
直接把子图传给 add_node() 的前提,是父子图能通过共享状态键自然通信。如果父图使用 query,而子图只认识 question 与 answer,应在父图里增加一个包装节点:先把父状态转换成子图输入,调用子图,再把结果映射回父状态。这样能显式维护边界,而不是为了复用而强迫两个图采用同一套状态结构。
| 场景 | 推荐组合方式 |
|---|---|
| 父子图共享需要读写的状态键 | 将编译后的子图直接作为父图节点 |
| 父子图状态结构不同 | 用包装节点转换输入与输出 |
| 子图需要中断、状态检查或恢复 | 在父图启用 checkpointer,并让子图使用继承的持久化能力 |
为可恢复流程准备持久化
纯计算子图可以像上例一样不配置 checkpointer。若子图内部需要 interrupt()、状态检查或可恢复执行,通常在编译父图时提供 checkpointer;默认情况下,子图可以继承父图的持久化能力。这样顶层线程仍由同一个 thread_id 驱动,不必给每个子图手工维护另一套恢复入口。
如果某个子图需要跨多次调用保留独立会话状态,再考虑子图自己的持久化模式;否则优先保持默认的调用级隔离,能减少命名空间冲突。把流程先封装成职责清晰、可独立验证的编译子图,再决定持久化粒度,父图就能专注编排而不是吸收所有内部实现。