
AI Agent / 系统课时
部署图服务并演练故障恢复
部署图服务并演练故障恢复
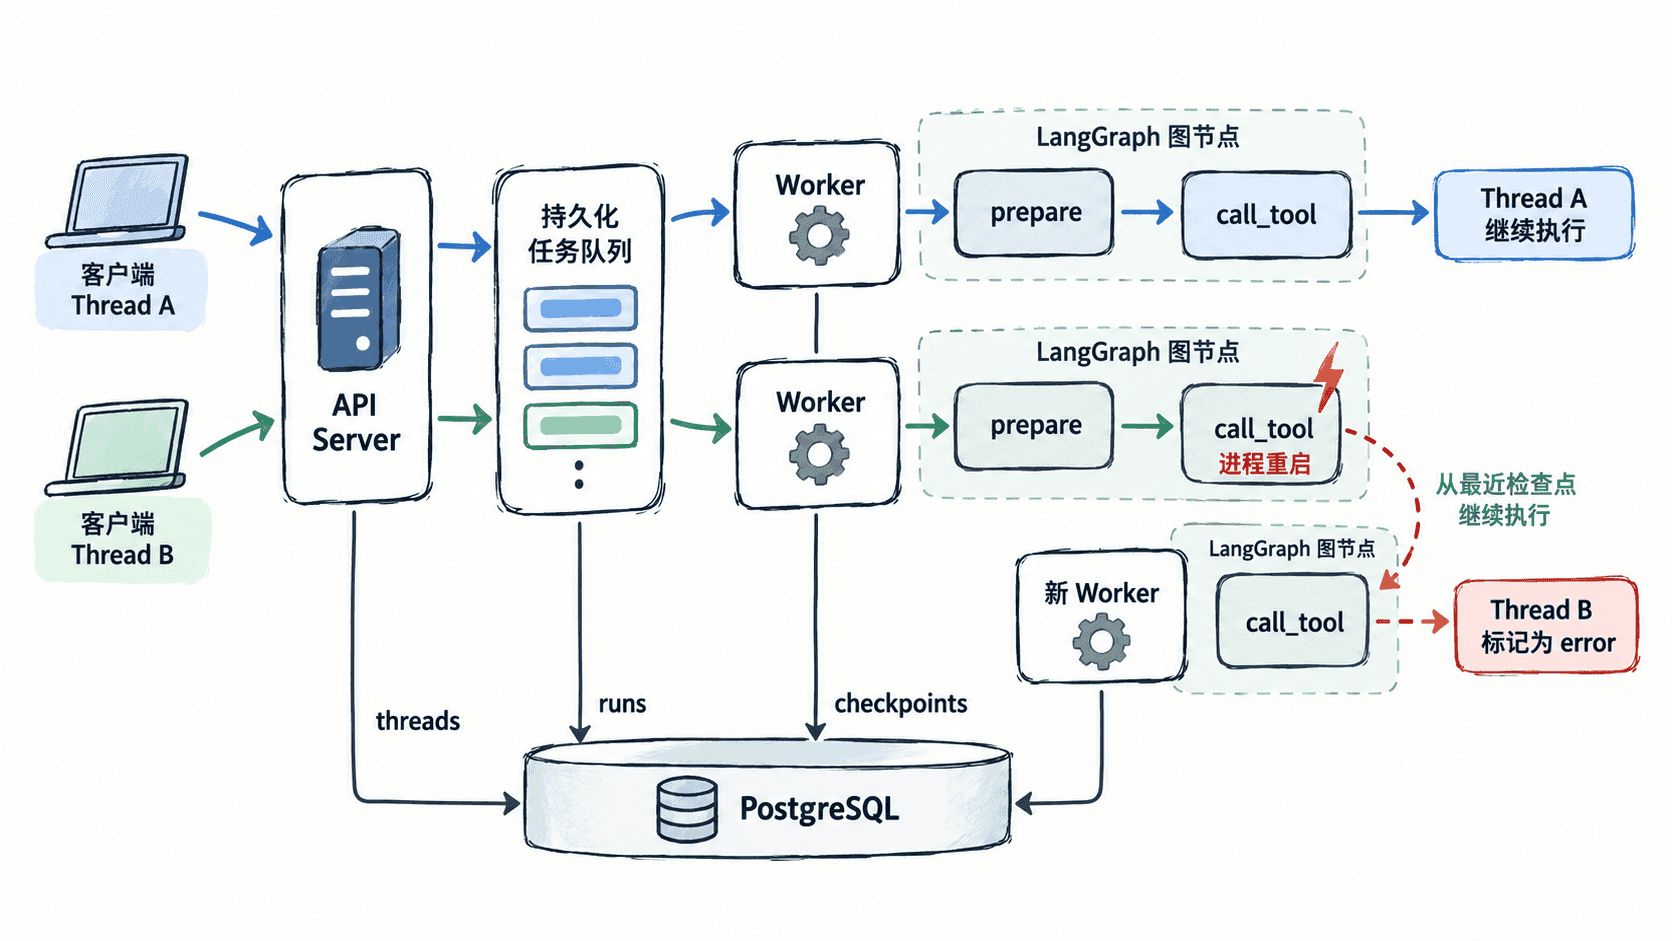
本节把已经完成的 LangGraph 图放进 Agent Server,并用真实请求验证三件事:不同线程能并发且状态互不污染、工具异常只影响当前运行、服务进程被重启后仍能从持久化检查点继续完成任务。
学习目标
- 用
langgraph up启动可调用的 Agent Server,并通过健康检查确认服务与数据库可用。 - 用两个独立 thread 并发执行 run,验证状态隔离和单次工具故障的影响边界。
- 在节点执行中重启服务进程,验证 durable queue 与 checkpoint 驱动的恢复行为。
准备可部署的恢复演练图
Agent Server 会为部署图管理 thread、run、任务队列和检查点,因此部署到服务时不要再给 graph.compile() 手工绑定内存型 checkpointer。演练图只保留两个节点:prepare 先提交一个可持久化状态,call_tool 再执行一个可延迟、可故障的模拟工具。
下面三段都是片段示例,分别保存为项目根目录的 requirements.txt、langgraph.json 和 recovery_graph.py;它们由 Agent Server 在部署上下文中加载,不作为独立程序执行。
langgraph{
"$schema": "https://langgra.ph/schema.json",
"dependencies": ["."],
"graphs": {
"recovery_demo": "./recovery_graph.py:graph"
},
"env": ".env"
}import time
from typing import TypedDict
from langgraph.graph import END, START, StateGraph
class DemoState(TypedDict, total=False):
request_id: str
fail_tool: bool
delay_seconds: float
prepared: bool
result: str
def prepare(state: DemoState) -> DemoState:
# 先提交一个稳定边界,进程故障后可从这里继续。
return {"prepared": True}
def call_tool(state: DemoState) -> DemoState:
# 延迟窗口用于人工重启容器;真实工具应设置自己的超时。
time.sleep(float(state.get("delay_seconds", 1)))
if state.get("fail_tool", False):
raise RuntimeError(f"simulated tool failure: {state['request_id']}")
# request_id 在真实系统中应继续传给外部工具作为幂等键。
return {"result": f"ok:{state['request_id']}"}
builder = StateGraph(DemoState)
builder.add_node("prepare", prepare)
builder.add_node("call_tool", call_tool)
builder.add_edge(START, "prepare")
builder.add_edge("prepare", "call_tool")
builder.add_edge("call_tool", END)
graph = builder.compile()langgraph.json 把图注册为 recovery_demo。服务加载成功后,持久化由 Agent Server 接管;后面的请求会显式使用 durability="sync",让检查点在进入下一步前完成持久化,更适合做故障演练。
启动 Agent Server 并做健康检查
本地生产化演练使用 Docker 模式。.env 至少提供当前部署方式要求的凭据,例如 LANGSMITH_API_KEY=<API_KEY>;不要把真实密钥写进仓库。下面命令在项目根目录执行,端口固定为 8123。
python -m pip install -U langgraph-cli langgraph-sdk
docker info >/dev/null && echo "docker=ok"
langgraph up --port 8123 --wait
curl -s "http://127.0.0.1:8123/ok?check_db=1"
预期输出以最后两个观察点为准,CLI 构建日志会随版本和镜像缓存变化:
docker=ok
{"ok":true}
/ok?check_db=1 同时检查服务和数据库连通性。这里的 langgraph up 用于本机 Docker 演练;真正上线时还要按所选托管或自托管模式补齐认证、数据库备份、网络策略、监控和多副本配置。
用并发请求验证线程隔离
不要只压同一个 thread。一个 thread 表示一条连续状态链,同一 thread 的并发 run 需要明确的 multitask 策略;验证服务隔离时,应先让两个独立 thread 同时执行,再故意让其中一个工具报错。
将下面程序保存为 concurrency_check.py。它在两个 thread 中并发创建 run:req-a 正常完成,req-b 在 call_tool 抛出异常。程序最终读取 run 状态,而不是依赖异常文本,因此结果不受 SDK 错误包装方式影响。
import asyncio

from langgraph_sdk import get_client

URL = "http://127.0.0.1:8123"
GRAPH = "recovery_demo"

async def invoke(label: str, fail: bool) -> tuple[str, str, str]:
    client = get_client(url=URL)
    thread = await client.threads.create()

    # 后台 run 先进入持久化队列,再等待它结束。
    run = await client.runs.create(
        thread["thread_id"],
        GRAPH,
        input={
            "request_id": label,
            "fail_tool": fail,
            "delay_seconds": 2,
        },
        durability="sync",
    )
    try:
        await client.runs.join(thread["thread_id"], run["run_id"])
    except Exception:
        pass

    final_run = await client.runs.get(thread["thread_id"], run["run_id"])
    value = "-"
    if final_run["status"] == "success":
        state = await client.threads.get_state(thread["thread_id"])
        value = state["values"]["result"]

    return label, final_run["status"], value

async def main() -> None:
    results = await asyncio.gather(
        invoke("req-a", False),
        invoke("req-b", True),
    )
    for row in results:
        print(*row)

if __name__ == "__main__":
    asyncio.run(main())
运行:
python concurrency_check.py预期输出:
req-a success ok:req-a
req-b error -
这个结果说明故障隔离边界在 thread/run,而不是整个服务进程。req-b 的工具异常不会回滚 req-a 的状态,也不会让 Agent Server 整体不可用。真实工具若调用支付、发信、写数据库等外部副作用,还应把稳定的 request_id 传给下游做幂等去重。
重启进程验证检查点恢复
工具异常属于应用失败,通常应该先修复输入、依赖或重试策略;进程被杀则属于运行时失败,目标是由持久化队列和 checkpoint 接管。下面先启动一个 30 秒的慢 run,并等到 prepare 状态已经可见后再提示重启。
把程序保存为 start_recovery_case.py:
import asyncio
import json

from langgraph_sdk import get_client

URL = "http://127.0.0.1:8123"
GRAPH = "recovery_demo"

async def main() -> None:
    client = get_client(url=URL)
    thread = await client.threads.create()
    run = await client.runs.create(
        thread["thread_id"],
        GRAPH,
        input={
            "request_id": "restart-case",
            "fail_tool": False,
            "delay_seconds": 30,
        },
        durability="sync",
    )

    # 等 prepare 检查点可见,再进入人工重启窗口。
    while True:
        state = await client.threads.get_state(thread["thread_id"])
        if state.get("values", {}).get("prepared"):
            break
        await asyncio.sleep(0.1)

    ids = {"thread_id": thread["thread_id"], "run_id": run["run_id"]}
    with open("recovery_case.json", "w", encoding="utf-8") as file:
        json.dump(ids, file)
    print("READY_TO_RESTART")
    print("THREAD_ID=<ID>")
    print("RUN_ID=<ID>")

if __name__ == "__main__":
    asyncio.run(main())
运行:
python start_recovery_case.py预期输出中的真实 ID 每次都会不同:
READY_TO_RESTART
THREAD_ID=<ID>
RUN_ID=<ID>
看到 READY_TO_RESTART 后,在 30 秒窗口内重启监听 8123 的 Agent Server 容器,并再次做数据库健康检查:
CONTAINER_ID="$(docker ps --filter "publish=8123" --format '{{.ID}}' | head -n 1)"
test -n "$CONTAINER_ID"
docker restart "$CONTAINER_ID" >/dev/null
until curl -fsS "http://127.0.0.1:8123/ok?check_db=1"; do sleep 1; done
预期结果:
{"ok":true}最后读取刚才保存的 thread/run 标识,等待原 run 结束并检查最终状态:
python - <<'PY'
import asyncio
import json

from langgraph_sdk import get_client

async def main() -> None:
    with open("recovery_case.json", encoding="utf-8") as file:
        ids = json.load(file)

    client = get_client(url="http://127.0.0.1:8123")
    await client.runs.join(ids["thread_id"], ids["run_id"])
    run = await client.runs.get(ids["thread_id"], ids["run_id"])
    state = await client.threads.get_state(ids["thread_id"])

    print(run["status"])
    print(state["values"]["result"])

asyncio.run(main())
PY
预期输出:
success
ok:restart-case
如果健康检查恢复但 run 最终仍是 error,先看失败节点是不是业务异常,再检查数据库是否真正持久化、容器是否连接到同一套存储,以及运行是否使用了足够强的 durability。恢复只保证从最近已持久化边界继续,不保证正在执行的外部副作用只发生一次;生产工具仍必须设计超时、重试上限和幂等键。