
AI Agent / 系统课时
用 Store 保存跨线程记忆
用 Store 保存跨线程记忆
同一个用户往往会打开多个会话线程,但“偏好深色主题”“常用语言是中文”这类长期事实不应被锁在某个 thread_id 里。本节把稳定用户身份映射到 Store 命名空间,并验证两个不同线程可以读到同一份记忆,而其他用户仍保持隔离。
学习目标
- 区分线程检查点与跨线程 Store 的职责边界
- 用稳定命名空间和 key 写入用户长期记忆
- 在不同
thread_id中读取同一用户记忆并验证用户隔离
线程状态和长期记忆不是一回事
Checkpointer 负责保存某个线程的图状态,适合多轮会话、恢复和时间旅行;Store 保存应用自定义数据,不依附于单个线程,适合用户偏好、长期事实和跨会话资料。LangGraph 官方文档明确把这两种持久化能力分开:线程状态由 checkpointer 管理,跨线程数据由 Store 管理。([Docs by LangChain][1])
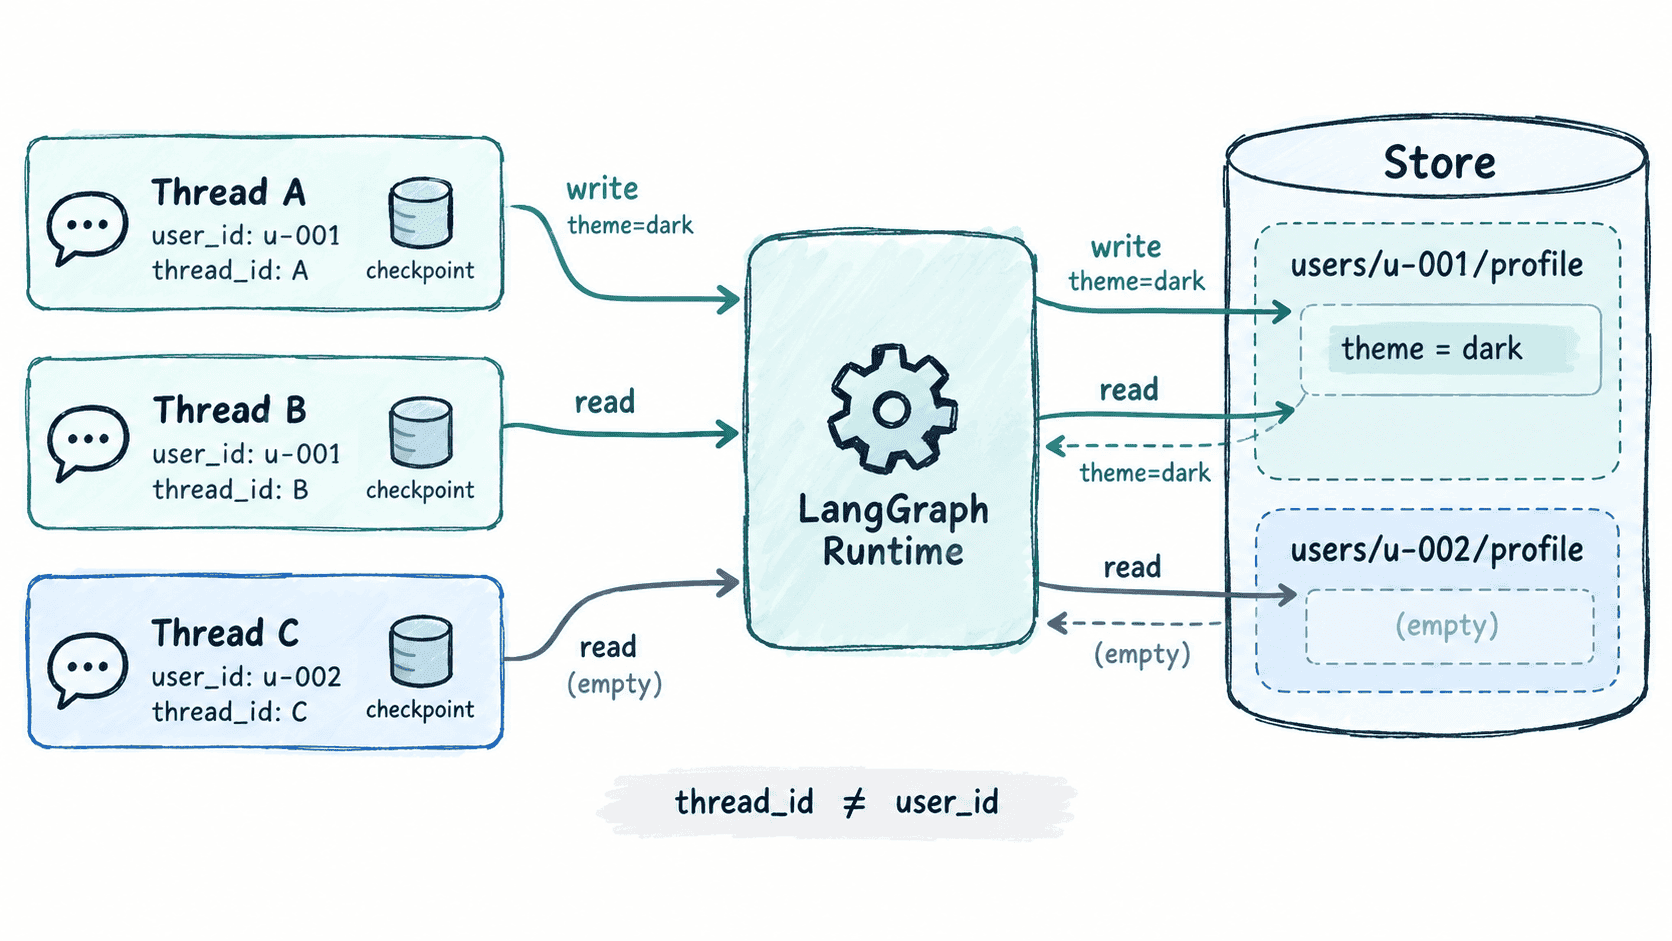
如果把 thread_id 放进长期记忆的命名空间,每开一个新会话都会得到新的存储位置,跨线程记忆自然无法共享。更常见的设计是用受信任的 user_id、组织 ID 或业务主体作为命名空间的一部分。
写入一次,在另一个线程读取
下面的图只有一个节点,但同时配置了 InMemorySaver 和 InMemoryStore。前者让每个线程拥有独立检查点,后者让同一用户在不同线程共享长期数据。
from dataclasses import dataclass
from typing_extensions import NotRequired, TypedDict

from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import END, START, StateGraph
from langgraph.runtime import Runtime
from langgraph.store.memory import InMemoryStore

class State(TypedDict):
    action: str
    value: str
    output: NotRequired[str]

@dataclass
class Context:
    user_id: str

def memory_node(state: State, runtime: Runtime[Context]) -> dict:
    assert runtime.store is not None
    namespace = ("users", runtime.context.user_id, "profile")
    if state["action"] == "save":
        runtime.store.put(
            namespace,
            "preferences",
            {"theme": state["value"]},
        )
        return {"output": f"saved:{state['value']}"}
    item = runtime.store.get(namespace, "preferences")
    theme = item.value["theme"] if item else "<none>"
    return {"output": f"theme:{theme}"}

store = InMemoryStore()
builder = StateGraph(State, context_schema=Context)
builder.add_node("memory", memory_node)
builder.add_edge(START, "memory")
builder.add_edge("memory", END)
graph = builder.compile(
    checkpointer=InMemorySaver(),
    store=store,
)

user_1 = Context(user_id="u-001")
user_2 = Context(user_id="u-002")

saved = graph.invoke(
    {"action": "save", "value": "dark"},
    {"configurable": {"thread_id": "thread-a"}},
    context=user_1,
)
same_user = graph.invoke(
    {"action": "read", "value": ""},
    {"configurable": {"thread_id": "thread-b"}},
    context=user_1,
)
other_user = graph.invoke(
    {"action": "read", "value": ""},
    {"configurable": {"thread_id": "thread-c"}},
    context=user_2,
)

print(saved["output"])
print(same_user["output"])
print(other_user["output"])
预期输出
saved:dark
theme:dark
theme:<none>
thread-a 与 thread-b 完全不同,但两次调用都携带 user_id="u-001",所以它们定位到同一个 ("users", "u-001", "profile") 命名空间。thread-c 使用 u-002,因此读取不到前一个用户的数据。
设计命名空间和 key
命名空间适合表达“谁的数据、属于哪个领域”,例如 ("users", user_id, "profile");key 适合标识命名空间内的一条稳定记录,例如 preferences。如果同一事实需要被新值覆盖,复用固定 key 最简单;如果要保存多条独立经历,再为每条记忆使用不同 key。
已知精确 key 时用 get 最直接;需要在一组长期记忆中按内容寻找相关项时,可以为 Store 配置索引后使用 search。无论采用哪种方式,都不要让模型自己决定可信的用户身份,user_id 应来自登录态、鉴权结果或后端上下文。
从演示 Store 迁移到生产
跨线程记忆能否可靠工作,关键不在于会话是否使用同一个 thread_id,而在于不同会话是否能稳定解析到同一个业务命名空间。把线程状态与长期记忆分开后,恢复执行、短期上下文和用户长期事实就不会互相混淆。