
AI Agent / 系统课时
设计记忆隔离与清理策略
设计记忆隔离与清理策略
长期记忆一旦跨用户、租户或业务空间混写,就会从“更聪明”变成越权和污染风险。本节用可落地的命名空间、写入边界和过期策略,把 LangGraph Store 中的记忆限制在明确所有者与生命周期内。
学习目标
- 用租户、业务空间和用户维度设计稳定的记忆命名空间
- 区分可长期保存、应短期保存与禁止写入的内容
- 实现带过期时间的读写与主动清理,并验证隔离是否生效
先把记忆边界设计清楚
记忆隔离的核心不是“多加几个前缀”,而是让每条记忆都能回答三个问题:谁拥有它、在哪个业务空间生效、保存多久。在多租户系统中,租户必须放在最外层;同一租户内再按业务空间和用户细分,避免客服、销售或不同项目共享本不该共享的上下文。
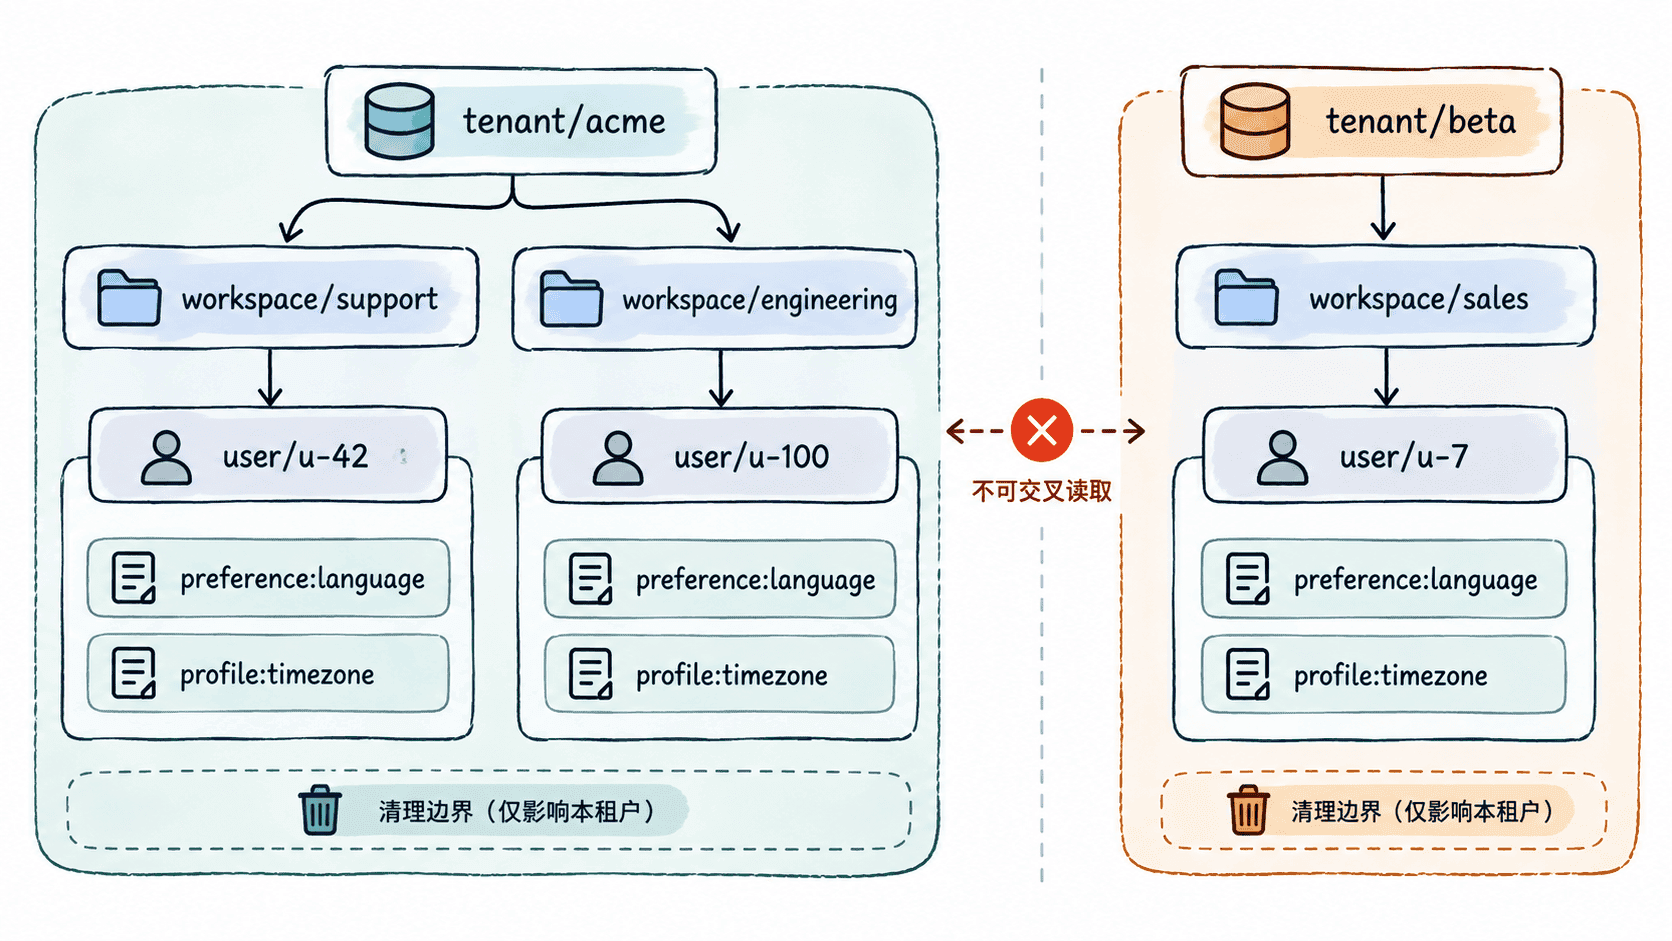
一个实用的命名空间可以写成 ("tenant", tenant_id, "workspace", workspace_id, "user", user_id)。命名空间表达“归属”,键表达“这是什么记忆”,例如 preference:language。不要把用户 ID、租户 ID 只塞进 value 后再依赖过滤条件,因为一旦过滤遗漏,就可能发生跨边界读取。
设计键和值的最小契约
建议把键保持稳定、可预测,把会变化的属性放进 value。除了业务值,至少保留过期时间和敏感级别,这样读取路径和清理任务都能做统一判断。
| 字段 | 作用 | 示例 |
|---|---|---|
| namespace | 决定所有权和可见范围 | tenant/acme/workspace/support/user/u-42 |
| key | 标识一类具体记忆 | preference:language |
| value | 保存业务值与治理元数据 | value、expires_at、sensitivity |
命名空间不要包含邮箱、手机号等直接敏感信息;它们既容易泄露到日志,也会让重命名和删除变得困难。稳定的内部 ID 更适合做隔离键。
控制写入范围与敏感数据
并非所有对话内容都值得进入长期记忆。用户明确表达且后续确有复用价值的偏好,可以写入;一次性任务参数、短期审批上下文更适合保留在线程状态中;密码、访问令牌、完整证件号等秘密不应写入长期记忆。
写入函数还应由服务端根据已认证身份构造 namespace,而不是接受模型或前端直接提交完整命名空间。这样即使模型生成了错误的租户 ID,也不会突破当前请求的授权边界。
实现过期读取与主动删除
下面示例使用 InMemoryStore 演示同一命名空间内的写入、过期判断和删除。生产环境可以换成持久化 Store,但“读前检查过期、过期后删除”的治理逻辑保持一致。
from datetime import datetime
from langgraph.store.memory import InMemoryStore

def get_live_memory(store, namespace, key, now):
    item = store.get(namespace, key)
    if item is None:
        return None

    expires_at = datetime.fromisoformat(item.value["expires_at"])
    if expires_at <= now:
        store.delete(namespace, key)
        return None

    return item.value["value"]

store = InMemoryStore()
namespace = ("tenant", "acme", "workspace", "support", "user", "u-42")
key = "preference:language"

store.put(
    namespace,
    key,
    {
        "value": "zh-CN",
        "expires_at": "2026-09-13T02:00:00+00:00",
        "sensitivity": "low",
    },
)

print(get_live_memory(
    store, namespace, key,
    datetime.fromisoformat("2026-09-13T01:30:00+00:00"),
))
print(get_live_memory(
    store, namespace, key,
    datetime.fromisoformat("2026-09-13T02:30:00+00:00"),
))
预期输出:
zh-CN
None
第二次读取发现已过期,因此同时执行删除。真实系统通常还要增加后台清理任务,避免“从未再次读取”的过期记录永久占用存储。
用生命周期而不是一个统一 TTL
清理策略应按记忆类型分层,而不是全系统一个 TTL。短期偏好可以按天或周过期;明确由用户维护的长期资料可以保留更久,但要支持用户主动删除;高敏感信息应尽量不进入长期 Store。
删除也要覆盖“主体级”场景:用户注销时清理该用户命名空间,业务空间关闭时清理整个 workspace 范围,租户终止服务时执行租户级擦除。这样记忆的生命周期才与真实业务对象一致,而不是只依赖单条记录自然过期。
最终可以把策略收敛成一句工程规则:身份边界决定 namespace,业务语义决定 key,数据分类决定是否写入,生命周期决定何时删除。只要这四层都由服务端强制执行,记忆就不会依赖模型“自觉”保持隔离。