
AI Agent / 系统课时
设计父子图的状态边界
设计父子图的状态边界
父子图拆分真正要控制的不是节点数量,而是哪些状态可以跨边界传播。本篇用显式输入输出映射隔离子图内部草稿,只让父图保留任务输入与最终结果,从而降低字段冲突、持久化膨胀和后续重构成本。
学习目标
- 区分父图共享字段、跨图接口字段与子图私有字段
- 使用包装节点完成父状态到子状态、子输出到父状态的双向映射
- 判断什么时候可以直接把子图作为节点,什么时候必须建立适配层
先把状态分成三类
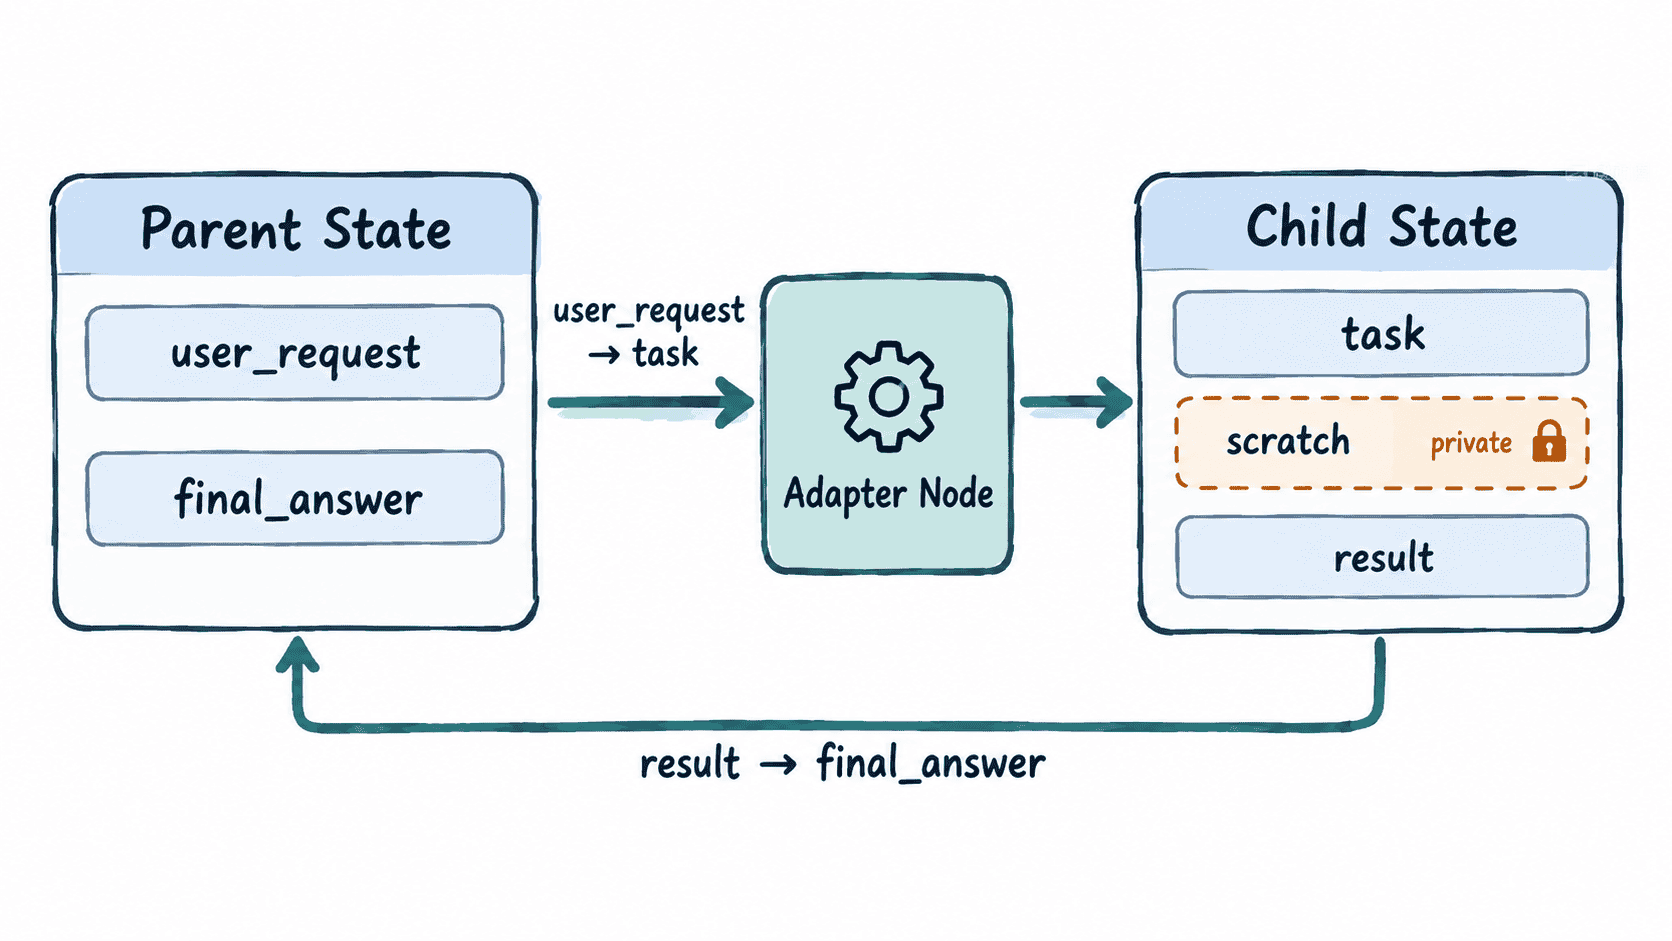
父图状态应该承载跨工作流仍有意义的信息,例如用户请求、路由结果、最终答案和需要统一持久化的业务上下文。子图内部的推理草稿、临时查询结果、局部计数器或专属消息历史,不应因为“调用方便”就被提升到父图。
跨边界字段则是父子图之间的接口。它们可以与父图字段同名,也可以通过包装节点改名和转换。判断标准很简单:父图后续节点是否真的需要这个值。如果答案是否定的,就优先把它留在子图内部。
选择直接共享还是显式映射
如果父图和子图本来就共享同一批状态键,可以把编译后的子图直接传给 add_node。子图会读取和更新同名 channel,适合共同维护 messages、统一任务状态等场景。
如果两边 schema 不同,或者你想刻意隐藏子图内部字段,就在父图节点中调用 subgraph.invoke()。这个包装节点承担协议转换:只构造子图真正需要的输入,并只把允许公开的结果写回父状态。这样子图可以自由增加内部字段,而父图接口保持稳定。
用包装节点隔离子图私有状态
下面的可运行示例让父图只认识 user_request 和 final_answer,而子图独立维护 task、scratch 和 result。scratch 在子图完成后不会进入父图状态。
from typing import TypedDict

from langgraph.graph import END, START, StateGraph

class ParentState(TypedDict, total=False):
    user_request: str
    final_answer: str

class ChildState(TypedDict, total=False):
    task: str
    scratch: str
    result: str

def make_plan(state: ChildState):
    # scratch 只服务于子图内部步骤,不暴露给父图。
    return {"scratch": f"plan({state['task']})"}

def solve(state: ChildState):
    return {"result": f"{state['scratch']} => {state['task'].upper()}"}

child_builder = StateGraph(ChildState)
child_builder.add_node("plan", make_plan)
child_builder.add_node("solve", solve)
child_builder.add_edge(START, "plan")
child_builder.add_edge("plan", "solve")
child_builder.add_edge("solve", END)
child_graph = child_builder.compile()

def call_child(state: ParentState):
    # 输入映射:父图只把任务字段交给子图。
    child_output = child_graph.invoke({"task": state["user_request"]})
    # 输出映射:只公开 result,不回传 scratch。
    return {"final_answer": child_output["result"]}

parent_builder = StateGraph(ParentState)
parent_builder.add_node("delegate", call_child)
parent_builder.add_edge(START, "delegate")
parent_builder.add_edge("delegate", END)
parent_graph = parent_builder.compile()

result = parent_graph.invoke({"user_request": "refund order 42"})
print(result["final_answer"])
print(sorted(result.keys()))
预期输出
plan(refund order 42) => REFUND ORDER 42
['final_answer', 'user_request']
第二行验证了边界:父图最终状态里没有 scratch、task 或 result。以后即使子图新增检索缓存、局部消息列表或更多中间步骤,只要适配层的输入输出契约不变,父图就不需要跟着修改。
把共享字段当成正式接口
直接共享字段并不是错误,但要把它当成跨模块 API 来管理。同名字段必须有一致含义;如果字段配置了 reducer,父子图对它的更新语义也必须一致;多个子图都会写同一字段时,还要明确覆盖、追加还是聚合规则。
状态边界设计得好,父图看到的是稳定的业务契约,子图拥有自己的实现空间。优先共享真正需要协作的字段,其余状态通过输入输出映射隔离,复杂智能体才不会随着子图增多变成一份所有节点都能读写的全局状态。