
AI Agent / 系统课时
并行执行并汇总多个子任务
并行执行并汇总多个子任务
当一个请求能拆成互不依赖的检索、校验或分析任务时,LangGraph 可以把它们同时分发给多个节点,再在统一的汇总节点收集结构化结果。关键不是“多连几条边”,而是同时设计好扇出方式、并发写入的 reducer 与稳定的归并顺序。
学习目标
- 使用
Send按运行时任务列表动态创建并行分支 - 为并行节点写入的共享字段配置 reducer,避免并发更新冲突
- 在汇总节点按业务顺序整理结构化结果,而不依赖分支完成顺序
把并行工作拆成扇出与归并
并行工作流通常分为三段:先得到待处理任务列表,再把每个任务扇出到独立 Worker,最后让汇总节点在所有 Worker 完成本轮执行后统一读取结果。只有互不依赖的工作才适合放在同一并行层;存在前置依赖的任务应继续使用串行边。
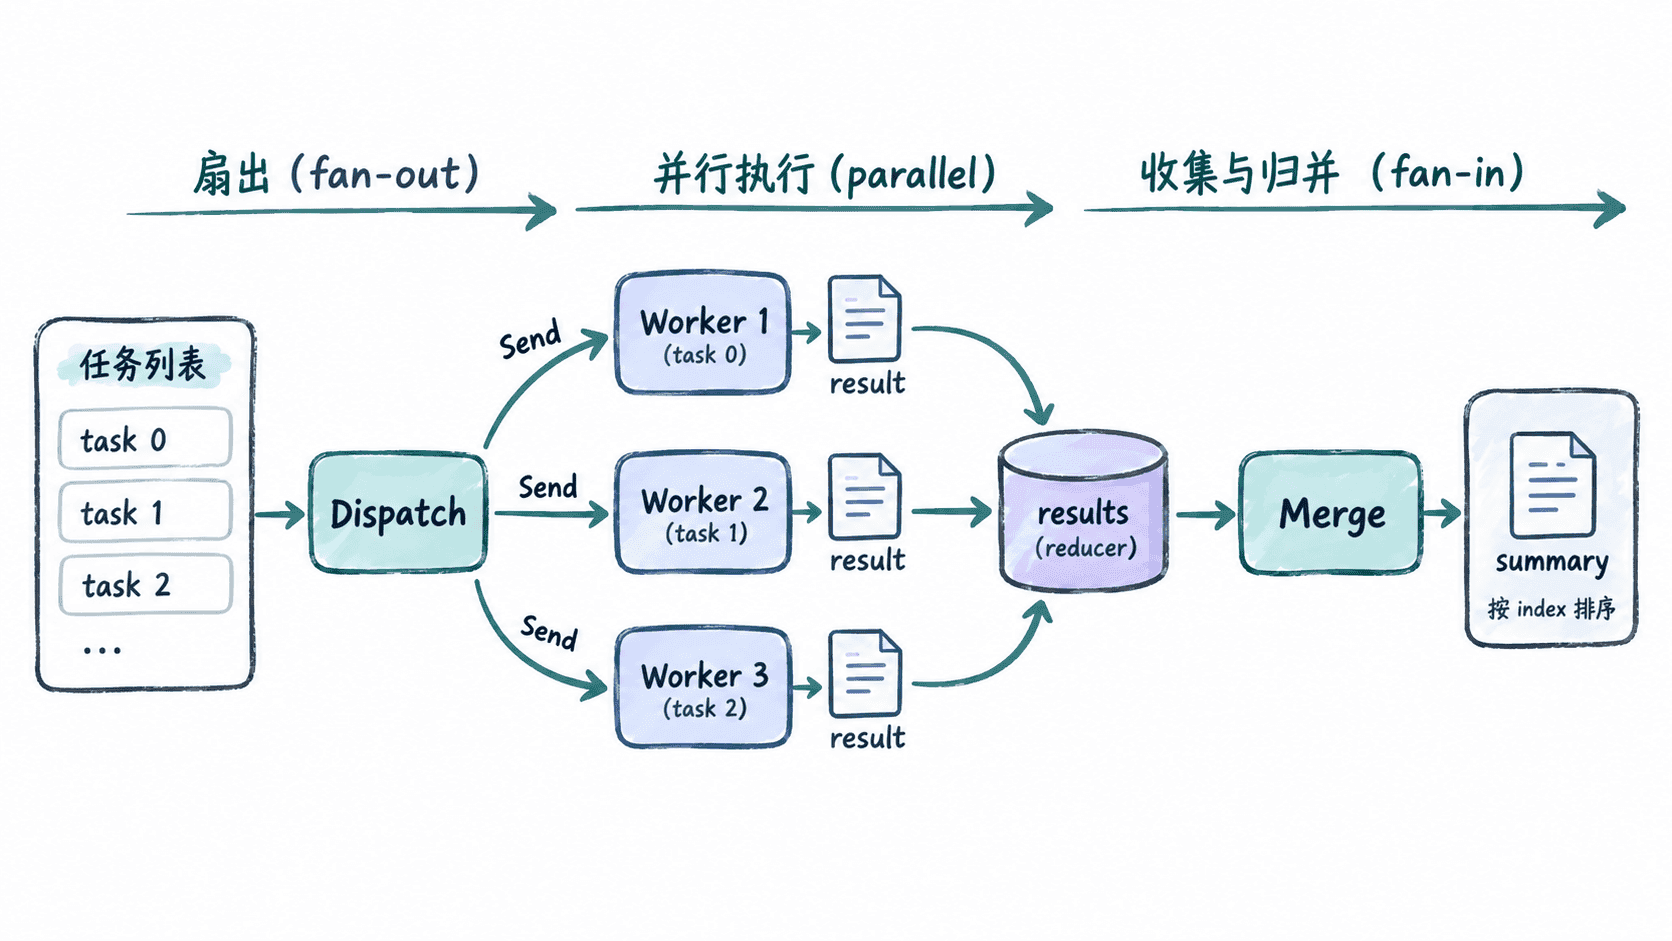
同一并行层里的多个节点可能以不同顺序完成,因此“谁先返回”不应成为业务顺序。要稳定输出,可以在每个子任务中携带 index 或业务主键,汇总时再显式排序。
用 Send 动态分发子任务
下面的示例不依赖模型服务。输入有多少个任务,dispatch 就创建多少个 Send,所有 Worker 都把结果写入同一个 results 字段。
from operator import add
from typing import Annotated
from langgraph.graph import END, START, StateGraph
from langgraph.types import Send
from typing_extensions import TypedDict

class Task(TypedDict):
    index: int
    text: str

class WorkerResult(TypedDict):
    index: int
    output: str

class OverallState(TypedDict):
    tasks: list[Task]
    results: Annotated[list[WorkerResult], add]
    summary: str

class WorkerState(TypedDict):
    task: Task

def dispatch(state: OverallState):
    # 每个 Send 都给同一个 Worker 一份独立输入。
    return [Send("worker", {"task": task}) for task in state["tasks"]]

def worker(state: WorkerState):
    task = state["task"]
    return {
        "results": [
            {"index": task["index"], "output": f"完成:{task['text']}"}
        ]
    }

def merge(state: OverallState):
    # 并行完成顺序不稳定,因此按显式 index 恢复业务顺序。
    ordered = sorted(state["results"], key=lambda item: item["index"])
    summary = "\n".join(
        f"{item['index']}. {item['output']}" for item in ordered
    )
    return {"summary": summary}

builder = StateGraph(OverallState)
builder.add_node("worker", worker)
builder.add_node("merge", merge)
builder.add_conditional_edges(START, dispatch, ["worker"])
builder.add_edge("worker", "merge")
builder.add_edge("merge", END)
graph = builder.compile()

result = graph.invoke(
    {
        "tasks": [
            {"index": 1, "text": "检索文档"},
            {"index": 2, "text": "提取指标"},
            {"index": 3, "text": "生成摘要"},
        ],
        "results": [],
        "summary": "",
    }
)

print(result["summary"])
预期输出
1. 完成:检索文档
2. 完成:提取指标
3. 完成:生成摘要
实际分支的完成先后可能不同,但最终文本仍按 index 排序,因此前端或下游系统不会因为并发调度差异得到随机顺序。
让 reducer 负责并发结果收集
results 使用 Annotated[list[WorkerResult], add],表示每个 Worker 返回的列表都要追加到已有结果,而不是覆盖旧值。并行节点如果同时写同一个没有 reducer 的状态键,LangGraph 无法判断该保留哪次更新,容易触发并发更新错误。
Reducer 只解决“怎样合并写入”,不解决“怎样解释结果”。因此 Worker 最好返回结构化字段,例如任务标识、状态、数据和错误信息;Merge 再负责排序、去重、筛选和最终格式化。这样即使 Worker 从普通函数替换成子智能体,归并协议也不需要重写。
判断任务是否值得并行
并行适合独立的检索源、多维度评分、批量文档处理和互不依赖的子智能体调用。若后一个任务必须读取前一个任务的结果,就不应强行扇出;若多个分支争用同一外部限流接口,也要在调用层控制并发量。
对需要恢复的工作流,还应让每个分支的副作用具备幂等性,并把可恢复的业务结果写入状态。这样并行带来的性能收益不会以重复写入、随机顺序或难以重放为代价。