
AI Agent / 系统课时
用 Postgres 持久化生产状态
用 Postgres 持久化生产状态
这一节把开发期的内存检查点替换为 PostgreSQL 持久化检查点,并用两个独立 Python 进程复用同一个 thread_id,验证前一进程退出后,后一进程仍能恢复线程状态并继续执行。
学习目标
- 使用
PostgresSaver为 LangGraph 配置持久化 Checkpointer。 - 正确初始化检查点表并用稳定
thread_id标识会话线程。 - 用跨进程实验验证状态来自 PostgreSQL,而不是来自进程内内存。
为什么生产状态不能只放内存
InMemorySaver 适合本地调试,但进程退出、容器重建或副本切换后,内存里的检查点会一起消失。生产环境需要把图状态写到独立持久层,让任意应用进程只要拿到相同的线程标识,就能读取已经提交的检查点并继续执行。
这里的 Checkpointer 保存的是“某个线程的图执行状态”,不是跨线程共享的长期用户画像。会话恢复依赖稳定的 thread_id;如果每次请求都生成新的线程标识,数据库正常也不会恢复到上一轮状态。
配置 PostgresSaver 并跨进程验证
下面的完整 Bash 示例需要 Docker 和 Python。它启动本地 PostgreSQL,创建一个带消息状态的 LangGraph,然后分别启动两个 Python 进程;第一个进程执行初始化并写入检查点,第二个进程只复用数据库和同一个 thread_id。
python -m pip install -q -U langgraph langgraph-checkpoint-postgres "psycopg[binary,pool]" >/dev/null

docker rm -f langgraph-postgres-demo >/dev/null 2>&1 || true
docker run --name langgraph-postgres-demo \
  -e POSTGRES_PASSWORD=postgres \
  -e POSTGRES_DB=langgraph \
  -p 55432:5432 \
  -d postgres:17 >/dev/null

until docker exec langgraph-postgres-demo \
  pg_isready -U postgres -d langgraph >/dev/null 2>&1; do
  sleep 1
done

export DATABASE_URL="postgresql://postgres:postgres@localhost:55432/langgraph?sslmode=disable"
export THREAD_ID="order-42"

cat > /tmp/langgraph_pg_demo.py <<'PY'
import argparse
import os

from langchain_core.messages import AIMessage
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.graph import END, START, MessagesState, StateGraph

parser = argparse.ArgumentParser()
parser.add_argument("--setup", action="store_true")
parser.add_argument("text")
args = parser.parse_args()

def echo(state: MessagesState):
    # 返回一条新消息;MessagesState 会把它追加到当前线程历史中。
    last = state["messages"][-1]
    return {"messages": [AIMessage(content=f"echo:{last.content}")]}

builder = StateGraph(MessagesState)
builder.add_node("echo", echo)
builder.add_edge(START, "echo")
builder.add_edge("echo", END)

config = {"configurable": {"thread_id": os.environ["THREAD_ID"]}}

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    if args.setup:
        # 仅在首次部署或需要执行检查点 schema 迁移时运行。
        checkpointer.setup()
    graph = builder.compile(checkpointer=checkpointer)
    result = graph.invoke({"messages": [("user", args.text)]}, config)

print(f"messages={len(result['messages'])}")
print("|".join(message.content for message in result["messages"]))
PY

python /tmp/langgraph_pg_demo.py --setup first
python /tmp/langgraph_pg_demo.py second
预期输出
messages=2
first|echo:first
messages=4
first|echo:first|second|echo:second
第二次命令启动的是新的 Python 进程,却仍能看到第一次的两条消息,这就是跨进程恢复的直接证据。把 THREAD_ID 改成另一个值再运行,消息数会重新从 2 开始,因为它会进入一条新的线程状态。
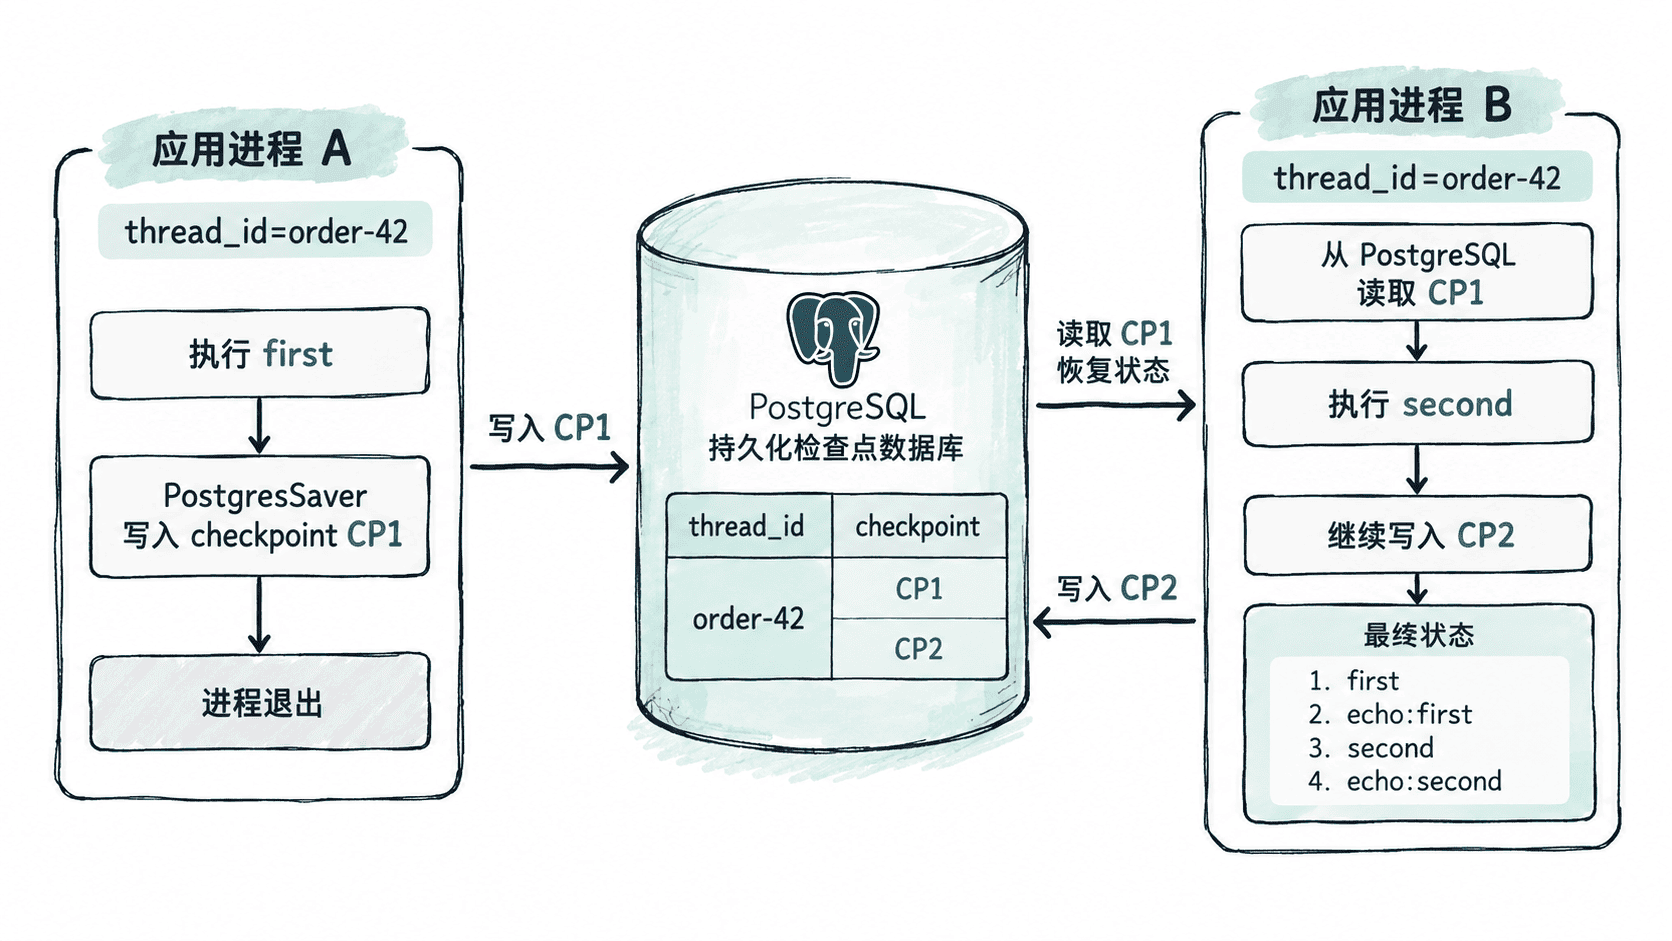
初始化、连接和线程标识的生产边界
checkpointer.setup() 会创建或升级检查点所需的数据库结构,不应该放在每个业务请求里反复执行。更稳妥的做法是在部署或迁移阶段单独运行初始化,再让应用实例使用已经准备好的表;运行时连接应来自密钥管理系统,并启用适合生产环境的 TLS、连接池和超时设置。
长时间运行的线程会持续产生检查点,因此还要设计保留策略、备份和容量监控。对于数据库被篡改后的反序列化风险,应限制允许恢复的类型或启用严格的序列化安全模式,而不是把检查点存储视为完全可信输入。
验收恢复而不是只验收写入
生产验收至少要覆盖三件事:应用进程重启后同一 thread_id 能继续执行;换一个 thread_id 不会串到旧状态;数据库不可用时请求能明确失败并被监控捕获。只有“写入成功”而没有“新进程读取并继续执行”的验证,还不能证明智能体具备可恢复性。
当进程生命周期与线程状态生命周期彻底解耦后,滚动发布、容器重建和多副本调度才不会天然丢失会话进度;PostgreSQL Checkpointer 的价值正是把恢复依据从某个进程的内存,转移到可持久、可备份、可治理的共享状态层。