
AI Agent / 系统课时
持久化线程并验证断点恢复
持久化线程并验证断点恢复
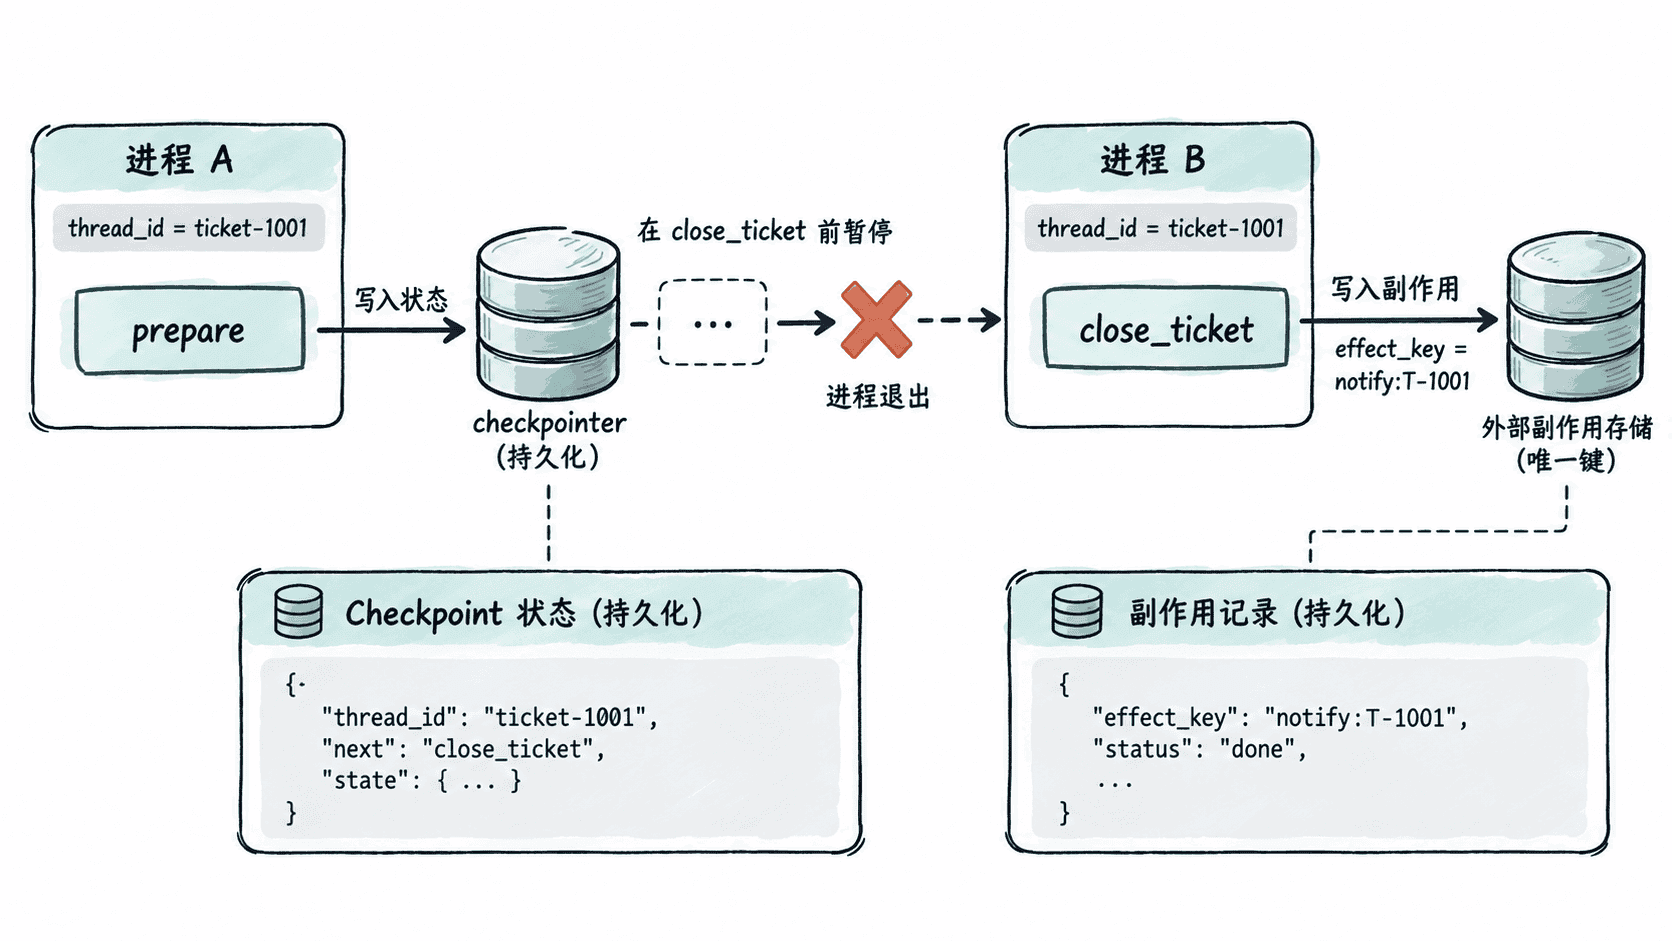
这一节把“能继续跑”变成可验证的工程能力:用持久化 checkpointer 保存工单线程,在进程退出后以同一个 thread_id 恢复,并同时检查图状态与外部副作用,避免只恢复了状态却重复执行通知、扣费等动作。
学习目标
- 为 LangGraph 工单图接入磁盘持久化 checkpointer,并理解
thread_id的恢复作用 - 模拟两个独立进程之间的断点续跑,验证恢复后的状态与下一节点
- 用幂等键约束外部副作用,识别 checkpoint 与 exactly-once 副作用之间的边界
可恢复线程必须同时满足三个条件
LangGraph 的 checkpoint 保存的是图执行状态和待执行位置。要让一个工单在进程重启后继续,至少要同时满足:checkpointer 本身跨进程持久化、恢复时继续使用原来的 thread_id、节点依赖的外部副作用能够安全重试。
thread_id 可以理解为一条工作流实例的稳定身份。新进程重新编译同一张图后,只要连接同一个 checkpoint 存储并传入相同的 thread_id,就能读取该线程最近一次已提交的状态。若改了 thread_id,系统会把它视为另一条独立线程。
构造可跨进程恢复的工单图
下面使用文件型 SQLite checkpointer 演示跨进程恢复。prepare 节点只更新图状态;close_ticket 模拟外部通知,并用唯一 effect_key 写入另一份 SQLite 表,从而把副作用是否重复变成可检查的数据。
首次演练应在没有 checkpoints.sqlite 和 effects.sqlite 的空目录中运行。需要预先安装 langgraph 与 langgraph-checkpoint-sqlite。下面脚本是完整可运行示例,保存为 ticket_graph.py。
from __future__ import annotations

import argparse
import sqlite3
from typing import NotRequired, TypedDict

from langgraph.checkpoint.sqlite import SqliteSaver
from langgraph.graph import END, START, StateGraph

CHECKPOINT_DB = "checkpoints.sqlite"
EFFECT_DB = "effects.sqlite"
THREAD_ID = "ticket-1001"

class TicketState(TypedDict):
    ticket_id: str
    status: NotRequired[str]
    side_effect_key: NotRequired[str]

def prepare(state: TicketState) -> dict:
    return {
        "status": "prepared",
        "side_effect_key": f"notify:{state['ticket_id']}",
    }

def write_effect_once(effect_key: str, payload: str) -> bool:
    # 外部副作用单独持久化,并用主键把重复执行压成一次写入。
    with sqlite3.connect(EFFECT_DB) as conn:
        conn.execute(
            "CREATE TABLE IF NOT EXISTS effects ("
            "effect_key TEXT PRIMARY KEY, payload TEXT NOT NULL)"
        )
        cursor = conn.execute(
            "INSERT OR IGNORE INTO effects(effect_key, payload) VALUES (?, ?)",
            (effect_key, payload),
        )
        return cursor.rowcount == 1

def close_ticket(state: TicketState) -> dict:
    inserted = write_effect_once(
        state["side_effect_key"],
        f"ticket {state['ticket_id']} closed",
    )
    print(f"effect_inserted={inserted}")
    return {"status": "closed"}

def count_effects() -> int:
    with sqlite3.connect(EFFECT_DB) as conn:
        conn.execute(
            "CREATE TABLE IF NOT EXISTS effects ("
            "effect_key TEXT PRIMARY KEY, payload TEXT NOT NULL)"
        )
        return conn.execute("SELECT COUNT(*) FROM effects").fetchone()[0]

def build_graph(checkpointer: SqliteSaver):
    builder = StateGraph(TicketState)
    builder.add_node("prepare", prepare)
    builder.add_node("close_ticket", close_ticket)
    builder.add_edge(START, "prepare")
    builder.add_edge("prepare", "close_ticket")
    builder.add_edge("close_ticket", END)
    # 静态断点停在副作用节点之前,便于用第二个进程继续。
    return builder.compile(
        checkpointer=checkpointer,
        interrupt_before=["close_ticket"],
    )

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("mode", choices=["start", "resume", "inspect"])
    args = parser.parse_args()
    config = {"configurable": {"thread_id": THREAD_ID}}

    with SqliteSaver.from_conn_string(CHECKPOINT_DB) as checkpointer:
        graph = build_graph(checkpointer)

        if args.mode == "start":
            graph.invoke(
                {"ticket_id": "T-1001", "status": "new"},
                config=config,
            )
        elif args.mode == "resume":
            graph.invoke(None, config=config)

        snapshot = graph.get_state(config)
        next_node = snapshot.next[0] if snapshot.next else "END"
        print(
            f"status={snapshot.values['status']} "
            f"next={next_node} effects={count_effects()}"
        )

if __name__ == "__main__":
    main()
在两个独立命令中先启动、再恢复;第三条命令只重新读取持久化结果。每次执行 python 都会启动一个新进程,因此这里确实覆盖了进程退出后的恢复。
python ticket_graph.py start
python ticket_graph.py resume
python ticket_graph.py inspect
预期输出
status=prepared next=close_ticket effects=0
effect_inserted=True
status=closed next=END effects=1
status=closed next=END effects=1
实际运行耗时和 checkpoint 内部 ID 可能不同,但这里不依赖这些动态值。关键验收点是:第一次进程停在 close_ticket 之前;第二个进程恢复后进入 closed;第三个进程仍能读到同一线程;副作用记录始终只有 1 条。
为什么只接 checkpointer 还不够
Checkpoint 只能证明“图状态已经提交到哪里”,不能自动把外部 API、消息发送或数据库扣款变成 exactly-once。最危险的窗口是:节点已经完成外部副作用,但进程在新的 checkpoint 提交前崩溃。恢复后该节点可能重放,于是外部动作被再次调用。
生产节点因此应把幂等键设计成业务协议的一部分,例如用 ticket_id + action 生成稳定键,让下游数据库唯一约束、支付接口幂等键或 outbox 表负责去重。不要把“节点没有报错”等同于“副作用已经且只执行一次”。
恢复验证应检查哪些证据
恢复测试至少保留三类证据:graph.get_state(config) 能读到预期业务状态;snapshot.next 指向预期下一节点或为空;外部系统中的副作用条数与业务预期一致。三者同时成立,才能说明这条线程不仅“看起来恢复了”,而且执行位置和外部世界也保持一致。