
AI Agent / 系统课时
流式传递消息与自定义事件
流式传递消息与自定义事件
这一节解决“智能体执行很久,但调用方只能等最终结果”的问题。你会把模型 token、节点完成状态和节点内部的业务进度放进同一次流式执行,让前端可以边接收边展示,而不必把进度字段硬塞进图状态。
学习目标
- 区分
messages、updates与custom三类流式数据的职责 - 在节点内部用
get_stream_writer()发送结构化进度与业务事件 - 在调用方同时消费模型消息、节点更新和自定义事件
三类流分别传什么
messages 面向模型输出,数据是消息分片与元数据;updates 面向图状态变化,告诉调用方哪个节点提交了哪些更新;custom 则由业务代码主动发送,适合进度、工具阶段、命中数量等不会长期保存到状态里的事件。
| 模式 | 典型内容 | 适合展示 |
|---|---|---|
messages |
模型消息分片 | 打字机式回答 |
updates |
节点返回的状态更新 | 节点完成、状态变化 |
custom |
自定义结构化事件 | 工具阶段、进度、业务指标 |
自定义事件与图状态是两条通道:调用 writer(...) 只会把事件推给流消费者,不会自动修改 State;真正持久化到图状态的内容仍要由节点 return。
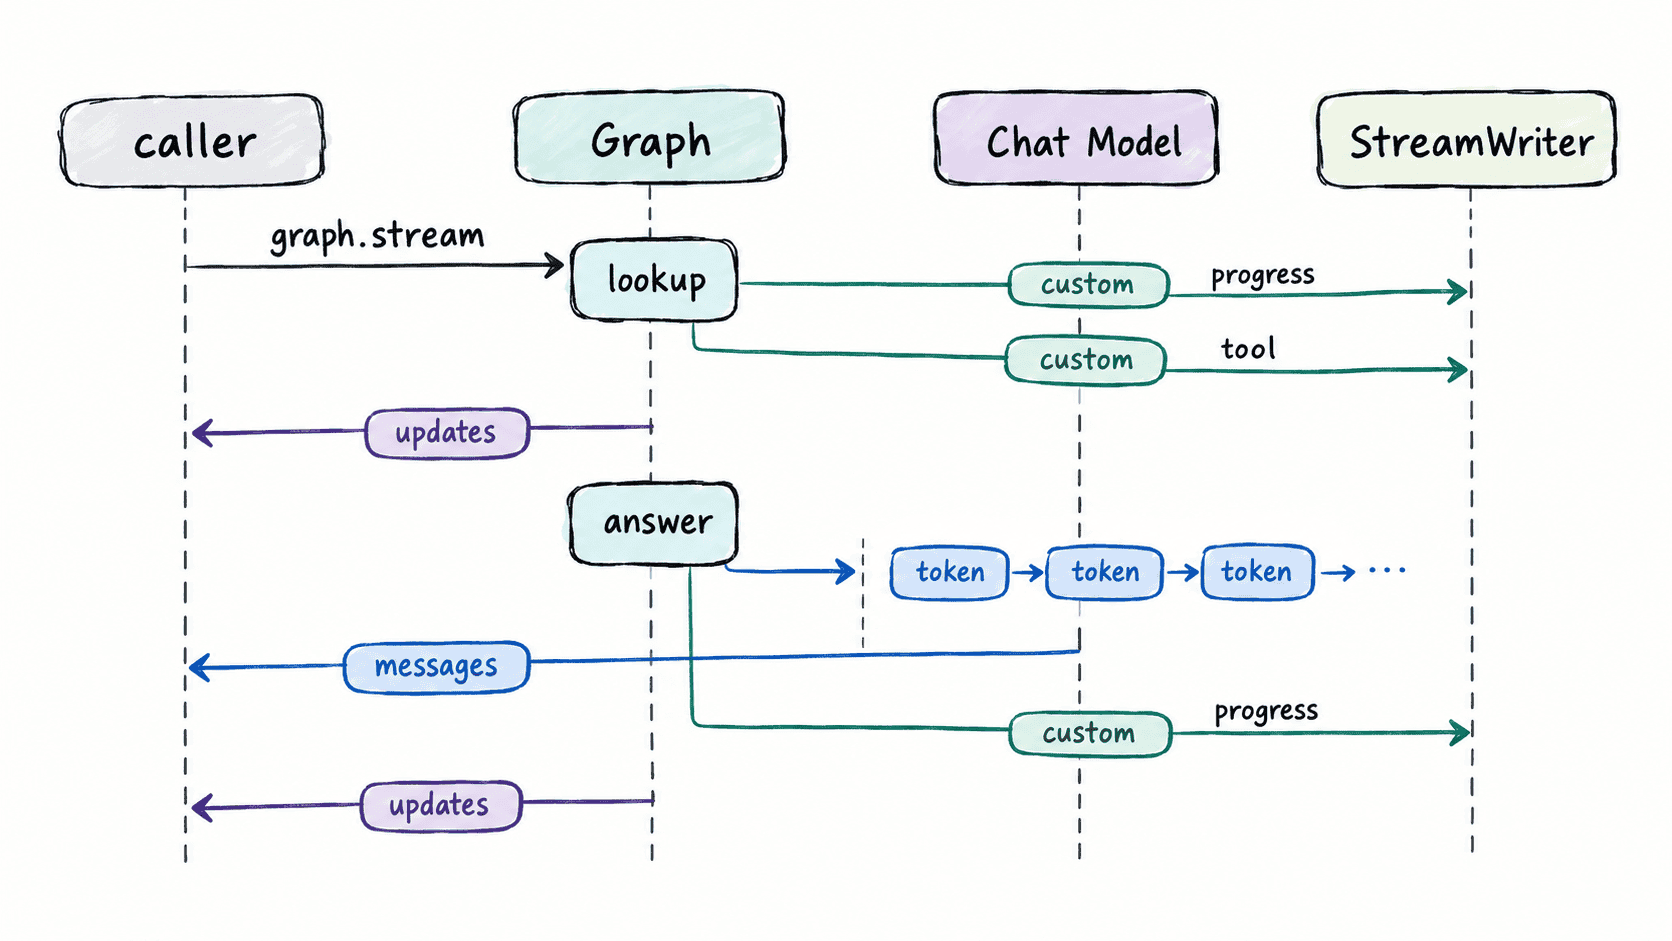
同一次执行消费三类事件
下面用 FakeListChatModel 做确定性演示,不需要真实模型密钥。订单查询工具通过 get_stream_writer() 报告阶段,回答节点显式调用模型的 stream();外层再用 version="v2" 统一读取三种流。
from typing import TypedDict

from langchain_core.language_models.fake_chat_models import FakeListChatModel
from langchain_core.runnables import RunnableConfig
from langchain_core.tools import tool
from langgraph.config import get_stream_writer
from langgraph.graph import END, START, StateGraph

class State(TypedDict):
    question: str
    context: str
    answer: str

model = FakeListChatModel(responses=["已完成"])

@tool
def lookup_order(order_id: str) -> str:
    """查询订单状态,并把工具阶段发送到 custom 流。"""
    writer = get_stream_writer()
    writer({"kind": "tool", "stage": "lookup_order", "status": "start"})
    result = f"订单 {order_id} 已发货"
    writer({"kind": "tool", "stage": "lookup_order", "status": "done"})
    return result

def lookup(state: State, config: RunnableConfig) -> dict:
    context = lookup_order.invoke({"order_id": "A100"}, config=config)
    return {"context": context}

def answer(state: State, config: RunnableConfig) -> dict:
    writer = get_stream_writer()
    writer({"kind": "progress", "stage": "answer", "status": "start"})

    prompt = f"问题:{state['question']}\n上下文:{state['context']}"
    parts = [chunk.content for chunk in model.stream(prompt, config=config)]

    writer({"kind": "progress", "stage": "answer", "status": "done"})
    return {"answer": "".join(parts)}

builder = StateGraph(State)
builder.add_node("lookup", lookup)
builder.add_node("answer", answer)
builder.add_edge(START, "lookup")
builder.add_edge("lookup", "answer")
builder.add_edge("answer", END)
graph = builder.compile()

inputs = {"question": "A100 状态?", "context": "", "answer": ""}

for part in graph.stream(
    inputs,
    stream_mode=["messages", "updates", "custom"],
    version="v2",
):
    if part["type"] == "messages":
        chunk, _metadata = part["data"]
        if chunk.content:
            print(f"MESSAGE:{chunk.content}")
    elif part["type"] == "custom":
        event = part["data"]
        print(
            f"CUSTOM:{event['kind']}:{event['stage']}:{event['status']}"
        )
    elif part["type"] == "updates":
        node_name = next(iter(part["data"]))
        print(f"UPDATE:{node_name}")
预期输出
CUSTOM:tool:lookup_order:start
CUSTOM:tool:lookup_order:done
UPDATE:lookup
CUSTOM:progress:answer:start
MESSAGE:已
MESSAGE:完
MESSAGE:成
CUSTOM:progress:answer:done
UPDATE:answer
这里刻意只打印消息内容和节点名,没有打印模型元数据,因此输出稳定且容易观察。真实模型的 token 粒度可能不同,但调用方仍按 part["type"] 分流处理,不应依赖某个固定 token 数量。
让自定义事件可长期维护
事件负载最好保持“小、稳、可序列化”。例如用 kind 表示事件类别,用 stage 表示业务阶段,用 status 表示阶段状态;前端只依赖这些稳定字段,而不是解析自然语言日志。进度百分比、已处理条数等数据可以继续作为额外字段加入。
常见边界
如果只订阅 custom,模型消息不会自动混进来;需要哪几类数据,就在 stream_mode 中显式组合。get_stream_writer() 依赖 LangGraph 的执行上下文,因此应在节点、任务或工具的运行过程中调用,而不是把节点函数当普通函数直接执行。
消费端也不要假设不同通道之间存在额外的全局排序承诺。界面需要关联某次工具调用时,可在自定义事件中加入稳定的业务 ID,并以该 ID 聚合事件。这样即使模型 token 很密集,工具进度与业务状态仍能独立、可靠地呈现。