
AI Agent / 系统课时
用 StateGraph 跑通首个工作流
用 StateGraph 跑通首个工作流
这一节用一个最小可运行例子把 StateGraph 的完整闭环跑通:定义共享状态、实现两个节点、连接起止边、编译并调用图,最后直接观察每个节点的局部更新如何累积成最终状态。
学习目标
- 能用
TypedDict定义最小共享状态,并让节点读取和更新其中的字段。 - 能用
START、END与普通边连接两个节点并编译StateGraph。 - 能调用编译后的图,并根据最终状态判断工作流是否按预期执行。
最小图由状态、节点和边组成
StateGraph 可以先理解成“围绕同一份状态运行的一组节点”。状态规定图里有哪些字段;节点接收当前状态并返回要更新的字段;边决定接下来执行哪个节点。START 和 END 是图的虚拟起点与终点,不需要自己实现函数。
下面的例子只保留两个动作:normalize 清理并转成大写文本,measure 读取清理后的文本并计算长度。两个节点都只返回自己负责的局部更新,而不是重新构造整份状态。
编写并运行 StateGraph
在已经安装 langgraph 的 Python 环境中,将下面代码保存为 first_graph.py 并运行。
from typing import TypedDict

from langgraph.graph import END, START, StateGraph

class WorkflowState(TypedDict):
    text: str
    length: int

def normalize(state: WorkflowState) -> dict[str, str]:
    # 只更新 text;StateGraph 会把返回值合并回共享状态。
    return {"text": state["text"].strip().upper()}

def measure(state: WorkflowState) -> dict[str, int]:
    # 这里读取的是 normalize 已经更新后的 text。
    return {"length": len(state["text"])}

builder = StateGraph(WorkflowState)
builder.add_node("normalize", normalize)
builder.add_node("measure", measure)

builder.add_edge(START, "normalize")
builder.add_edge("normalize", "measure")
builder.add_edge("measure", END)

graph = builder.compile()
result = graph.invoke({"text": "  langgraph  ", "length": 0})

print(f"text={result['text']}")
print(f"length={result['length']}")
预期输出
text=LANGGRAPH
length=9
compile() 把节点和边组成可执行图;真正传入业务数据的是 invoke()。这里的输入状态包含原始 text 和初始 length,执行结束后返回的是合并完所有节点更新的最终状态。
沿执行链观察状态更新
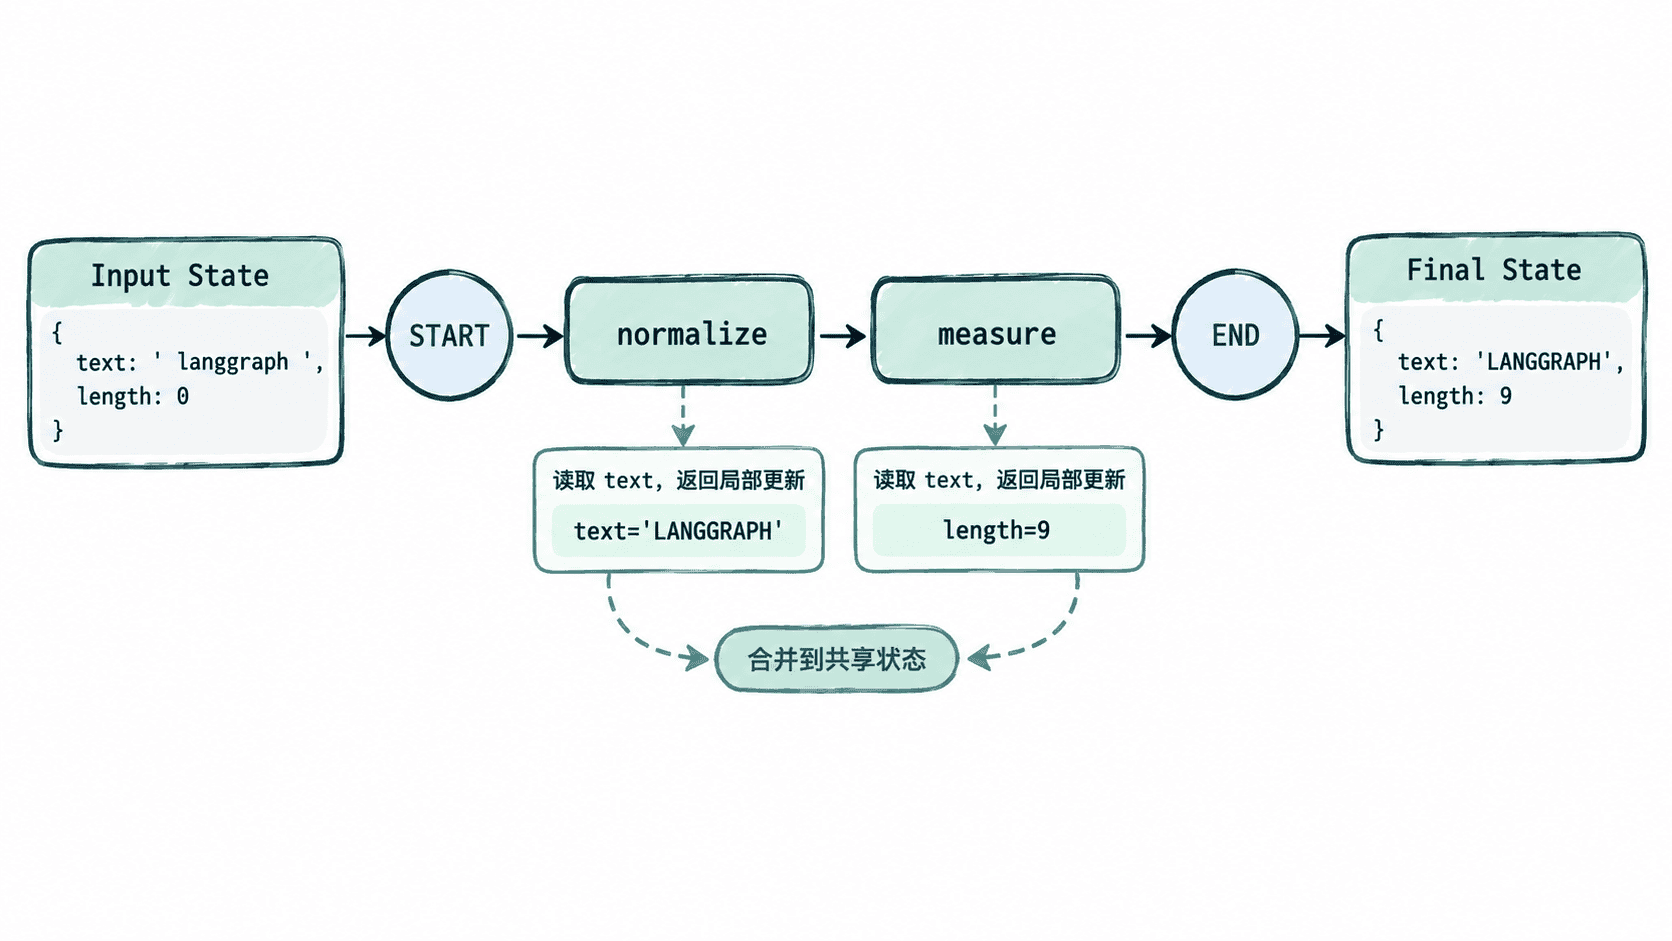
从执行顺序看,输入先进入 normalize,它只覆盖 text;随后 measure 读到的新值已经是 LANGGRAPH,因此计算得到 9。这说明节点之间不是把普通函数返回值直接串起来,而是始终围绕共享状态读取和写回。
节点设计的关键边界
节点最好只更新自己负责的字段。这样一个节点的职责、读写范围和故障影响都更容易定位。若节点返回的字段名不在状态定义中,或者后续节点读取了从未写入的字段,图即使能构建,也容易在运行时出现缺失数据或不符合预期的状态。
首个工作流跑通后,应先检查两件事:边是否表达了真实执行顺序,以及每个节点是否只依赖已经存在的状态字段。把这两个边界守住,后续加入条件分支、循环和持久化时会更容易维护。