
Go / 系统课时
设计缓冲 Channel 容量
设计缓冲 Channel 容量
缓冲 Channel 不是“越大越快”的队列。容量只决定生产者和消费者在短时速率不一致时能积压多少数据,以及什么时候开始阻塞。本课用可运行示例和容量估算方法,建立吞吐、延迟与内存之间的可验证取舍。
学习目标
- 解释缓冲容量如何改变发送、接收与阻塞时机
- 根据突发速率、可接受排队时间和内存预算估算容量
- 识别“加大 Channel 就能提升吞吐”的常见误区
先看容量改变了什么
make(chan T, n) 创建容量为 n 的缓冲 Channel。缓冲未满时,发送方可以把值写入队列后继续执行;缓冲为空时,接收方仍然必须等待。只有当缓冲区满时,新的发送才会阻塞。
这意味着容量主要吸收短时突发,而不是创造处理能力。消费者长期每秒只能处理 100 个任务时,把容量从 100 调到 10000,并不会让稳定吞吐超过这个上限,只会让更多任务等待得更久、占用更多内存。
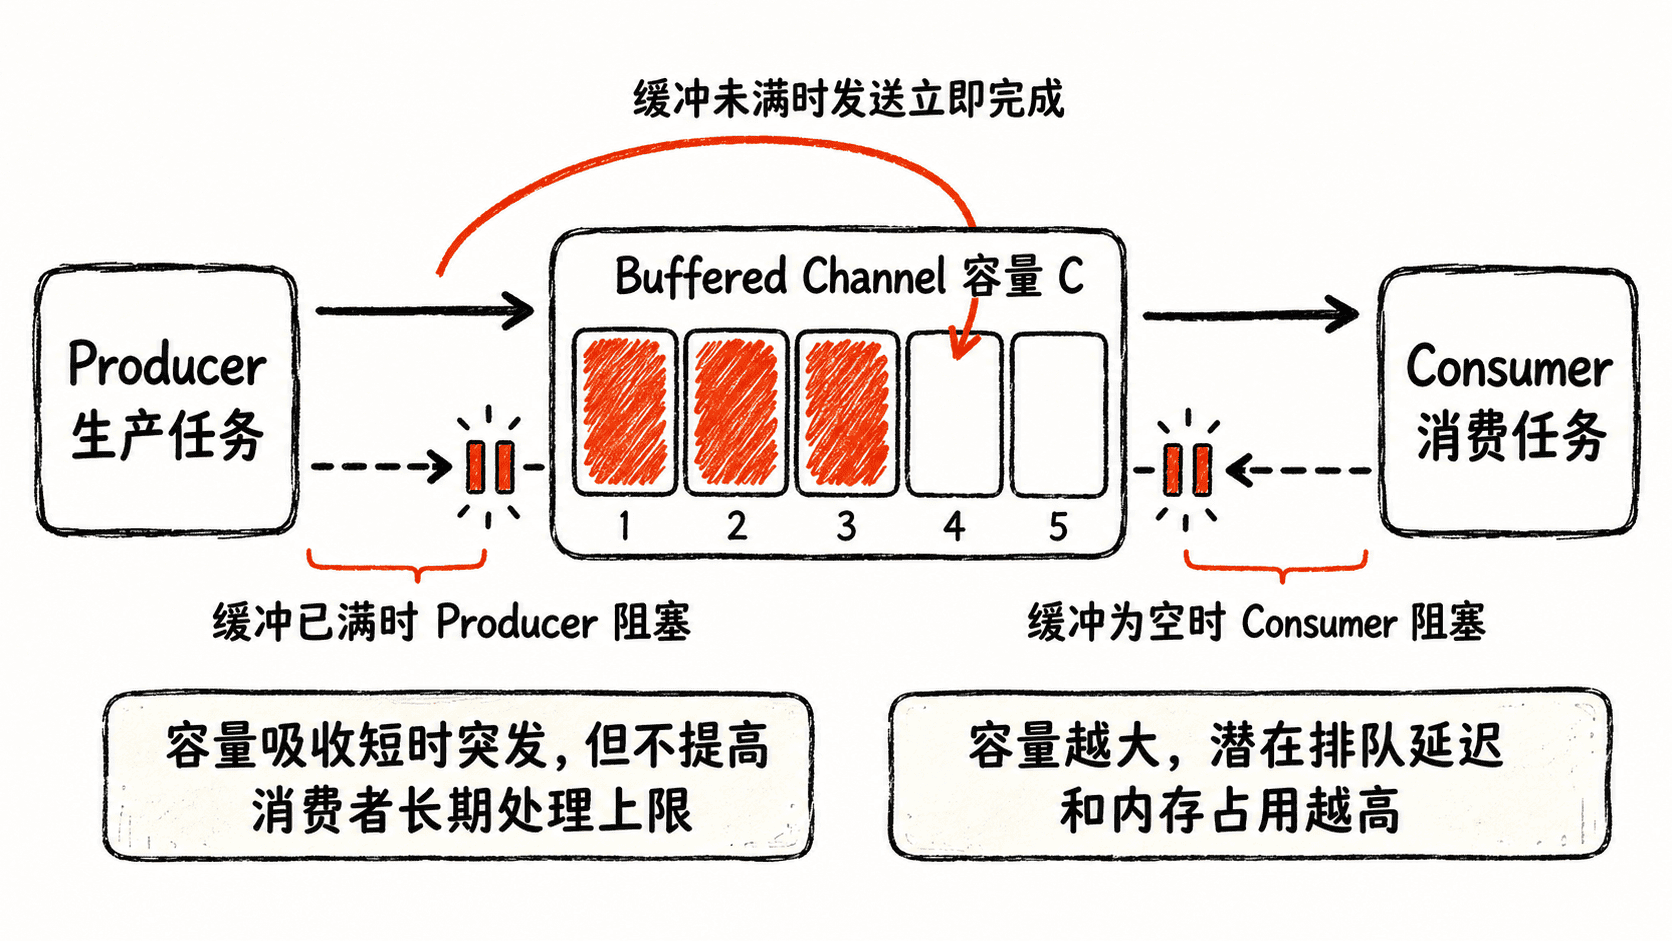
下面的程序把容量设为 2,并用非阻塞 select 验证第三次发送会在缓冲已满时无法立即完成。
package main

import "fmt"

func main() {
	ch := make(chan int, 2)

	ch <- 1
	ch <- 2
	fmt.Printf("len=%d cap=%d\n", len(ch), cap(ch))

	// 缓冲已满,第三次发送如果直接执行会阻塞。
	select {
	case ch <- 3:
		fmt.Println("third send accepted")
	default:
		fmt.Println("third send would block")
	}

	fmt.Println("recv:", <-ch)
	ch <- 3
	fmt.Printf("len=%d cap=%d\n", len(ch), cap(ch))
}
预期输出
len=2 cap=2
third send would block
recv: 1
len=2 cap=2
用生产消费速率估算容量
先区分“稳定速率”和“突发速率”。如果生产者长期速率高于消费者,任何有限容量最终都会被填满;此时应提升消费能力、限流或丢弃,而不是继续扩容 Channel。
当生产者只是短时间更快时,可以用一个简单近似量级估算起点:。其中 r_p 是突发期间的生产速率,r_c 是消费速率,T 是希望吸收的突发持续时间。
例如生产者短时达到 1200 条/秒,消费者稳定处理 1000 条/秒,预计突发最多持续 0.5 秒,则积压约为 100 条。可以把 100 作为初始容量,再通过真实压测观察 P95/P99 延迟、阻塞时间和内存后调整。
同时约束延迟和内存
容量越大,允许排队的任务越多。对请求型工作负载,排队时间本身会进入端到端延迟,因此容量上限应受到延迟预算约束;如果单个任务对象较大,还要同时考虑队列中对象及其引用保持带来的堆占用。
设计时可以按三个问题收敛:允许吸收多长的短时突发、最多能接受多少排队延迟、队列占用多少内存仍在预算内。只要任一约束先达到上限,就不应继续增加容量。
什么时候应该用小容量
需要强背压时,小容量通常更安全:下游一慢,上游会更早感知并减速。若任务允许短时解耦、生产有明确突发而消费者能迅速追平,则适度缓冲可以减少不必要的同步等待。
容量设计的核心不是找一个“通用最佳值”,而是让缓冲足以吸收可接受的短时波动,同时不掩盖持续过载。先按突发量估算,再用延迟、阻塞和内存指标验证,通常比直接设置一个很大的经验值更可靠。