
Go / 系统课时
建立生产性能观测面板
建立生产性能观测面板
性能面板的目标不是堆指标,而是让值班人员在几分钟内回答“用户是否变慢、资源卡在哪里、并发是否失控、问题是否仍在扩大”。本课围绕请求延迟、Goroutine、GC、CPU、内存、阻塞和队列深度设计一组可长期使用的 Go 生产观测信号。
学习目标
- 设计覆盖用户体验、运行时和排队状态的核心指标
- 用统一标签和时间窗口把指标关联起来
- 通过面板与告警验证容量、阻塞和 GC 异常
从用户体验开始分层
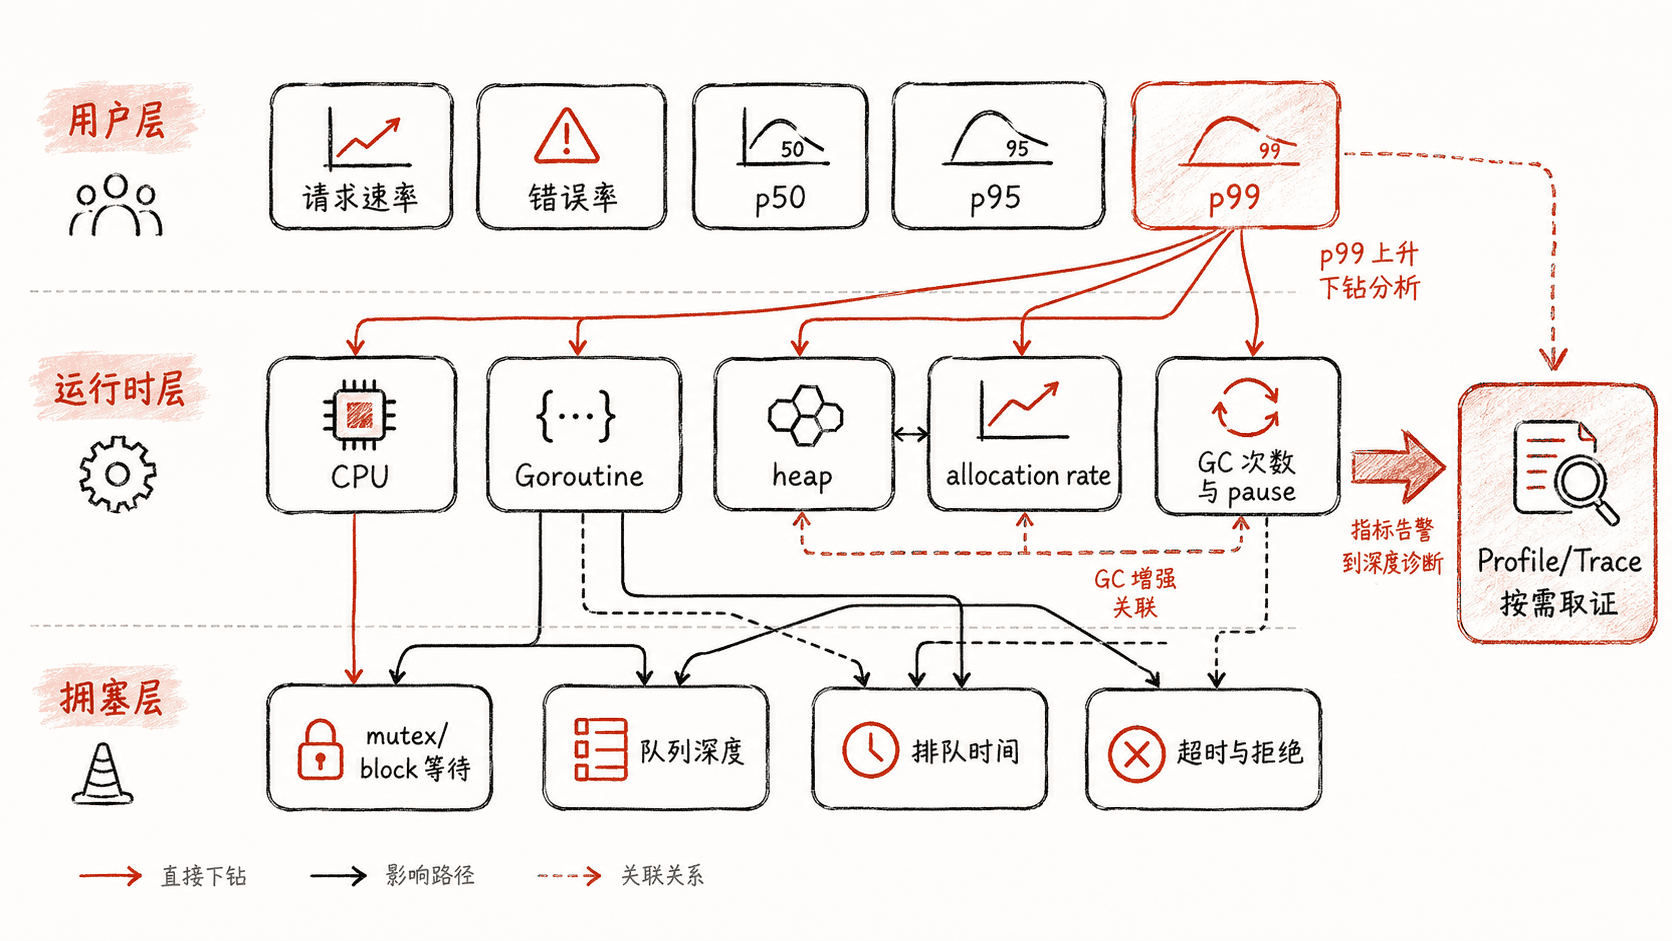
第一层看请求结果:请求速率、错误率以及 p50、p95、p99 延迟。第二层看 Go 运行时:Goroutine、GC 周期与停顿、堆内存、分配速率、CPU。第三层看等待与拥塞:锁等待、通道阻塞、工作队列长度、拒绝或超时数量。
面板不要先问“CPU 是多少”,而要先问“用户是否受影响”。只有当延迟或错误率异常时,再沿运行时和队列信号向下定位,才能避免把高 CPU、较多 Goroutine 这类正常高负载状态误报成故障。
采集一组最小运行时指标
标准库 runtime/metrics 可以直接读取运行时指标。下面的示例暴露一个简单 JSON 端点,采集 Goroutine、堆内存和 GC CPU 时间;生产中通常再由 Prometheus 客户端转换成时序指标。
package main

import (
    "encoding/json"
    "log"
    "net/http"
    "runtime/metrics"
)

func main() {
    names := []string{
        "/sched/goroutines:goroutines",
        "/memory/classes/heap/objects:bytes",
        "/cpu/classes/gc/total:cpu-seconds",
    }

    http.HandleFunc("/runtime-metrics", func(w http.ResponseWriter, r *http.Request) {
        samples := make([]metrics.Sample, len(names))
        for i, name := range names {
            samples[i].Name = name
        }
        metrics.Read(samples)

        out := map[string]float64{}
        for _, s := range samples {
            switch s.Value.Kind() {
            case metrics.KindUint64:
                out[s.Name] = float64(s.Value.Uint64())
            case metrics.KindFloat64:
                out[s.Name] = s.Value.Float64()
            }
        }

        w.Header().Set("Content-Type", "application/json")
        _ = json.NewEncoder(w).Encode(out)
    })

    log.Fatal(http.ListenAndServe("127.0.0.1:8080", nil))
}
预期结果
访问 http://127.0.0.1:8080/runtime-metrics 会返回 3 个运行时指标;数值会随进程负载变化。运行时指标只能回答进程内部发生了什么,还需要业务请求计数、延迟直方图以及队列指标,才能把用户体验与运行时状态关联起来。
面板按诊断问题排布
建议把首屏控制在四类问题内。第一行回答“用户是否变慢”:请求速率、错误率、p95、p99。第二行回答“是否资源饱和”:CPU 使用、堆内存、分配速率、GC CPU。第三行回答“并发是否失控”:Goroutine 数、活跃请求数、队列长度。第四行回答“是否发生同步等待”:mutex/block 等待量、超时数和拒绝数。
指标标签必须克制。服务名、实例、区域、接口或操作名通常可控;用户 ID、请求 ID、完整 URL、错误文本等高基数字段不应直接进入指标标签。需要逐请求定位时,把这些信息放进日志或 Trace,并通过 exemplar 或请求标识关联。
用查询验证告警逻辑
下面以 Prometheus 风格指标为例。若应用导出了请求耗时直方图 http_request_duration_seconds_bucket,可以计算最近 5 分钟的 p99。
histogram_quantile(
  0.99,
  sum by (le, service) (
    rate(http_request_duration_seconds_bucket[5m])
  )
)
预期结果
每个 service 返回一个近似 p99 延迟值;单位与直方图指标保持一致,通常为秒。这类查询本身不是“告警条件”。生产告警还应加入持续时间、最小流量门槛和错误率等约束,避免低流量下的偶发慢请求触发噪声。
建立关联而不是单点阈值
单一阈值容易误导。CPU 90% 但 p99 稳定,可能只是高效利用资源;Goroutine 很多但长期稳定,也可能是合理连接数。更可靠的规则是观察相关变化:p99 上升同时 CPU 接近上限,优先查计算热点;p99 上升伴随 GC CPU 和分配速率抬升,优先查分配;p99 上升伴随队列和阻塞增长,优先查背压或锁竞争。
面板的最后一个入口应指向深度证据,而不是更多图表。指标确认“哪里异常”后,再按需抓 CPU、heap、mutex、block Profile 或 execution trace。长期观测负责发现趋势和触发调查,Profile 与 Trace 负责解释具体代码路径,两者分工清楚,生产排障才会既快又可重复。