
Go / 系统课时
实现 Fan-out 与 Fan-in
实现 Fan-out 与 Fan-in
当一批彼此独立的任务需要并行处理时,Fan-out 负责把任务交给多个 worker,Fan-in 再把结果收回到一个消费点。本课用一个可运行的 worker pool,把并行执行、结果汇聚、首个错误传播和取消收敛到同一条退出路径。
学习目标
- 能用共享任务通道实现受控的 Fan-out,并用结果通道完成 Fan-in。
- 能在任一 worker 失败时传播首个错误,并取消剩余任务。
- 能正确安排任务通道、结果通道和错误通道的关闭责任,避免 goroutine 泄漏。
先看结构与关闭责任
最常见的服务级结构是“一处生产、多处执行、一处汇聚”:生产者只负责投递任务,固定数量的 worker 竞争读取同一个任务通道,所有 worker 把结果发送到同一个结果通道。这样既能利用并行度,又不会为每个任务无上限地创建 goroutine。
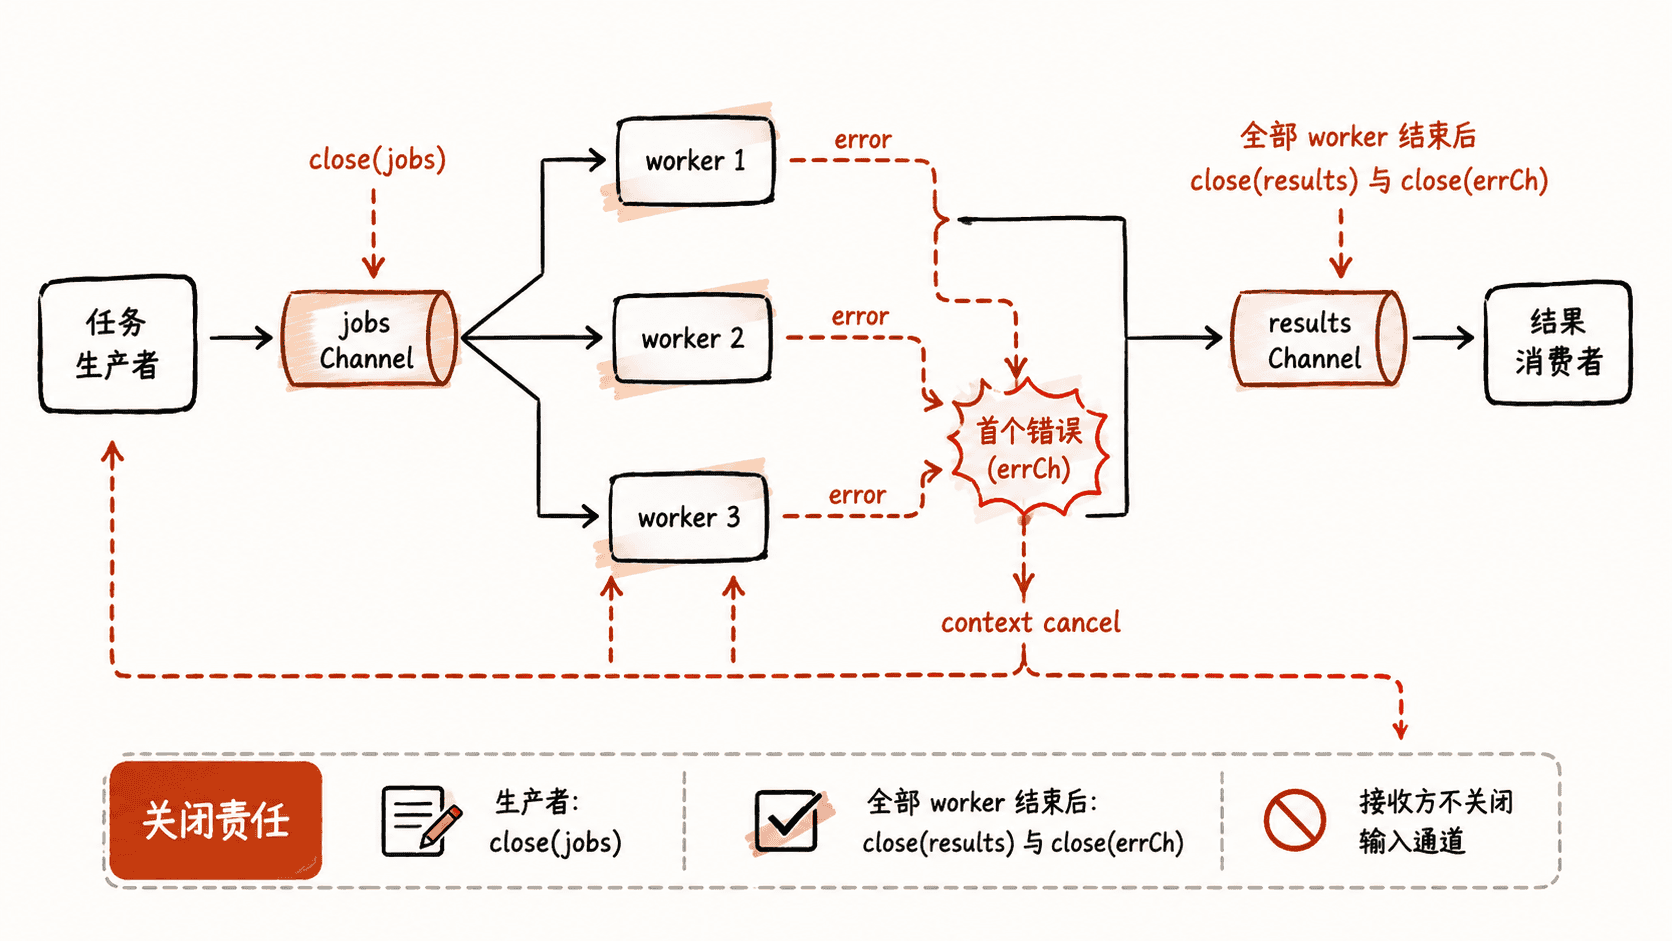
关键点不是“开很多 goroutine”,而是谁拥有输出通道,谁负责关闭它。jobs 由生产者关闭;results 必须等所有 worker 都退出后再关闭;接收方只读取,不关闭别人的输入通道。
用一个完整示例串起分发、执行与汇聚
下面的示例固定 3 个 worker。run 内部完成 Fan-out/Fan-in,并用 sync.Once 保证只传播第一个错误。即使某个任务失败,生产者和其他 worker 也会通过同一个 Context 收到取消信号并退出。
package main

import (
	"context"
	"fmt"
	"sort"
	"sync"
)

type job struct {
	id    int
	value int
}

type result struct {
	id     int
	square int
}

func worker(
	ctx context.Context,
	jobs <-chan job,
	results chan<- result,
	reportErr func(error),
	wg *sync.WaitGroup,
) {
	defer wg.Done()

	for {
		select {
		case <-ctx.Done():
			return
		case j, ok := <-jobs:
			if !ok {
				return
			}

			// 用一个可预期的业务校验模拟 worker 失败。
			if j.value < 0 {
				reportErr(fmt.Errorf("job %d: negative value %d", j.id, j.value))
				return
			}

			r := result{id: j.id, square: j.value * j.value}
			select {
			case results <- r:
			case <-ctx.Done():
				return
			}
		}
	}
}

func run(values []int, workerCount int) ([]result, error) {
	ctx, cancel := context.WithCancel(context.Background())
	defer cancel()

	jobs := make(chan job)
	results := make(chan result)
	errCh := make(chan error, 1)

	var wg sync.WaitGroup
	var once sync.Once

	// 首个错误负责触发全局取消,后续错误不再覆盖它。
	reportErr := func(err error) {
		once.Do(func() {
			errCh <- err
			cancel()
		})
	}

	wg.Add(workerCount)
	for i := 0; i < workerCount; i++ {
		go worker(ctx, jobs, results, reportErr, &wg)
	}

	go func() {
		defer close(jobs)
		for id, value := range values {
			select {
			case jobs <- job{id: id, value: value}:
			case <-ctx.Done():
				return
			}
		}
	}()

	// 只有确认全部 worker 已退出后,才能关闭汇聚通道。
	go func() {
		wg.Wait()
		close(results)
		close(errCh)
	}()

	gathered := make([]result, 0, len(values))
	for r := range results {
		gathered = append(gathered, r)
	}

	if err, ok := <-errCh; ok {
		return nil, err
	}

	// 并发完成顺序不稳定,按任务 id 排序后再形成稳定输出。
	sort.Slice(gathered, func(i, j int) bool {
		return gathered[i].id < gathered[j].id
	})
	return gathered, nil
}

func main() {
	okResults, err := run([]int{2, 3, 4, 5}, 3)
	if err != nil {
		panic(err)
	}
	for _, r := range okResults {
		fmt.Printf("job %d => %d\n", r.id, r.square)
	}

	_, err = run([]int{2, -1, 4}, 3)
	fmt.Println("second run:", err)
}
预期输出:
job 0 => 4
job 1 => 9
job 2 => 16
job 3 => 25
second run: job 1: negative value -1
worker 的真实完成顺序可能不同,但示例在汇聚后按任务编号排序,因此控制台输出稳定。第二次运行不会返回部分结果,而是返回首个错误,让调用方明确选择“整批失败”还是改造成“允许部分成功”。
错误传播要和取消绑定
只把错误写进 errCh 还不够。如果生产者继续发送,而失败后的 worker 已经退出,发送方可能永远阻塞;如果其他 worker 继续做无意义工作,又会浪费 CPU 和下游配额。因此错误路径需要同时做两件事:记录首个错误,并调用 cancel()。
每个可能阻塞的发送和接收都应能观察 ctx.Done()。这样取消可以穿透生产者、worker 和结果发送点,整个并发结构才有共同的退出条件。错误通道使用容量 1,是为了让首错上报本身不会因为主协程暂时未读取而卡住失败 worker。
控制并行度而不是追求 goroutine 数量
Fan-out 的 worker 数应由 CPU、下游并发额度和单任务特征决定。CPU 密集型任务通常接近可用核心数;I/O 密集型任务可以更高,但仍应有明确上限。把“每个请求都再启动无限 goroutine”当作并行策略,最终通常会把延迟问题转化为调度、内存或下游拥塞问题。
Fan-in 的价值则是把并发完成顺序重新收敛成一个可管理的消费边界。只要坚持固定并行度、首错取消、单点关闭和可取消的阻塞操作,这个模式就能稳定地扩展到批量 RPC、文件处理和并行查询等服务场景。