
Go / 系统课时
完成高并发服务调优实战
完成高并发服务调优实战
本节把一次生产调优压缩成可复现的闭环:先固定负载建立基线,再用 CPU、内存、锁 Profile 与 trace 找证据,随后针对锁竞争、分配和过载逐项改动,最后用同一压力模型验证吞吐与 p99 是否真正改善。
学习目标
- 用固定负载、Profile 与 trace 建立可重复的性能诊断闭环。
- 识别锁竞争和短命对象分配热点,并用更低争用、可复用缓冲区的实现替换。
- 用并发上限控制过载,并通过吞吐、尾延迟和错误率完成回归验收。
把调优做成可重复闭环
生产调优最容易失败的地方,是先改代码再寻找理由。正确顺序是先固定请求数据、并发度、机器资源和运行时间,记录吞吐、p50/p95/p99、错误率、CPU、分配速率与 goroutine 数,再采集证据。每轮只改一个主要变量,否则即使指标变好,也很难判断是哪项改动起作用。
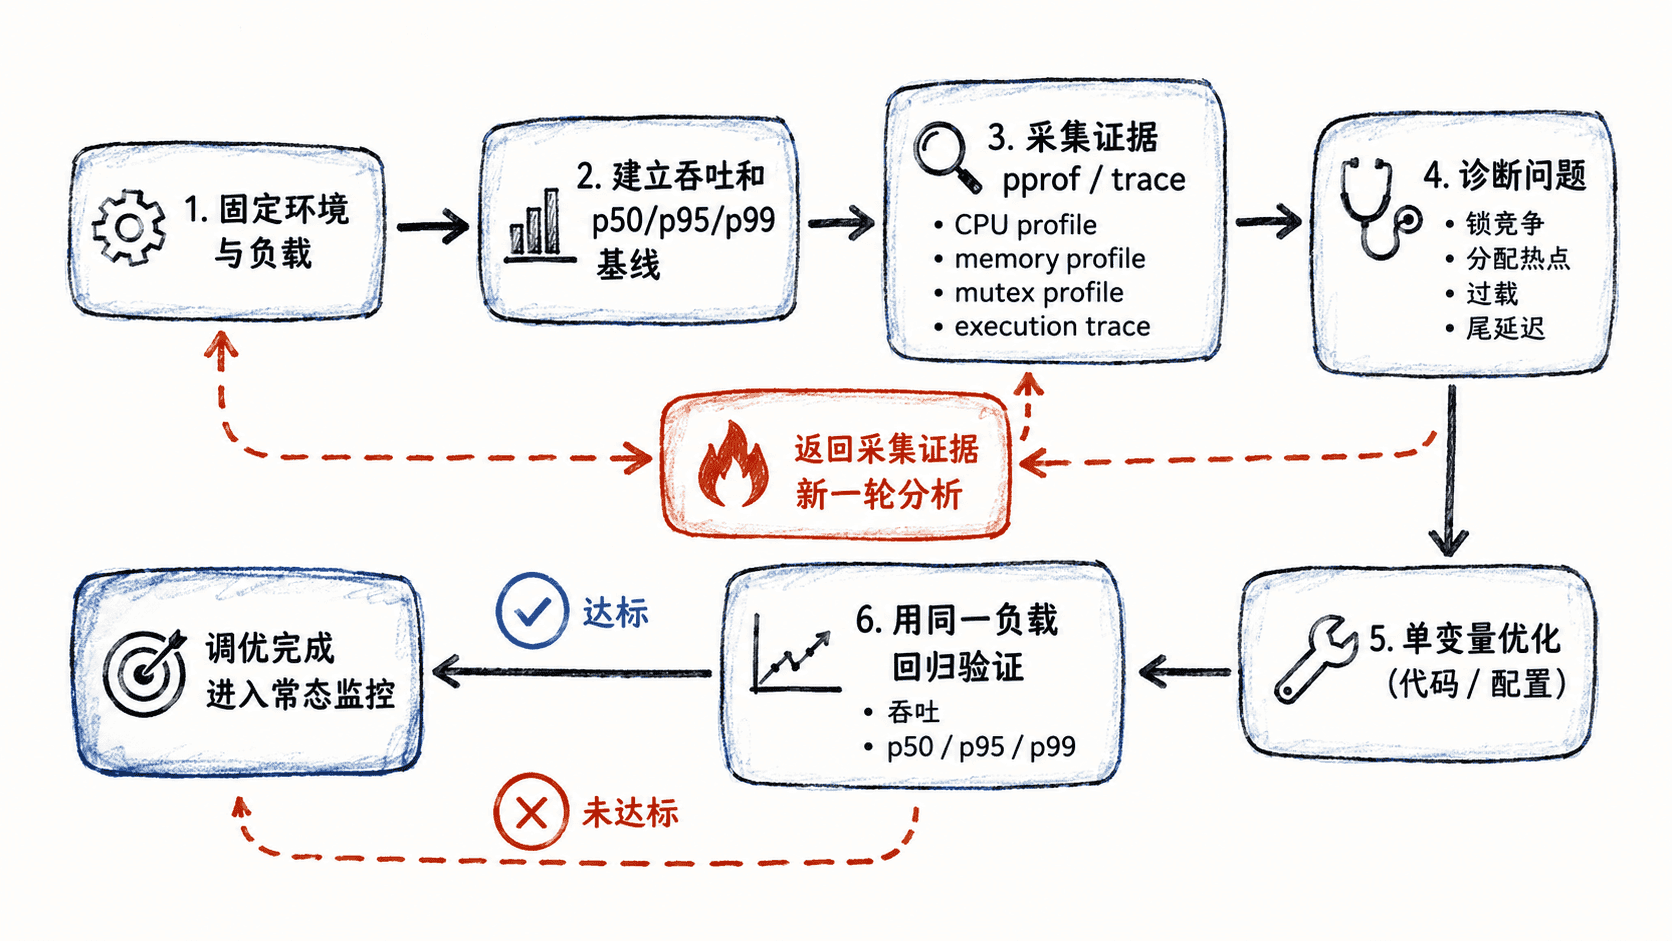
微基准适合隔离锁和分配,但不能替代真实端到端压测。进入生产验收前,还要用同一接口请求分布和到达速率复测 p99,避免“平均值更快、尾延迟更差”。
构造一个可测的锁与分配热点
下面的单文件示例故意制造两类问题:基线实现用全局互斥锁更新计数,并通过 fmt.Sprintf 产生短命对象;优化实现改用原子计数和复用缓冲区。gate 则演示过载时立即拒绝,而不是让请求在进程内无限排队。
package hotspot

import (
	"errors"
	"fmt"
	"strconv"
	"sync"
	"sync/atomic"
	"testing"
)

var ErrOverloaded = errors.New("overloaded")

type baselineService struct {
	mu    sync.Mutex
	total int64
}

func (s *baselineService) handle(id int) []byte {
	// 全局锁会让并发请求在同一个临界区竞争。
	s.mu.Lock()
	s.total++
	total := s.total
	s.mu.Unlock()

	// 格式化和字符串转字节切片会在热路径制造短命对象。
	return []byte(fmt.Sprintf("id=%d,total=%d", id, total))
}

type tunedService struct {
	total atomic.Int64
}

func (s *tunedService) handle(id int, dst []byte) []byte {
	total := s.total.Add(1)
	dst = dst[:0]
	dst = append(dst, "id="...)
	dst = strconv.AppendInt(dst, int64(id), 10)
	dst = append(dst, ",total="...)
	dst = strconv.AppendInt(dst, total, 10)
	return dst
}

type gate struct {
	slots chan struct{}
}

func newGate(maxInFlight int) *gate {
	return &gate{slots: make(chan struct{}, maxInFlight)}
}

func (g *gate) do(fn func()) error {
	select {
	case g.slots <- struct{}{}:
		defer func() { <-g.slots }()
		fn()
		return nil
	default:
		// 上层可把过载映射成 HTTP 503 或等价的资源耗尽错误。
		return ErrOverloaded
	}
}

func BenchmarkBaseline(b *testing.B) {
	s := &baselineService{}
	b.ReportAllocs()
	b.RunParallel(func(pb *testing.PB) {
		for pb.Next() {
			_ = s.handle(42)
		}
	})
}

func BenchmarkTuned(b *testing.B) {
	s := &tunedService{}
	b.ReportAllocs()
	b.RunParallel(func(pb *testing.PB) {
		buf := make([]byte, 0, 64)
		for pb.Next() {
			buf = s.handle(42, buf)
		}
	})
}

func TestGateRejectsOverload(t *testing.T) {
	g := newGate(1)
	entered := make(chan struct{})
	release := make(chan struct{})
	done := make(chan struct{})

	go func() {
		_ = g.do(func() {
			close(entered)
			<-release
		})
		close(done)
	}()

	<-entered
	if err := g.do(func() {}); !errors.Is(err, ErrOverloaded) {
		t.Fatalf("expected overload rejection, got %v", err)
	}
	close(release)
	<-done
}
预期结果
保存为 hotspot_test.go 后可由 go test 正常编译;文件本身不会主动执行测试或基准。用 Profile 与 trace 找证据
先验证过载保护,再对基线和优化版本跑并行基准。随后只采集基线的 CPU、内存、互斥锁 Profile 与 execution trace,确保优化动作来自证据,而不是猜测。
go test -v -run '^TestGateRejectsOverload$' hotspot_test.go
go test -run '^$' -bench 'Benchmark(Baseline|Tuned)$' -benchmem -count=5 hotspot_test.go
go test -run '^$' -bench '^BenchmarkBaseline$' -cpuprofile cpu.out -memprofile mem.out -mutexprofile mutex.out -trace trace.out hotspot_test.go
go tool pprof -top cpu.out
go tool pprof -top -alloc_space mem.out
go tool pprof -top mutex.out
go tool trace trace.out
预期输出
=== RUN   TestGateRejectsOverload
--- PASS: TestGateRejectsOverload (<TIME>s)
PASS
BenchmarkBaseline-<P>    <N>    <NS_BASE> ns/op    <B_BASE> B/op    <A_BASE> allocs/op
BenchmarkTuned-<P>       <N>    <NS_TUNED> ns/op   <B_TUNED> B/op   <A_TUNED> allocs/op
PASS
ok command-line-arguments <TIME>s<P>、<N>、<NS_*> 等值会随 CPU、Go 版本和负载变化。重点不是追求某个固定数字,而是确认优化版的 B/op、allocs/op 和耗时稳定下降。mutex Profile 应能暴露基线临界区的等待成本,内存 Profile 用于确认格式化与转换产生的分配,trace 则检查 goroutine 阻塞、调度延迟和 GC 活动是否与尾延迟尖峰重合。
把吞吐问题和尾延迟分开处理
降低锁竞争和分配后,服务仍可能在压力超过处理能力时出现 p99 飙升。原因通常不是单次请求变慢,而是请求进入队列后等待时间不断累积。此时继续增加 goroutine 或扩大内部队列,只会把故障推迟并放大内存占用。
gate 的目标是把并发量限制在服务可稳定处理的区间。真实服务中应逐级提高并发或请求速率,找到吞吐不再明显增长、但 p99 开始陡升的拐点,再把最大在途请求数设置在拐点之前,并为拒绝路径记录独立错误指标。这样过载时牺牲少量请求,也比让所有请求一起超时更可控。
用同一负载做回归验收
优化完成后必须恢复最初的机器、请求数据、并发模型和测试时长,再重复至少多轮测量。只有对照条件一致,前后数据才有解释力。
| 验收信号 | 应看到的变化 |
|---|---|
| 吞吐 | 在相同资源下不下降,理想情况下上升 |
| p99 | 在目标负载下下降,且没有靠大量拒绝“换”出来 |
| 错误率 | 正常负载保持稳定;超过容量时拒绝可预测 |
B/op 与 allocs/op |
明显低于基线,且多轮结果稳定 |
| mutex Profile | 主要锁等待占比下降,不出现新的集中竞争点 |
| CPU/trace | 没有把瓶颈转移成新的 CPU 热点、长阻塞或 GC 压力 |
如果吞吐提高但 p99 变差,或锁竞争下降却出现新的分配热点,这次改动仍不能算完成。高并发调优的终点不是“Profile 里某个热点消失”,而是同一负载下的吞吐、尾延迟、错误率和资源成本一起达到可接受范围,并能通过重复测试稳定复现。