
Go / 系统课时
实现有界 Worker Pool
实现有界 Worker Pool
本课实现一个可控并发的 Worker Pool:任务进入有限队列,由固定数量的 worker 消费,错误通过结果通道回收,并在队列关闭后完成可验证的退出流程。
学习目标
- 能根据任务吞吐和外部依赖设置 worker 数量与队列容量。
- 能设计任务、结果、错误回收和关闭顺序,避免 goroutine 无限增长。
- 能验证任务全部完成、错误被观察且 worker 正常退出。
结构与关闭边界
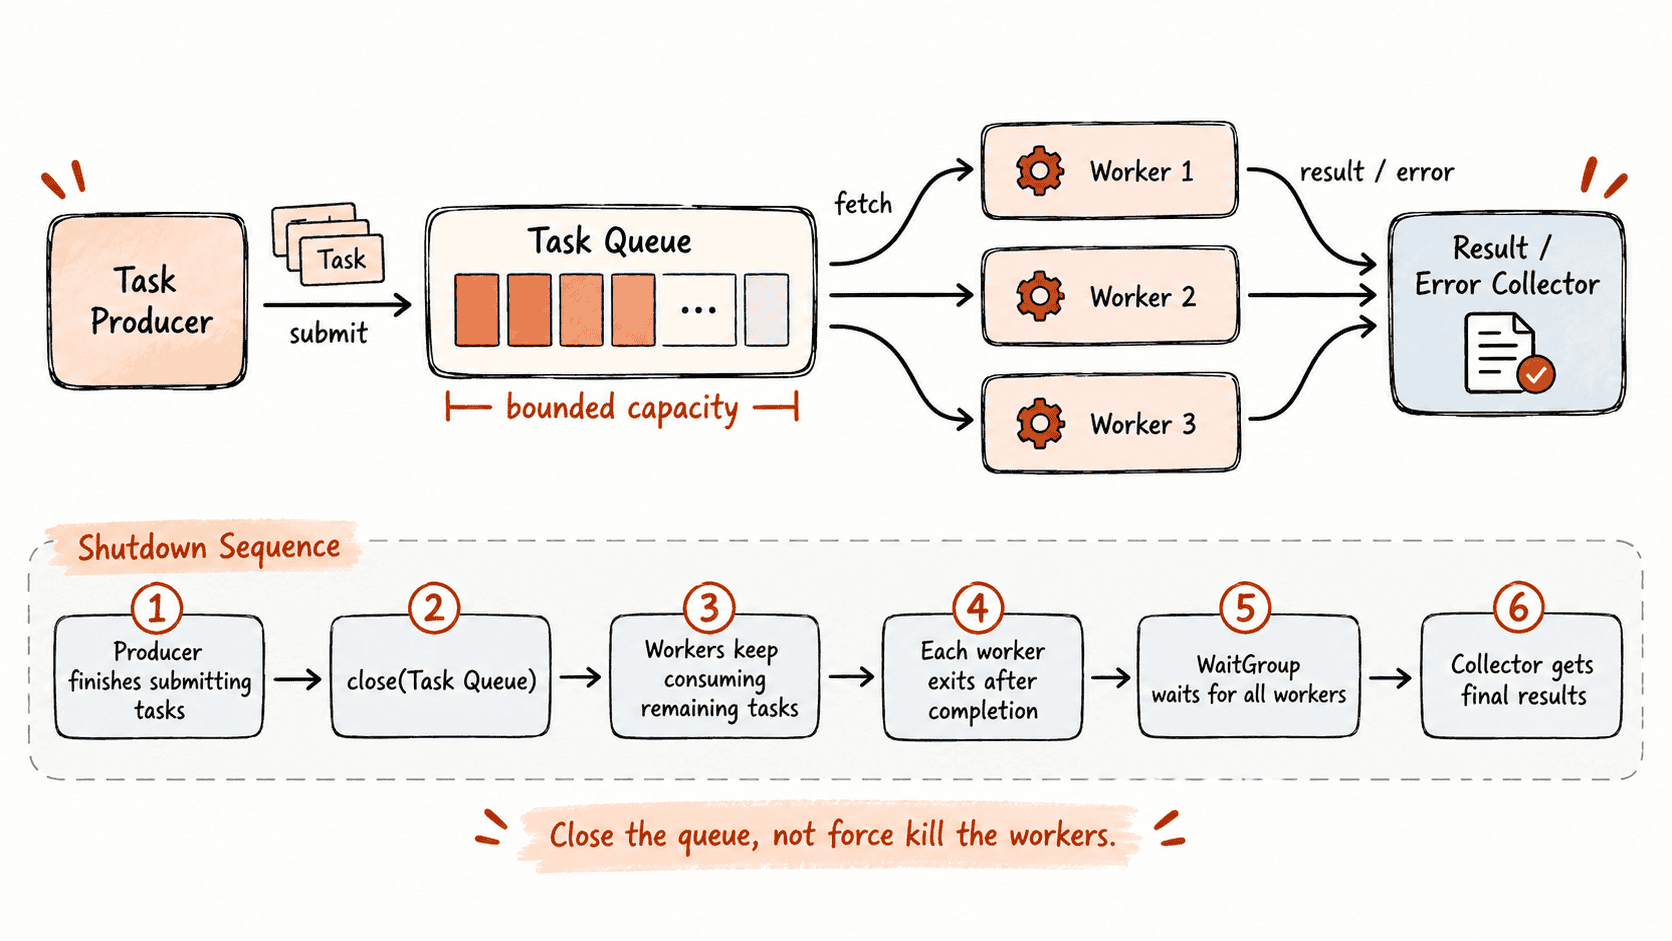
Worker Pool 的核心不是“启动几个 goroutine”,而是把并发上限固定在 worker 数量,把突发流量限制在有界队列。提交方只负责写入任务,worker 负责执行,结果回收方负责消费执行结果。
下面的关系图重点看三个边界:任务生产者不能超过队列容量无限堆积;worker 数量决定同时执行任务的上限;任务队列关闭后,worker 仍会把剩余任务消费完,再自然退出。
设计任务与并发上限
先定义任务和结果结构,再决定三个容量参数:worker 数量、任务队列容量、结果缓冲容量。worker 数量通常受 CPU、下游连接数、磁盘或网络并发能力约束,不应直接等于“请求越多就开越多”。
队列容量决定突发流量能吸收多少。容量过小会更早产生背压,容量过大则可能把延迟和内存占用推迟到更晚才暴露。生产代码中还应明确提交接口在队列满时是阻塞、返回错误还是直接丢弃任务。
本例选择固定 3 个 worker、容量为 4 的任务队列,并让结果通道按任务数提前分配空间,从而避免结果接收速度短暂变慢时反向阻塞 worker。
主示例
下面示例可以直接运行。任务 5 故意返回错误,用于验证错误并不会被 worker 内部吞掉;任务队列由生产者关闭,worker 读取完剩余任务后自动退出。
package main

import (
	"fmt"
	"sync"
)

type Job struct {
	ID int
}

type Result struct {
	JobID int
	Err   error
}

func worker(id int, jobs <-chan Job, results chan<- Result, wg *sync.WaitGroup) {
	defer wg.Done()

	for job := range jobs {
		// 把执行错误交给结果通道,由统一回收方决定如何处理。
		err := execute(job)
		results <- Result{JobID: job.ID, Err: err}
	}

	fmt.Printf("worker %d exited\n", id)
}

func execute(job Job) error {
	if job.ID == 5 {
		return fmt.Errorf("job %d failed", job.ID)
	}
	return nil
}

func main() {
	const workerCount = 3
	const queueSize = 4
	const jobCount = 6

	jobs := make(chan Job, queueSize)
	results := make(chan Result, jobCount)

	var wg sync.WaitGroup
	wg.Add(workerCount)
	for i := 1; i <= workerCount; i++ {
		go worker(i, jobs, results, &wg)
	}

	for i := 1; i <= jobCount; i++ {
		jobs <- Job{ID: i}
	}
	close(jobs) // 生产结束后关闭队列,worker 会消费完剩余任务再退出。

	wg.Wait()
	close(results)

	success, failed := 0, 0
	for result := range results {
		if result.Err != nil {
			failed++
			fmt.Println(result.Err)
			continue
		}
		success++
	}

	fmt.Printf("completed=%d failed=%d\n", success, failed)
}
预期输出
worker <ID> exited
worker <ID> exited
worker <ID> exited
job 5 failed
completed=5 failed=1
其中 worker 的退出顺序是不固定的,<ID> 代表实际运行时的 worker 编号;真正需要保证的是 3 个 worker 最终退出、6 个任务都有结果,并且 1 个错误被统一观察到。
关闭顺序为什么重要
关闭责任最好固定为“生产者关闭任务队列,协调者等待 worker 完成,协调者再关闭结果队列”。worker 不应该关闭自己正在读取的 jobs,因为多个 worker 同时执行时无法判断谁拥有关闭权;结果通道也不能在仍有 worker 写入时提前关闭。
常见错误是为每个任务直接 go handle(job)。这种写法把任务数量直接映射成 goroutine 数量,遇到突发流量时很容易形成调度、内存或下游连接压力。Worker Pool 则把这个变量收敛到固定的 worker 数量,并通过队列形成背压。
实际服务中还应给任务执行增加 context.Context、超时和指标,例如当前队列长度、处理中的 worker 数、任务等待时间、执行时间与错误率。这样 Worker Pool 才从一个并发模式变成可运营的服务组件。