
Go / 系统课时
排查延迟尖刺与 GC 抖动
排查延迟尖刺与 GC 抖动
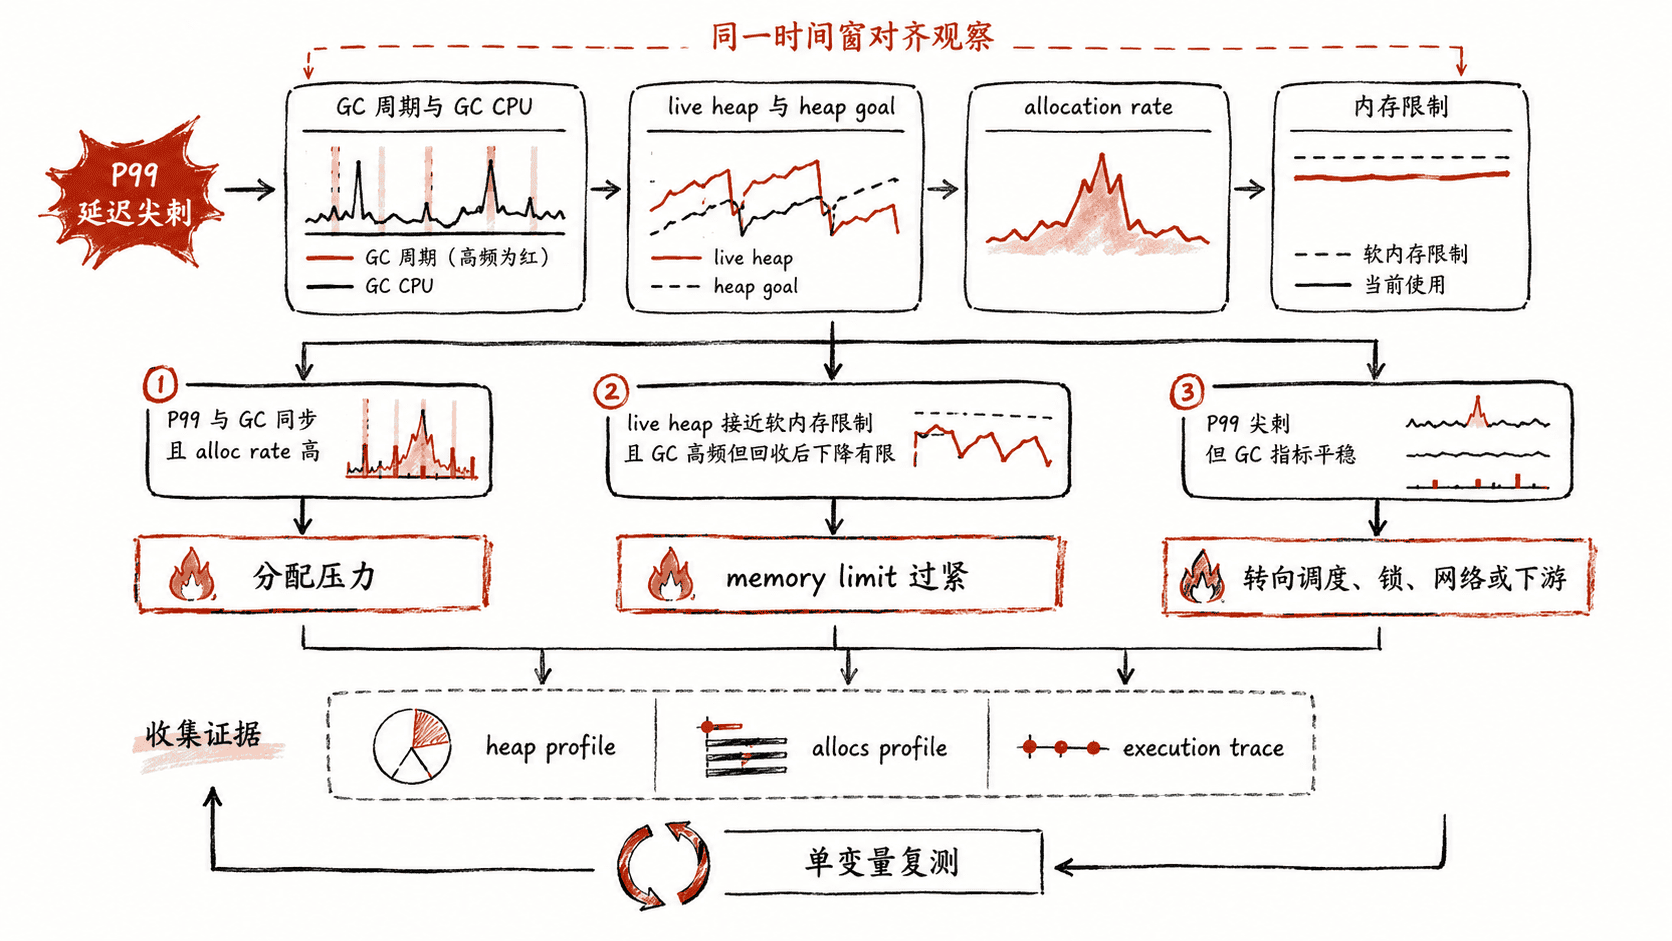
P99 突然抬高时,看到 GC 日志或堆增长并不能直接证明“GC 导致延迟”。本课把延迟时间线与 GC 周期、堆存活量、分配热点和内存限制对齐,区分正常回收、分配压力与内存限制下的高频回收。
学习目标
- 把 P99 尖刺与 GC 周期、堆增长和分配速率按时间关联
- 用 heap、allocs Profile 与 trace 判断回收压力来自哪里
- 识别内存限制过紧造成的 GC 高频运行,并完成单变量验证
先确认时间相关性而不是先归因
真正值得怀疑 GC 的模式通常是:P99 尖刺与 GC 频率或 GC CPU 同步上升,堆在短时间内快速增长,且高分配调用栈集中在少数路径。若 P99 尖刺出现时 GC 指标平稳,就应优先排查锁竞争、调度延迟、网络和下游超时。
还要区分“堆大”和“分配快”。较大的稳定 live heap 可能完全正常;持续很高的 allocation rate 会更快耗尽 heap goal,迫使 GC 更频繁地启动。优化目标通常不是盲目压低总内存,而是减少每个请求产生的短命对象和无必要复制。
在异常窗口采集堆、分配与 trace
前提同样是 pprof 只绑定到受控管理接口。heap 用来回答“现在谁占着内存”,allocs 用来回答“谁累计分配得最多”,trace 则用来观察 GC 事件与应用执行在同一时间轴上的关系。
curl -fsS -o heap.pprof 'http://127.0.0.1:6060/debug/pprof/heap'
curl -fsS -o allocs.pprof 'http://127.0.0.1:6060/debug/pprof/allocs'
curl -fsS -o trace.out 'http://127.0.0.1:6060/debug/pprof/trace?seconds=10'
go tool pprof -top -sample_index=inuse_space heap.pprof
go tool pprof -top -sample_index=alloc_space allocs.pprof
go tool trace trace.out
预期输出
Showing nodes accounting for <VALUE>, <VALUE>% of <VALUE> total
      flat  flat%   sum%        cum   cum%  name
   <VALUE> <VALUE> <VALUE>    <VALUE> <VALUE> <FUNCTION>
...
Serving trace viewer at http://127.0.0.1:<PORT>
前两个 top 的具体数值和函数名随负载变化;<PORT> 也可能不同。打开 trace 后只需要把异常窗口中的 GC 活动、Goroutine 执行和停顿与外部 P99 时间线对应,不要仅凭一次 GC 事件就判定因果。
判断是分配压力还是内存限制
若 alloc_space 高度集中在序列化、字符串拼接、临时切片、反射或对象转换路径,而 inuse_space 并不同比例增长,说明大量对象生命周期很短。此时 GC 频繁往往是分配速率过高的结果,优先复用缓冲区、减少中间对象和重复编码,并通过基准测试确认每次操作的分配数下降。
如果 live heap 长期贴近进程软内存限制,GC 周期越来越密,CPU 花在 GC 上的比例升高,但每次回收后内存下降有限,要怀疑限制过紧。Go 的内存限制约束的是运行时管理的整体内存目标,不应只拿 HeapAlloc 与限制值直接比较;应同时看 live heap、其他运行时内存与限制配置。
用单变量复测确认因果
如果怀疑分配压力,先优化一个明确的高分配路径,再在相同请求模型下比较 P99、alloc_space、GC 频率与 CPU;如果怀疑内存限制,则只调整内存预算或工作集大小,不要同时改 GOGC、并发度和缓存容量。
可接受的因果闭环是:修改后分配速率下降或 GC 周期变疏,随后 P99 尖刺同步收敛,而且吞吐与错误率没有恶化。若 GC 证据改善而 P99 不动,说明 GC 只是伴随现象,应回到 trace 和阻塞 Profile 继续寻找真正的等待来源。