
Go / 系统课时
建立吞吐与延迟性能基线
建立吞吐与延迟性能基线
性能优化前先把“现在有多快、波动多大”测清楚。本课用固定环境、稳定请求、预热和重复执行建立一份可复现基线,并同时记录吞吐、尾延迟、错误率、分配量等指标,避免后续把随机波动误判成优化收益。
学习目标
- 设计可复现的负载输入与运行环境
- 用预热和重复测量降低冷启动与偶然抖动
- 用吞吐、分位延迟和资源指标形成可比较基线
先固定测量条件
一次基线必须能被以后“原样重放”。至少固定 Go 版本、GOMAXPROCS、机器规格、CPU 频率策略、数据集、并发数、请求比例和测试时长;如果服务依赖数据库或远程接口,还要固定依赖版本与数据状态。
不要只记“QPS 约 2 万”。应把运行条件和结果一起保存,例如:GOMAXPROCS=4、并发 64、持续 30 秒、固定请求体、错误率 0、p95 3.8 ms。否则下一轮即使 QPS 上升,也无法判断是代码变快还是测试条件变了。
预热后再进入正式采样
服务刚启动时会经历页缓存、连接池、DNS、TLS 会话、对象池等逐步变热的过程。Go 没有 JIT 预热,但真实服务仍存在明显冷启动因素,所以应先用与正式测试相同的请求预热,再开始记录结果。
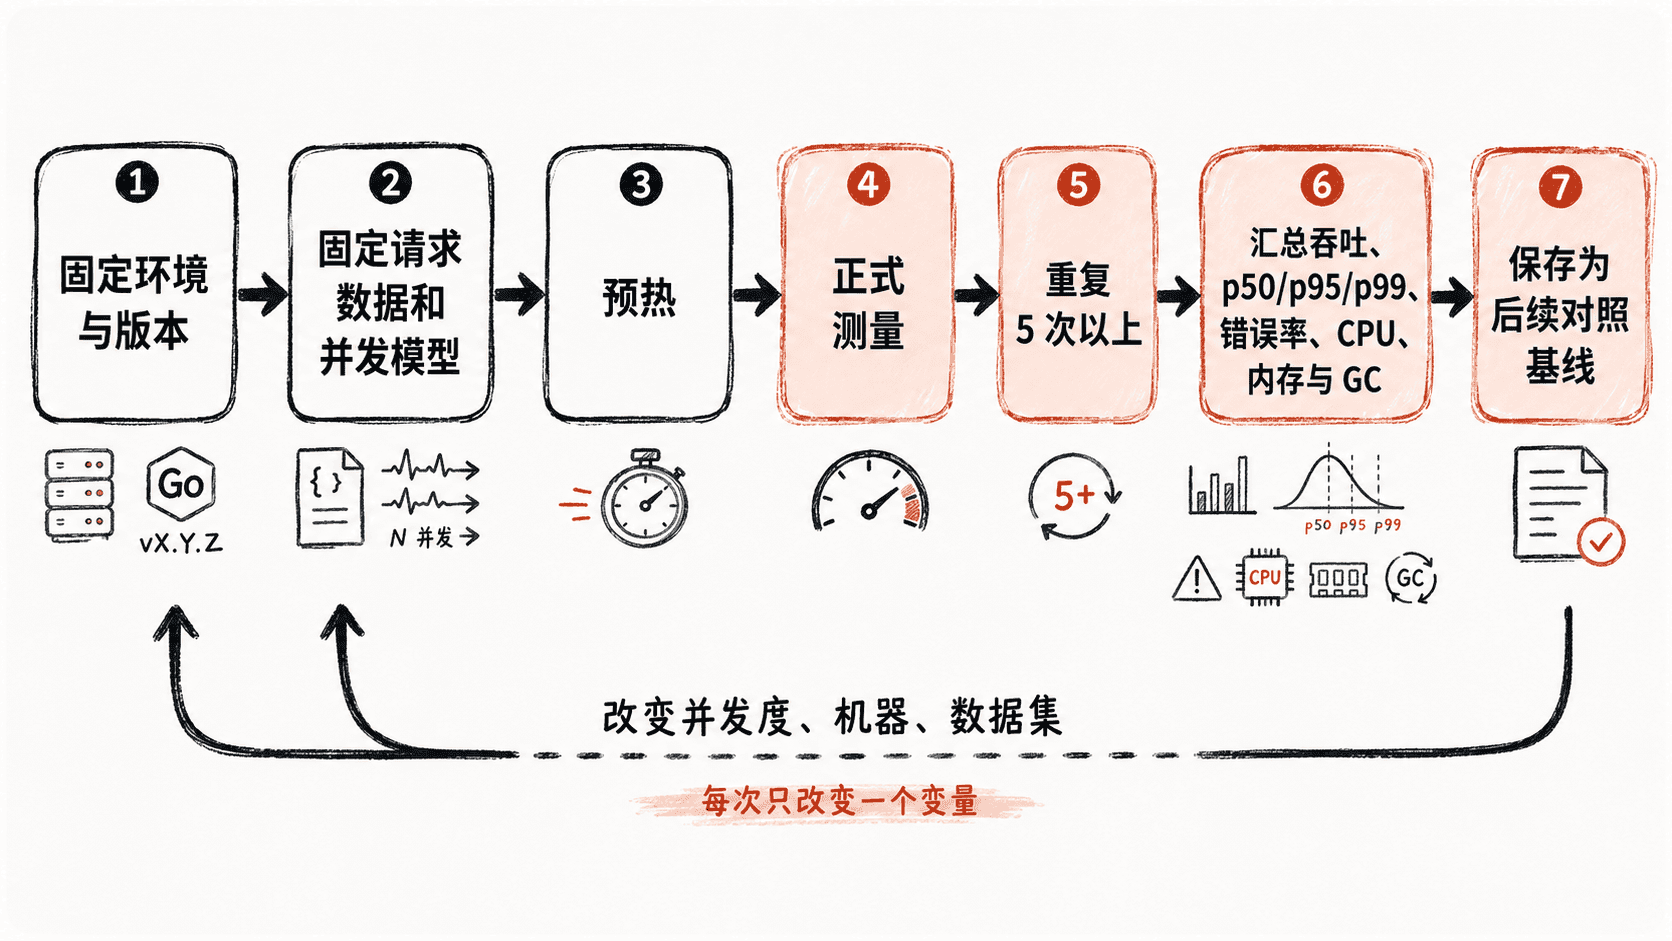
下面用一个最小 HTTP 服务建立可重复负载。服务返回固定大小响应,避免把随机数据生成本身混入被测路径。
package main

import (
	"fmt"
	"net/http"
	"runtime"
)

var payload = make([]byte, 1024)

func main() {
	runtime.GOMAXPROCS(4)

	http.HandleFunc("/work", func(w http.ResponseWriter, r *http.Request) {
		w.Header().Set("Content-Type", "application/octet-stream")
		_, _ = w.Write(payload)
	})

	fmt.Println("listening on :8080")
	if err := http.ListenAndServe(":8080", nil); err != nil {
		panic(err)
	}
}
预期输出:
listening on :8080实际端口可按环境调整。正式对比时不要在不同轮次随意更改 GOMAXPROCS。
用稳定负载记录吞吐与尾延迟
可使用 Vegeta 作为外部压测器。先安装一次,再以固定速率预热 10 秒,随后正式测量 30 秒;-rate 使用同一个值,避免不同轮次输入压力不一致。
go install github.com/tsenart/vegeta@latest
echo "GET http://127.0.0.1:8080/work" | vegeta attack -rate=2000 -duration=10s | vegeta report
echo "GET http://127.0.0.1:8080/work" | vegeta attack -rate=2000 -duration=30s | tee results.bin | vegeta report
预期输出:
Requests      [total, rate, throughput]  <ID>, 2000.00, <VALUE>
Duration      <TIME>
Latencies     [mean, 50, 95, 99, max]   <TIME>, <TIME>, <TIME>, <TIME>, <TIME>
Bytes In      [total, mean]              <VALUE>, 1024.00
Success       [ratio]                    100.00%
Status Codes [code:count] 200:<ID><TIME>、<ID> 和 <VALUE> 会随机器与负载变化。吞吐看 throughput,延迟至少保留 p50、p95、p99;如果错误率不为 0,这一轮不能只拿成功请求的低延迟来宣称性能提升。
重复测量并保存可比较结果
正式基线至少重复 5 次,不要只挑最好的一次。对吞吐和 p95/p99 记录中位数与波动范围;如果某一轮明显偏离其他轮次,先查 CPU 抢占、后台任务、网络抖动或依赖状态,再决定是否剔除。
建议为每轮同步记录 CPU 利用率、RSS、GC 次数与分配速率。吞吐上升但 CPU 也同比增加,可能只是消耗更多资源换来更高处理量;p50 下降而 p99 变差,则说明尾部体验可能退化。后续优化只有在相同测试条件下重复执行,并且关键指标改善超过正常波动,才算真正优于这份基线。