
Go / 系统课时
排查死锁、活锁与并发泄漏
排查死锁、活锁与并发泄漏
这类故障的共同点是“程序还在,但有效工作停了或越来越慢”。本课用 Goroutine 堆栈、阻塞 Profile、超时边界和最小复现,把死锁、活锁与 Goroutine 泄漏拆成可验证的证据链,并给出修复后的回归检查方法。
学习目标
- 根据运行现象区分死锁、活锁和 Goroutine 泄漏
- 用 Goroutine 堆栈与 block Profile 找到具体等待点
- 通过超时、取消和最小复现验证根因与修复
先按现象分类
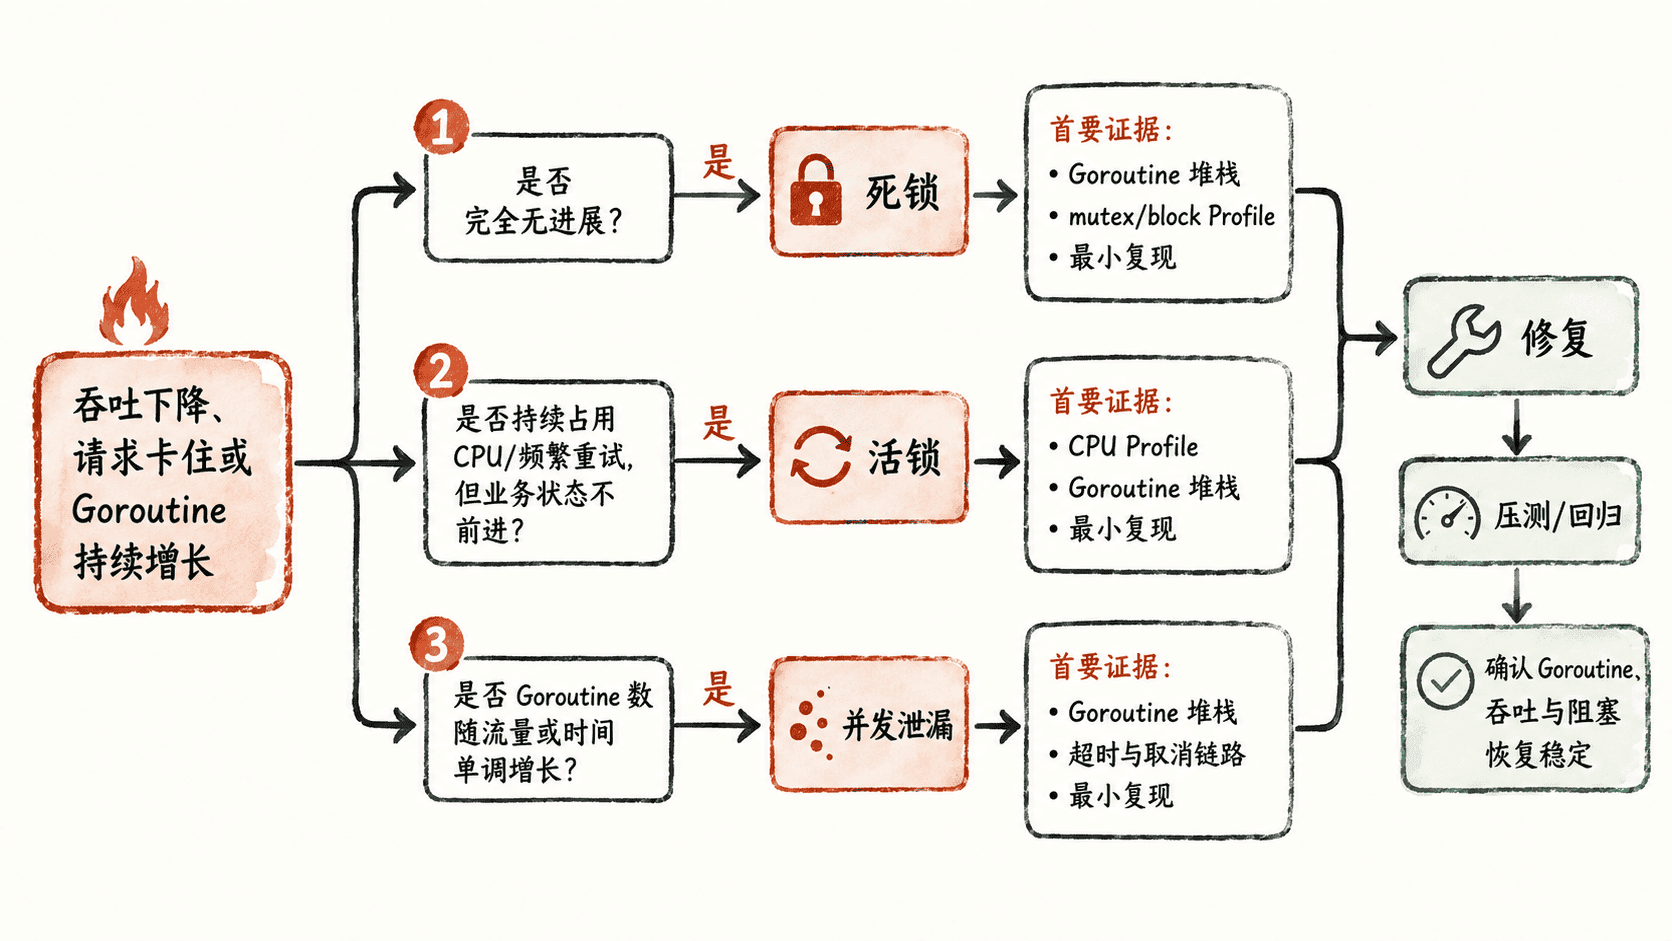
死锁是参与者永久互等:没有任何一方还能推动状态前进。活锁则不断执行、不断重试,但状态始终无法收敛。并发泄漏通常表现为 Goroutine 数持续增长,旧任务因为缺少退出条件、取消传播或通道收尾而长期存活。
| 现象 | 常见信号 | 优先证据 |
|---|---|---|
| 死锁 | 吞吐降为 0,请求长期挂起 | Goroutine 堆栈、mutex/block Profile |
| 活锁 | CPU 不低,吞吐却接近 0 | CPU Profile、重试日志、状态计数 |
| Goroutine 泄漏 | runtime.NumGoroutine() 长期上升 |
Goroutine Profile、请求超时、对象生命周期 |
先抓 Goroutine 堆栈
生产进程暴露 net/http/pprof 时,可以先抓 Goroutine Profile。debug=2 会输出可读堆栈,重点看大量 Goroutine 是否停在同一个 chan send、chan receive、sync.Mutex.Lock、sync.Cond.Wait 或网络调用位置。
curl -s "http://127.0.0.1:<PORT>/debug/pprof/goroutine?debug=2" > goroutine.txt
grep -E "chan send|chan receive|sync\.Mutex|sync\.Cond" goroutine.txt | head
预期输出
goroutine <ID> [chan receive]:
goroutine <ID> [sync.Mutex.Lock]:
实际 Goroutine ID、端口和堆栈位置会不同。若同一阻塞点出现成百上千次,不要只看最上层函数,还要沿调用栈找到“谁创建了它、谁本应释放它”。
用阻塞 Profile 缩小等待热点
Goroutine 堆栈告诉你“现在卡在哪里”,block Profile 更适合回答“哪些同步等待累计最重”。应用需要先设置阻塞采样率,例如在初始化阶段调用 runtime.SetBlockProfileRate(1);这会记录阻塞事件,生产环境应根据开销谨慎启用。
package main

import (
    "log"
    "net/http"
    _ "net/http/pprof"
    "runtime"
)

func main() {
    runtime.SetBlockProfileRate(1)
    log.Fatal(http.ListenAndServe("127.0.0.1:6060", nil))
}
预期结果
服务监听 127.0.0.1:6060,可通过 /debug/pprof/block 获取阻塞 Profile。随后抓取样本并分析:
curl -s -o block.pb.gz "http://127.0.0.1:6060/debug/pprof/block"
go tool pprof -top block.pb.gz
预期输出
Showing nodes accounting for <VALUE>, <VALUE>% of <VALUE> total
      flat  flat%   sum%        cum   cum%
   <VALUE> <VALUE>% <VALUE>%    <VALUE> <VALUE>%  <FUNCTION>
真实函数名和数值取决于负载。若某个锁或通道等待占据主要累计时间,再回到源码检查持锁范围、发送接收配对和退出条件。
用最小复现确认根因
排查时不要直接在生产代码上反复试错。把可疑同步关系缩成最小程序,并给测试加超时。下面这个示例故意让两个 Goroutine 以相反顺序获取锁,从而构造经典锁顺序死锁。
package main

import (
    "sync"
    "time"
)

func main() {
    var a, b sync.Mutex
    start := make(chan struct{})
    var wg sync.WaitGroup
    wg.Add(2)

    go func() {
        defer wg.Done()
        a.Lock()
        defer a.Unlock()
        <-start
        time.Sleep(10 * time.Millisecond)
        b.Lock()
        b.Unlock()
    }()

    go func() {
        defer wg.Done()
        b.Lock()
        defer b.Unlock()
        close(start)
        time.Sleep(10 * time.Millisecond)
        a.Lock()
        a.Unlock()
    }()

    wg.Wait()
}
预期结果
程序无法正常结束,并最终可能由运行时报告所有 Goroutine 都处于死锁状态。修复这类问题的首选不是“多加超时”,而是统一锁顺序、缩短临界区,或重新设计所有权,使同一资源只由单一 Goroutine 串行管理。超时更适合为外部等待提供失败边界,而不是掩盖内部同步错误。
识别泄漏与活锁
Goroutine 泄漏最常见的模式是:调用方超时返回,但后台 Goroutine 仍阻塞在发送、接收或重试循环中。修复时要保证 context.Context 能传到阻塞点,并让所有长期循环都能监听取消信号。
活锁则要关注“状态是否真的变化”。如果 CPU Profile 显示热点集中在 CAS、自旋、退避或冲突重试函数,而业务吞吐没有增长,应增加重试次数、冲突次数和成功推进次数三个指标。只看 CPU 高低,很容易把活锁误判成普通计算热点。
最终回归至少验证三件事:固定负载下 Goroutine 数不再持续增长;请求超时与阻塞 Profile 恢复稳定;同一最小复现能够在预期时间内完成。这样修复的不是某一次“卡住”,而是造成无进展的同步关系本身。