
Go / 系统课时
减少分配并谨慎使用对象池
减少分配并谨慎使用对象池
高并发路径里的小对象分配会累积成 GC 压力,但“看到 alloc 就上池”很容易换来更复杂的生命周期问题。本课先用 -benchmem 和内存 Profile 确认分配热点,再依次尝试预分配、复用和 sync.Pool,最后用基准结果决定池化是否值得保留。
学习目标
- 用
B/op、allocs/op与alloc_space找出真正值得优化的分配点。 - 通过预分配和局部复用降低临时对象与切片扩容。
- 正确使用
sync.Pool,避免大对象滞留、敏感数据残留和 Put 后继续访问。
先确认分配是瓶颈
分配优化只有在证据指向内存压力时才值得做。先看基准里的 B/op 与 allocs/op,再结合 heap 或 alloc_space Profile 判断热点调用栈。如果 CPU 主要耗在业务计算、锁竞争或系统调用上,优先池化对象通常不会改善端到端延迟。
alloc_space 关注一段时间内累计分配了多少内存,适合寻找“不断创建又很快回收”的热点;inuse_space 更接近采样时仍然存活的对象。减少瞬时垃圾通常先看前者,排查长期占用则更关注后者。
先做预分配,再考虑池化
下面用一组基准比较三种策略:无容量提示的切片追加、一次性预分配,以及复用 bytes.Buffer 的 sync.Pool。它们放在同一个 alloc_test.go 中,便于用同一台机器直接比较。
package allocdemo

import (
    "bytes"
    "sync"
    "testing"
)

var sinkByte byte

//go:noinline
func consume(p []byte) {
    sinkByte = p[0] ^ p[len(p)-1]
}

func BenchmarkAppend(b *testing.B) {
    for n := 0; n < b.N; n++ {
        var buf []byte
        for i := 0; i < 1024; i++ {
            buf = append(buf, byte(i))
        }
        consume(buf)
    }
}

func BenchmarkPreallocate(b *testing.B) {
    for n := 0; n < b.N; n++ {
        // 已知最终规模时,预留容量可避免 append 触发多轮扩容。
        buf := make([]byte, 0, 1024)
        for i := 0; i < 1024; i++ {
            buf = append(buf, byte(i))
        }
        consume(buf)
    }
}

var bufferPool = sync.Pool{
    New: func() any {
        return new(bytes.Buffer)
    },
}

func BenchmarkPool(b *testing.B) {
    for n := 0; n < b.N; n++ {
        buf := bufferPool.Get().(*bytes.Buffer)
        buf.Reset()

        for i := 0; i < 1024; i++ {
            buf.WriteByte(byte(i))
        }
        consume(buf.Bytes())

        // 不把异常膨胀的大缓冲放回池,避免长期保留过大的 backing array。
        if buf.Cap() <= 64<<10 {
            bufferPool.Put(buf)
        }
    }
}
运行基准:
go test -run '^$' -bench . -benchmem -count=3预期输出的绝对数值会随 Go 版本、CPU 和 GC 时机变化,重点比较同一环境下的 B/op 与 allocs/op:
BenchmarkAppend-<N>          <COUNT>    <TIME> ns/op    <VALUE> B/op    <VALUE> allocs/op
BenchmarkPreallocate-<N>     <COUNT>    <TIME> ns/op    <VALUE> B/op    <VALUE> allocs/op
BenchmarkPool-<N>            <COUNT>    <TIME> ns/op    <VALUE> B/op    <VALUE> allocs/op
PASS
ok      allocdemo      <TIME>s
通常预分配会减少切片扩容产生的分配。如果同一个 goroutine 能在循环中持续持有缓冲,优先把对象移到循环外并在每轮 Reset 或截短后复用,这比引入共享池更简单。sync.Pool 在对象可重复利用且调用频繁时可能进一步降低临时分配,但不要预设它一定更快,必须以重复基准和真实负载为准。
看清 sync.Pool 的生命周期
sync.Pool 适合缓存“可丢弃的临时对象”。池中的对象可能在 GC 周期中被移除,因此它不是有容量保证的缓存,更不能拿来管理数据库连接、文件句柄或必须持久存在的资源。Get 之后对象只属于当前使用者;一旦 Put,就必须视为所有权已经交还,不能继续读写。
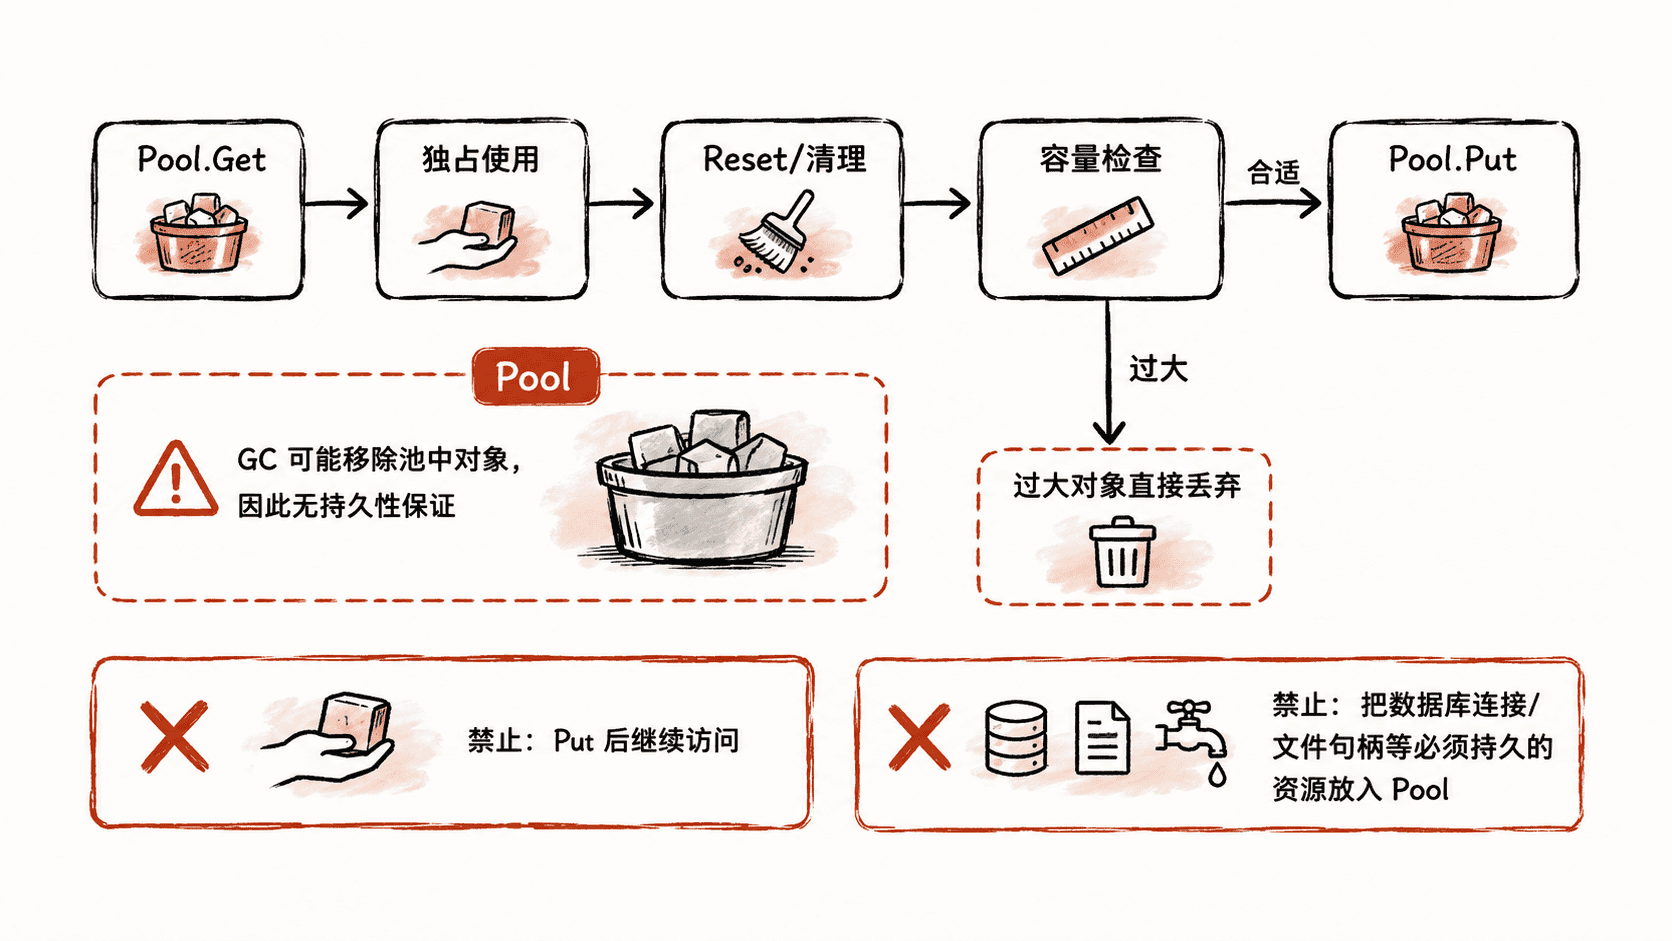
对 bytes.Buffer、切片或编码器这类对象,归还前应恢复到可复用状态。Reset 只重置逻辑长度,通常仍会保留底层容量,所以示例额外设置了容量上限,避免偶发大请求把几十 MB 的缓冲长期留在池中。
如果对象可能保存口令、令牌或其他敏感字节,只做 Reset 不等于擦除底层数据;需要在归还前显式覆盖敏感区域,或者干脆不要把这类对象放入通用池。
用内存 Profile 验证热点是否消失
只对某个候选路径做分配 Profile,可以避免被其他基准噪声干扰:
go test -run '^$' -bench '^BenchmarkAppend$'   -benchmem -memprofile=mem.out
go tool pprof -top -alloc_space mem.out
预期输出会按累计分配量列出热点函数,具体字节数和占比属于动态值:
Type: alloc_space
Showing nodes accounting for <VALUE>, <VALUE>% of <VALUE> total
      flat  flat%   sum%        cum   cum%
   <VALUE> <VALUE>% <VALUE>%   <VALUE> <VALUE>%  allocdemo.BenchmarkAppend
把优化前后的 Profile、B/op、allocs/op、GC CPU 和 p99 放在一起比较。如果分配显著下降但延迟没有改善,池化复杂度就可能不值得;如果 Pool 引入明显锁竞争、内存滞留或对象清理成本,也应退回更简单的预分配方案。最稳妥的顺序始终是先减少不必要的创建,再做局部复用,最后才让 sync.Pool 进入热路径。