
Go / 系统课时
使用 Goroutine Profile 查泄漏
使用 Goroutine Profile 查泄漏
Goroutine 泄漏通常不是“goroutine 数量多”,而是本应结束的 goroutine 持续累积。Goroutine Profile 能同时给出当前数量和堆栈聚类,本课用一个故意泄漏的 HTTP 服务演示采集、聚类与归因,并说明如何区分 Channel、锁、I/O 和 Context 等常见等待。
学习目标
- 用 Goroutine Profile 判断数量增长是否集中在同一业务堆栈。
- 结合聚合 Profile 与
debug=2堆栈识别 Channel、锁、I/O、Context 等等待类型。 - 从阻塞位置继续追到 goroutine 的 owner、退出条件与资源关闭责任。
先确认增长是否异常
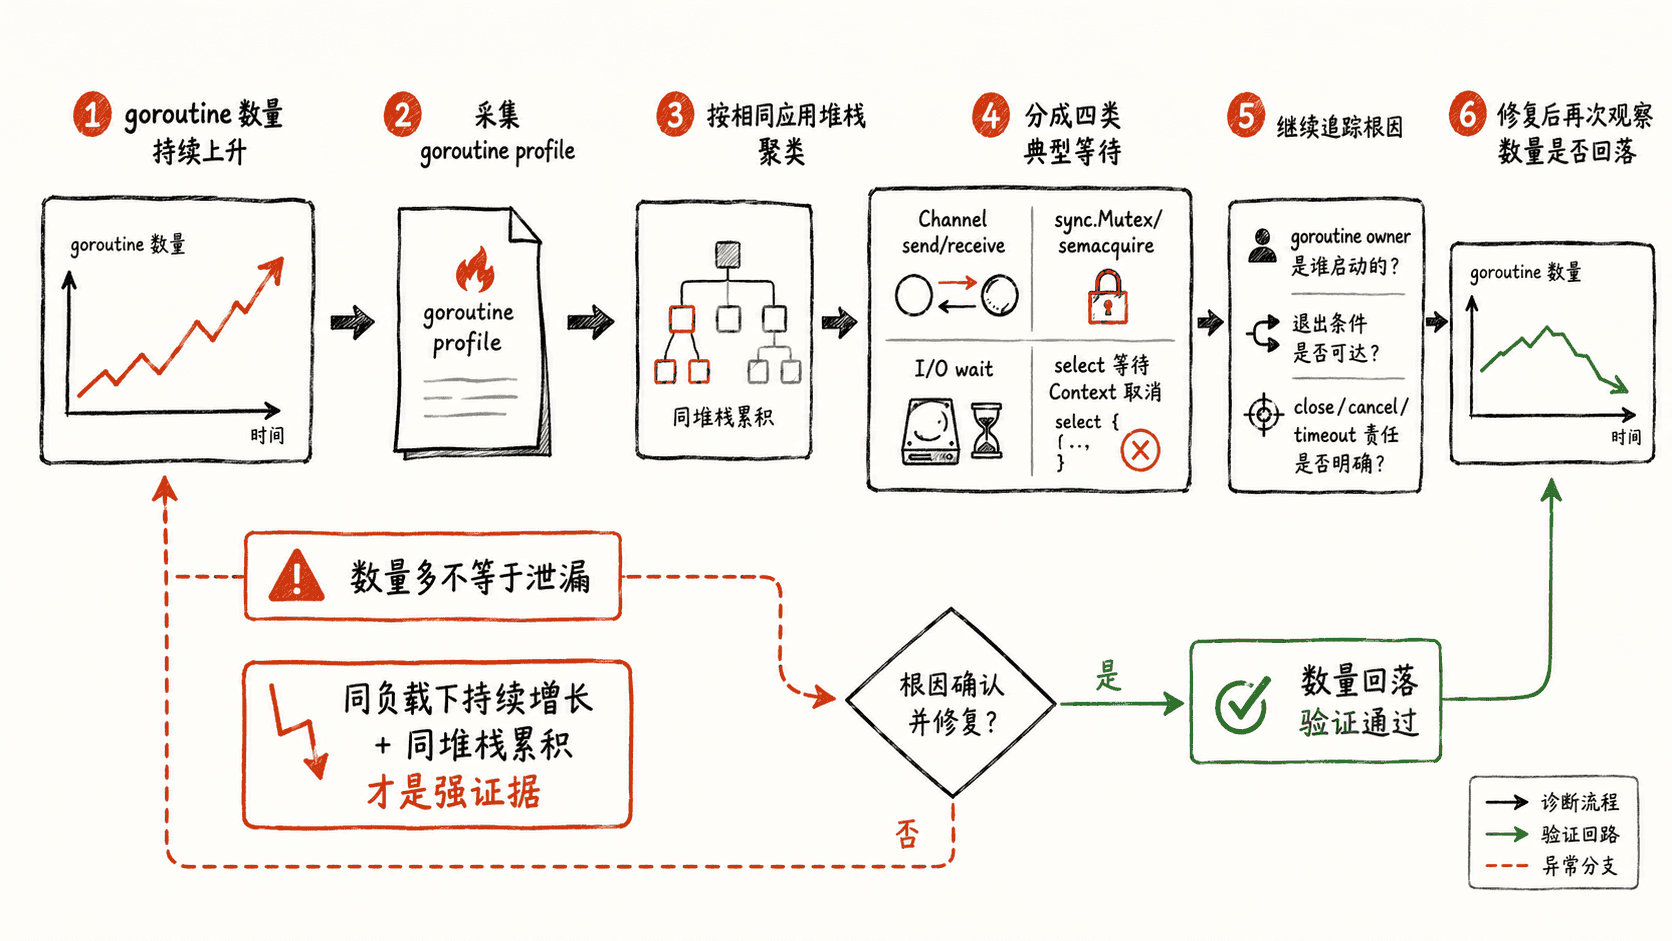
单次看到几千个 goroutine 不能直接判定泄漏。连接池、HTTP keep-alive、后台 worker 和并发峰值都可能让数量暂时升高。更可靠的信号是:在相近流量和负载下,goroutine 总数跨多个观察窗口单调上升,并且增长主要集中在同一组应用堆栈。
诊断时先取“健康基线”快照,再在问题窗口重复采集。聚类用于回答“哪类 goroutine 在增加”,完整堆栈用于回答“它为什么没有退出”。
构造并采集一个泄漏
下面的服务暴露标准 pprof 端点,并提供 /leak:每调用一次,就启动 100 个永远等待同一 Channel 的 goroutine。这是故意制造的错误,用于观察“数量增长 + 相同堆栈聚类”的形态。
package main

import (
    "fmt"
    "log"
    "net/http"
    _ "net/http/pprof"
)

var never = make(chan struct{})

func leak(w http.ResponseWriter, r *http.Request) {
    for i := 0; i < 100; i++ {
        // 没有任何发送方或 close,这些 goroutine 将永久阻塞。
        go func() {
            <-never
        }()
    }
    fmt.Fprintln(w, "spawned 100 blocked goroutines")
}

func main() {
    log.SetFlags(log.Ltime)
    http.HandleFunc("/leak", leak)
    log.Println("pprof listening on 127.0.0.1:6060")
    log.Fatal(http.ListenAndServe("127.0.0.1:6060", nil))
}
启动服务:
go run main.go预期输出:
<TIME> pprof listening on 127.0.0.1:6060保持服务运行,在另一个终端触发三次泄漏,再读取可读的聚合 Profile:
for i in 1 2 3; do curl -s http://localhost:6060/leak; done
curl -s 'http://localhost:6060/debug/pprof/goroutine?debug=1' | head -n 12
预期结果:
spawned 100 blocked goroutines
spawned 100 blocked goroutines
spawned 100 blocked goroutines
goroutine profile: total <VALUE>
300 @ <ADDRESS> <ADDRESS> <ADDRESS>
#   <ADDRESS>    main.leak.func1+<OFFSET>    <PATH>/main.go:<LINE>
...
总数 <VALUE> 会包含 HTTP、pprof 和运行时自身的 goroutine,因此不应强行等于 300;关键证据是 main.leak.func1 一组稳定累积到约 300 个。
先聚类,再看单个完整堆栈
go tool pprof 适合把相同调用路径聚合起来,先找“数量最大的应用堆栈”;debug=2 则按运行时崩溃转储的形式打印每个 goroutine,更适合查看 [chan receive]、[semacquire]、[IO wait] 等状态和完整调用链。
go tool pprof -top http://localhost:6060/debug/pprof/goroutine
curl -s 'http://localhost:6060/debug/pprof/goroutine?debug=2' | grep -B 1 -A 5 'main.leak.func1' | head
预期结果:
Type: goroutine
Showing nodes accounting for <VALUE>, <VALUE>% of <VALUE> total
...
<VALUE>  <VALUE>%  ...  runtime.gopark
...
goroutine <ID> [chan receive]:
main.leak.func1()
    <PATH>/main.go:<LINE> +<OFFSET>
created by main.leak in goroutine <ID>
    <PATH>/main.go:<LINE> +<OFFSET>
...
实际地址、行号和比例会变化。此时已经能确认泄漏不是“系统 goroutine 太多”,而是应用创建的 main.leak.func1 持续堆积。
按阻塞状态追根因
看到 Channel send/receive 时,检查配对方是否可能提前退出、Channel 是否应关闭,以及 goroutine 是否还有取消分支。只给 Channel 加缓冲通常只是推迟堆积,并没有建立退出协议。
看到 sync.Mutex.Lock、semacquire 一类栈时,先判断这是高竞争还是永久等待。若数量只随瞬时流量升降,可能是竞争;若同一批 goroutine 长时间不消失,则继续查持锁路径、遗漏的 Unlock、锁顺序和上游卡死。
看到 [IO wait] 时,要结合连接用途判断。长期监听 socket 的 goroutine 可以是正常常驻;请求级 goroutine 若长期停在读写,则检查 deadline、连接关闭、下游超时和取消传播。
看到 select 与 ctx.Done() 相关调用链时,不要只盯着 select。真正的问题常在 owner 没有执行 cancel()、后台 goroutine 使用了生命周期过长的 Context,或创建者退出后没有关闭输入源。泄漏修复的核心是明确“谁创建、谁停止、谁等待回收”。
用相同负载验证修复
修复后在相同请求模型下重复采集。正确结果不是 goroutine 永远保持某个固定数字,而是峰值后能回落到稳定区间,且原先持续增长的业务堆栈不再累积。若数量仍增长但热点换了堆栈,说明只修掉了一个泄漏源,需要继续按新的聚类重复定位。
Goroutine Profile 最有价值的用法不是浏览几百条堆栈,而是先用数量趋势证明“在增长”,再用聚类找到“哪一类在增长”,最后沿完整调用链追到 owner 和退出条件。这样才能把 Channel、锁、I/O 或 Context 上的等待从表面状态还原成真正的生命周期缺陷。