
Go / 系统课时
优化 Channel 与队列等待
优化 Channel 与队列等待
高并发服务出现吞吐下降或 p99 抖动时,问题常常不是“Channel 太慢”,而是生产速度、队列容量与消费能力失衡。本课用阻塞 Profile 和排队指标定位等待点,再用缓冲、worker 数与批处理逐项验证改动是否真的减少等待。
学习目标
- 用 Block Profile 判断 goroutine 是否主要阻塞在 Channel 发送或接收。
- 用队列深度和提交到开始处理的等待时间区分“短时突发”与“持续过载”。
- 根据证据调整缓冲、worker 数和批处理,并避免把拥塞隐藏进更大的队列。
先确认等待发生在哪里
Channel 阻塞通常有两种方向:生产者在发送时等待,说明消费速度跟不上;消费者长期等待接收,说明 worker 可能过多或上游供给不足。Block Profile 能告诉你同步阻塞时间集中在哪些调用栈,但它不能直接回答“队列积了多少任务”,因此要同时观察队列深度、入队速率、处理速率和任务等待时间。
对有缓冲 Channel,可以把 len(ch) 作为瞬时深度采样,但不要把它当成精确一致的控制条件。真正用于容量判断的指标应是持续采样后的分布,例如平均深度、接近容量上限的时间占比,以及任务从提交到 worker 开始处理的延迟。
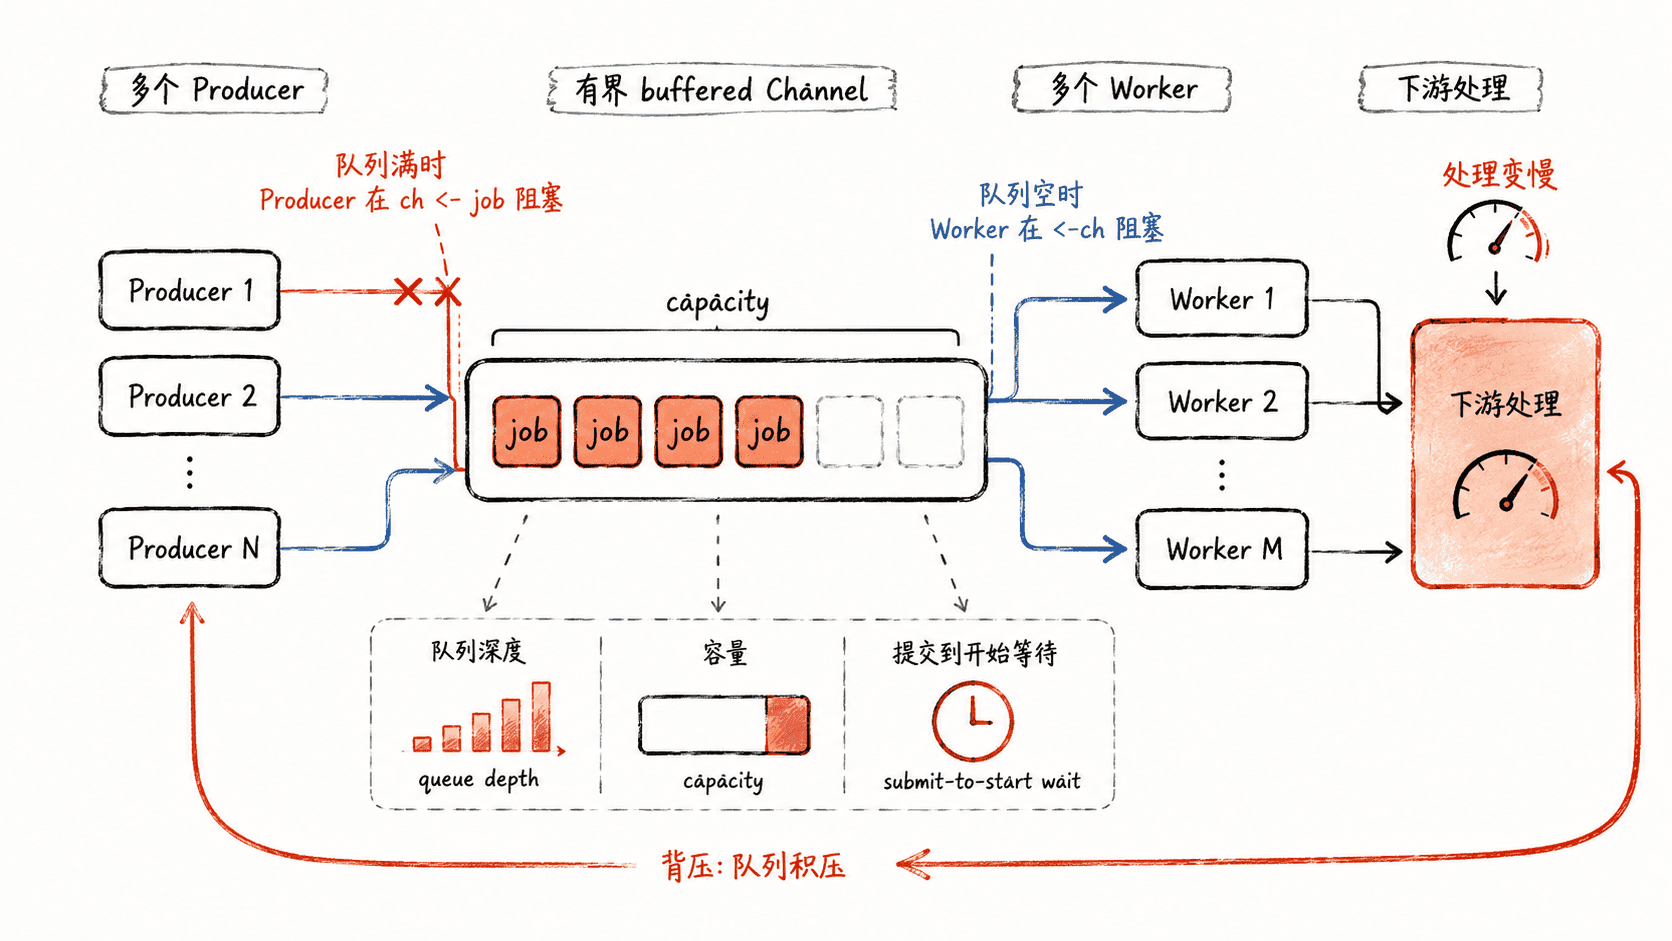
用 Block Profile 和排队指标定位
下面的测试故意让两个 worker 以固定速度消费 200 个任务。保存为 queue_wait_test.go,它会记录最大队列深度和“提交到 worker 开始处理”的平均等待时间;时间戳放在发送前,因此这个指标同时包含生产者被满队列阻塞的时间和任务进入缓冲后的排队时间。
package queuewait

import (
    "sync"
    "sync/atomic"
    "testing"
    "time"
)

type job struct {
    submittedAt time.Time
}

func updateMax(dst *atomic.Int64, v int64) {
    for {
        old := dst.Load()
        if v <= old || dst.CompareAndSwap(old, v) {
            return
        }
    }
}

func TestPipeline(t *testing.T) {
    const (
        totalJobs = 200
        workers   = 2
        queueSize = 8
    )

    jobs := make(chan job, queueSize)
    var wg sync.WaitGroup
    var totalWait atomic.Int64
    var samples atomic.Int64
    var maxDepth atomic.Int64

    for i := 0; i < workers; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            for j := range jobs {
                totalWait.Add(time.Since(j.submittedAt).Nanoseconds())
                samples.Add(1)

                // 模拟每个任务固定的服务时间,制造可观察的队列压力。
                time.Sleep(time.Millisecond)
            }
        }()
    }

    for i := 0; i < totalJobs; i++ {
        jobs <- job{submittedAt: time.Now()}
        updateMax(&maxDepth, int64(len(jobs)))
    }
    close(jobs)
    wg.Wait()

    avgWait := time.Duration(totalWait.Load() / samples.Load())
    t.Logf("avg_submit_to_start=%s max_queue_depth=%d", avgWait, maxDepth.Load())
}
运行测试并开启阻塞 Profile:
go test -v -run '^TestPipeline$' -count=1 -blockprofile=block.out -blockprofilerate=1预期输出如下,耗时和平均等待时间会因机器调度而变化;测试里的最大队列深度不会超过容量 8:
=== RUN   TestPipeline
    queue_wait_test.go:<LINE>: avg_submit_to_start=<VALUE> max_queue_depth=<VALUE>
--- PASS: TestPipeline (<TIME>s)
PASS
ok      queuewait      <TIME>s
再查看阻塞时间主要落在哪些调用栈:
go tool pprof -top block.out预期输出中应能看到与 Channel 发送等待相关的栈;具体占比属于动态值:
Type: delay
Showing nodes accounting for <VALUE>, <VALUE>% of <VALUE> total
      flat  flat%   sum%        cum   cum%
   <VALUE> <VALUE>% <VALUE>%   <VALUE> <VALUE>%  runtime.chansend1
如果 runtime.chansend1 或业务发送函数占据主要阻塞时间,同时队列深度经常贴近容量上限,就应优先处理消费能力或背压,而不是先把 Channel 改得更大。
按瓶颈类型调整参数
缓冲大小解决的是短时速率不匹配。把容量从 8 增到 800 可能让生产者暂时不阻塞,却会把等待转移到队列内部,并抬高尾延迟和内存占用。调整缓冲后,要同时检查吞吐、p95/p99、队列深度分布和任务等待时间。
增加 worker 只在下游仍有可用并行度时有效。CPU 密集任务若已经占满可用核心,继续加 worker 往往只增加调度和缓存竞争;I/O 任务则要看连接池、远端限流和下游并发上限,避免把压力继续放大。
批处理适合“每次调用有固定成本”的场景,例如日志写入、数据库批量写或网络发送。批量越大,单位任务开销通常越低,但首个任务需要等待凑批。生产环境常用“达到批量大小或达到最大等待时间,任一满足就发送”的双触发策略控制尾延迟。
用单变量实验验收
每次只改一个变量,例如先只调整 queueSize,再只调整 worker 数,最后评估批处理。对每组配置使用同一份请求分布和并发度,至少比较吞吐、p99、Block Profile 总阻塞时间、最大或高分位队列深度,以及提交到开始处理的等待时间。
当阻塞时间下降但 p99 反而上升时,通常说明等待只是从“发送阻塞”转移到了“队列内部”;当 worker 增加后 CPU 或下游连接池先打满,则说明新的并行度超过了系统真正的服务能力。优化的终点不是让 Channel 看起来更忙,而是让等待发生在可控位置,并让服务在目标吞吐下保持稳定尾延迟。