
Go / 系统课时
用压测验证容量与回归
用压测验证容量与回归
性能优化是否有效,不能靠一次峰值 QPS 下结论。本篇用阶梯压测寻找容量拐点,再用稳定压测验证持续运行状态,并把吞吐、P95/P99、CPU、内存和错误率转成可执行的回归门槛。
学习目标
- 能设计阶梯压测,识别吞吐不再增长而尾延迟开始恶化的容量拐点。
- 能用稳定压测验证目标负载下的 CPU、内存、错误率和延迟是否可持续。
- 能把基线结果写成明确的性能回归判定条件。
用阶梯负载找容量拐点
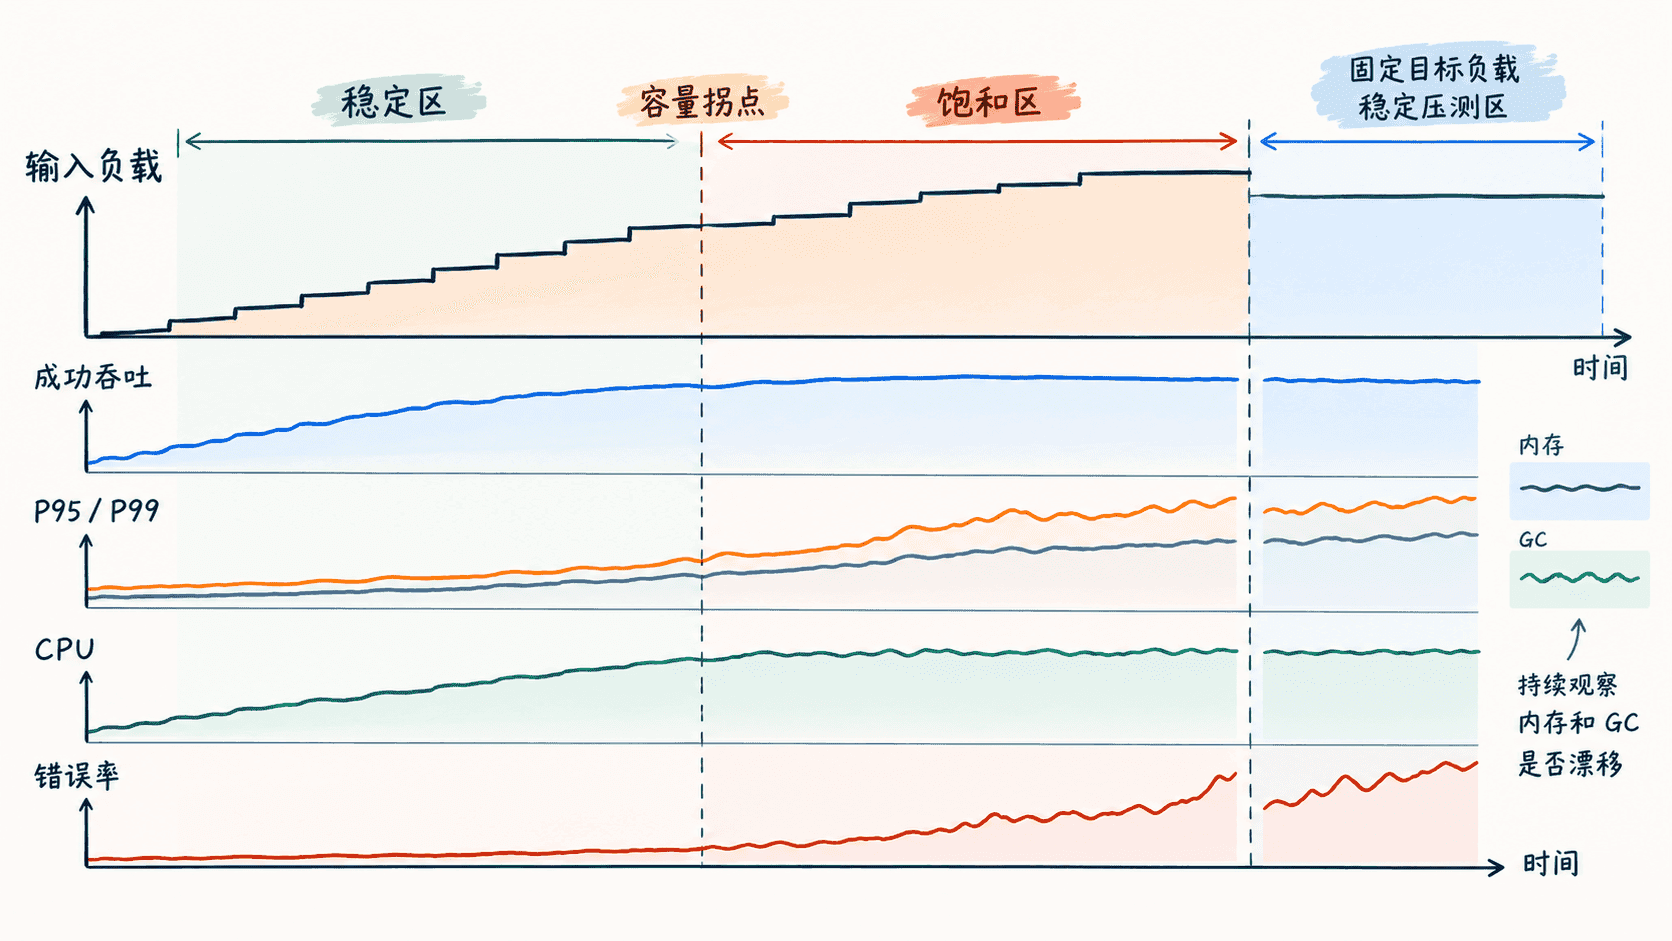
阶梯压测不要一开始就冲到极限。先从明显低于预期容量的负载开始,每个台阶保持足够时间让连接池、GC 和缓存进入相对稳定状态,再逐步提高并发或请求速率。
重点观察“吞吐是否还随负载增长”。当输入负载继续升高,但成功吞吐增长很小,同时 P95/P99、错误率或 CPU 快速上升,通常已经进入饱和区。容量目标应留在拐点之前,而不是把拐点本身当成可长期运行值。
用可重复脚本固定压测步骤
下面的程序对目标地址执行三个 5 秒台阶,分别维持 20、50、100 个并发 worker,并统计成功数、错误数与 P95/P99。它不是生产级压测器,但足以演示“固定台阶、固定持续时间、统一统计口径”的方法。
package main

import (
    "fmt"
    "io"
    "net/http"
    "os"
    "sort"
    "sync"
    "sync/atomic"
    "time"
)

func percentile(values []time.Duration, p float64) time.Duration {
    sort.Slice(values, func(i, j int) bool { return values[i] < values[j] })
    if len(values) == 0 {
        return 0
    }
    index := int(float64(len(values)-1) * p)
    return values[index]
}

func runStep(client *http.Client, url string, workers int, duration time.Duration) {
    deadline := time.Now().Add(duration)
    var ok, failed atomic.Int64
    var mu sync.Mutex
    latencies := make([]time.Duration, 0, workers*100)
    var wg sync.WaitGroup

    for i := 0; i < workers; i++ {
        wg.Add(1)
        go func() {
            defer wg.Done()
            for time.Now().Before(deadline) {
                start := time.Now()
                resp, err := client.Get(url)
                if err != nil {
                    failed.Add(1)
                    continue
                }
                _, _ = io.Copy(io.Discard, resp.Body)
                resp.Body.Close()

                if resp.StatusCode >= 200 && resp.StatusCode < 300 {
                    ok.Add(1)
                } else {
                    failed.Add(1)
                }
                mu.Lock()
                latencies = append(latencies, time.Since(start))
                mu.Unlock()
            }
        }()
    }
    wg.Wait()

    mu.Lock()
    p95 := percentile(latencies, 0.95)
    p99 := percentile(latencies, 0.99)
    mu.Unlock()

    fmt.Printf("workers=%d ok=%d failed=%d p95=%s p99=%s\n",
        workers, ok.Load(), failed.Load(), p95, p99)
}

func main() {
    if len(os.Args) != 2 {
        fmt.Println("usage: go run load.go <URL>")
        return
    }
    client := &http.Client{Timeout: 2 * time.Second}
    for _, workers := range []int{20, 50, 100} {
        runStep(client, os.Args[1], workers, 5*time.Second)
    }
}
预期结果
保存为 load.go 后可直接由 Go 工具链编译并运行;运行时需要传入目标 URL。运行命令
go run load.go http://127.0.0.1:<PORT>/health预期输出
workers=20 ok=<VALUE> failed=<VALUE> p95=<VALUE> p99=<VALUE>
workers=50 ok=<VALUE> failed=<VALUE> p95=<VALUE> p99=<VALUE>
workers=100 ok=<VALUE> failed=<VALUE> p95=<VALUE> p99=<VALUE>
实际数值取决于机器、服务实现和 <PORT>。这个客户端按并发 worker 驱动负载,不保证固定 RPS,因此比较时必须保持机器、目标地址、构建版本和运行时环境一致。
稳定压测要看资源是否漂移
找到拐点后,选择低于拐点且符合业务目标的负载做稳定压测。持续时间应覆盖连接复用、GC 周期、缓存刷新和后台任务等长期行为;短到只跑几十秒,往往看不出内存增长、泄漏或周期性抖动。
服务端至少同时采集成功吞吐、P95/P99、错误率、CPU、RSS 或堆内存、GC 次数与暂停。资源指标应来自被测服务所在节点或容器,不要拿压测客户端 CPU 代替服务端 CPU,否则会把发生在不同机器上的瓶颈混在一起。
把结果变成回归门槛
回归门槛必须绑定相同测试场景,并尽量使用相对变化与绝对上限结合的方式。例如:在固定请求集合、固定并发和固定机器规格下,成功吞吐不得下降超过 5%,P95 不得上升超过 10%,P99 不得超过业务绝对上限,错误率必须低于既定阈值,CPU 与内存不能出现不可解释的显著上升。
不要只用平均延迟做门禁。平均值可能在少量极慢请求出现时仍然看起来正常,而 P99 更容易暴露排队、锁竞争、GC 抖动和下游超时。容量回归也不要只看 QPS;如果吞吐相同但 CPU 从 55% 升到 85%,实际上已经损失了大量安全余量。
保证前后结果可比较
每次压测都记录代码版本、Go 版本、机器规格、环境变量、目标数据规模、并发模型、预热时间、台阶持续时间和服务端关键配置。只要这些条件发生变化,结果就不应直接与旧基线做一比一判断。
建立基线之后,优化工作的验收就有了明确规则:先证明在相同负载下延迟或资源占用下降,再证明容量拐点没有提前,最后用稳定压测确认长期指标不漂移。这样得到的“变快”才是可重复、可回归、可上线的性能改进。