
Go / 系统课时
识别高并发服务的瓶颈类型
识别高并发服务的瓶颈类型
高并发服务变慢时,首先要判断瓶颈属于 CPU、阻塞、锁竞争、调度拥塞、内存分配还是 GC;只有先分类,后续 profile 和优化才不会走错方向。
学习目标
- 根据症状建立第一轮瓶颈分类,而不是看到延迟升高就盲目加机器
- 用 CPU、阻塞、trace、heap 与 GC 证据区分相似问题
- 找到主要瓶颈后选择最小代价的验证实验
先看资源曲线,再看代码
高并发问题常见的误判是把“CPU 高”当成唯一原因。实际上 CPU 饱和、锁竞争和调度拥塞都可能伴随高 CPU,而网络、磁盘、channel、条件变量等待又可能让吞吐下降但 CPU 并不高。
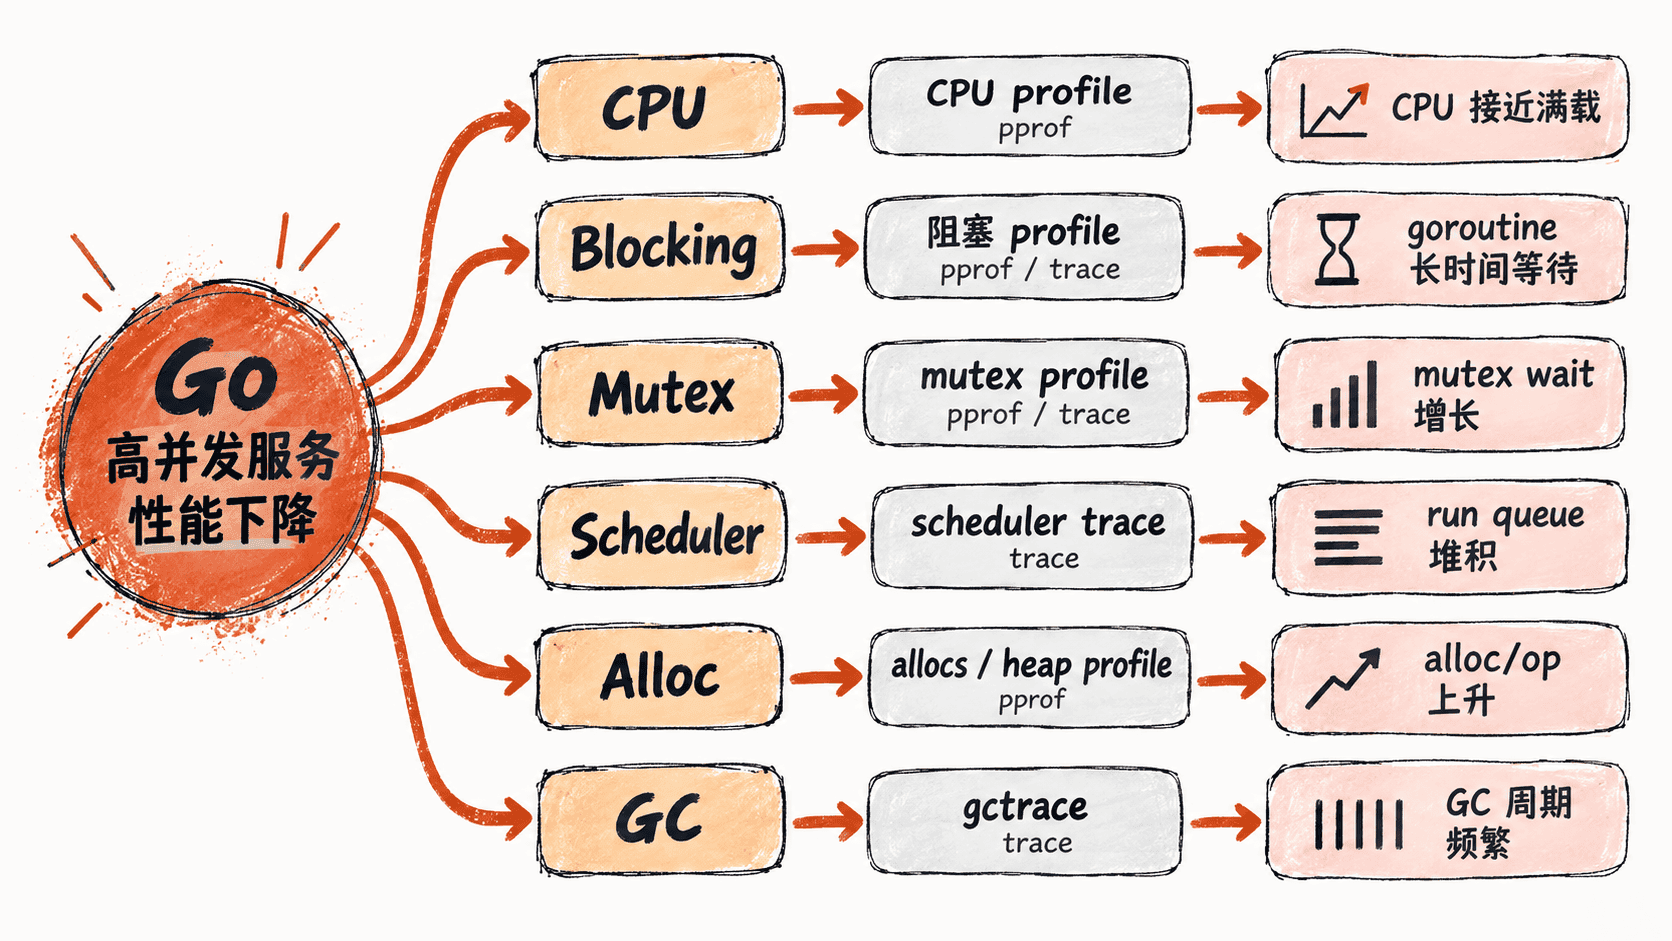
CPU 饱和的典型特征是运行队列不断有工作、CPU 使用率接近上限,并且 CPU profile 能指出具体热点函数。此时优化算法、减少重复计算或降低不必要的 goroutine 工作,通常比增加同步机制更直接。
阻塞则相反:大量 goroutine 可能处于等待状态,CPU 利用率并不高。阻塞来源可能是网络、磁盘、channel、条件变量或系统调用。execution trace 能把 goroutine 的阻塞与唤醒过程放到时间线上观察。Go 的诊断指南将 profiling 用于成本热点分析,而 tracing 更适合分析请求或调用生命周期中的等待。:contentReference[oaicite:8]{index=8}
区分锁竞争与调度拥塞
锁竞争的核心是“多个执行单元争同一把锁”。如果临界区很短但请求量极大,mutex 等待时间可能迅速累积。调度拥塞则是“可运行的工作太多”,例如创建过量 goroutine、频繁唤醒或存在大量短任务,使调度本身成为成本。
两者可以同时发生,因此不要只凭 goroutine 数判断。更可靠的方法是先观察 trace,再针对怀疑点做单变量实验:减少锁持有时间验证锁竞争,或者限制并发工作数验证调度压力。
可以先用一个最小程序验证 CPU 并发度变化:
package main

import (
	"fmt"
	"runtime"
)

func main() {
	fmt.Printf("NumCPU=%d GOMAXPROCS=%d\n", runtime.NumCPU(), runtime.GOMAXPROCS(0))
}
运行:
GOMAXPROCS=2 go run .预期结果:
NumCPU=<N> GOMAXPROCS=2这个实验只能说明运行时允许的处理器并行度,不能单独证明存在调度瓶颈。真正判断调度问题,应把它和 trace 中的 runnable goroutine、P/线程活动以及等待区间一起看。
识别内存分配与 GC 压力
内存问题也容易被误诊为 CPU 问题。高分配率会增加 allocator、写屏障和 GC 工作量,表现上可能既有 alloc/op 上升,也有 CPU 使用率增加。
判断时至少回答两个问题:对象分配是否真的很多,以及 GC 工作是否已经成为主要耗时。heap profile 更适合观察内存分配样本,GC 事件和 execution trace 则用于观察回收节奏及其对执行时间的影响。:contentReference[oaicite:9]{index=9}
不要把“堆变大”直接等同于“GC 压力大”。一个服务可能保留大量长期存活对象,却没有频繁分配;另一个服务堆并不大,却因为短命对象分配过快而频繁触发 GC。分类的关键是看分配速率、存活对象和 GC 工作量三组证据。
建立最短定位顺序
线上发现延迟或吞吐异常时,可以按照“先宽后窄”的顺序排查:先确认 CPU、内存和 I/O 是否存在明显异常,再用 CPU profile 判断计算热点;如果 CPU 不高,则转向阻塞与 trace;若等待集中在共享资源,再验证 mutex 或其他同步竞争;最后检查分配速率与 GC。
每次只改变一个变量。例如怀疑锁竞争,就先缩小临界区或降低竞争者数量,再复测等待时间;怀疑调度拥塞,就限制 goroutine 并发度并观察吞吐、延迟和 trace 是否同步改善。这样才能把“相关性”推进到“因果验证”。
高并发性能治理真正需要的是证据链:**资源异常说明哪里不对,profile 说明什么代码在付出成本,trace 说明这些成本何时发生,控制变量实验则验证为什么发生。**完成这条链路后,优化动作才有明确目标。