
Go / 系统课时
理解 Goroutine 栈增长
理解 Goroutine 栈增长
Goroutine 能以很小的栈启动,并在调用深度增加时按需扩容,因此创建大量 Goroutine 并不等于一次性预留线程级大栈。本篇会把初始栈、扩容复制、收缩时机和实际内存观测串起来,最后能判断 Goroutine 数量为什么会影响内存与 GC 成本。
学习目标
- 解释 Goroutine 用户栈从小栈启动、按需增长与按条件收缩的机制。
- 理解栈复制为什么能让 Goroutine 保持连续栈,同时识别深调用和大栈帧的成本。
- 使用
runtime.MemStats.StackInuse观察大量 Goroutine 的栈内存变化。
小栈不是固定的 2 KiB
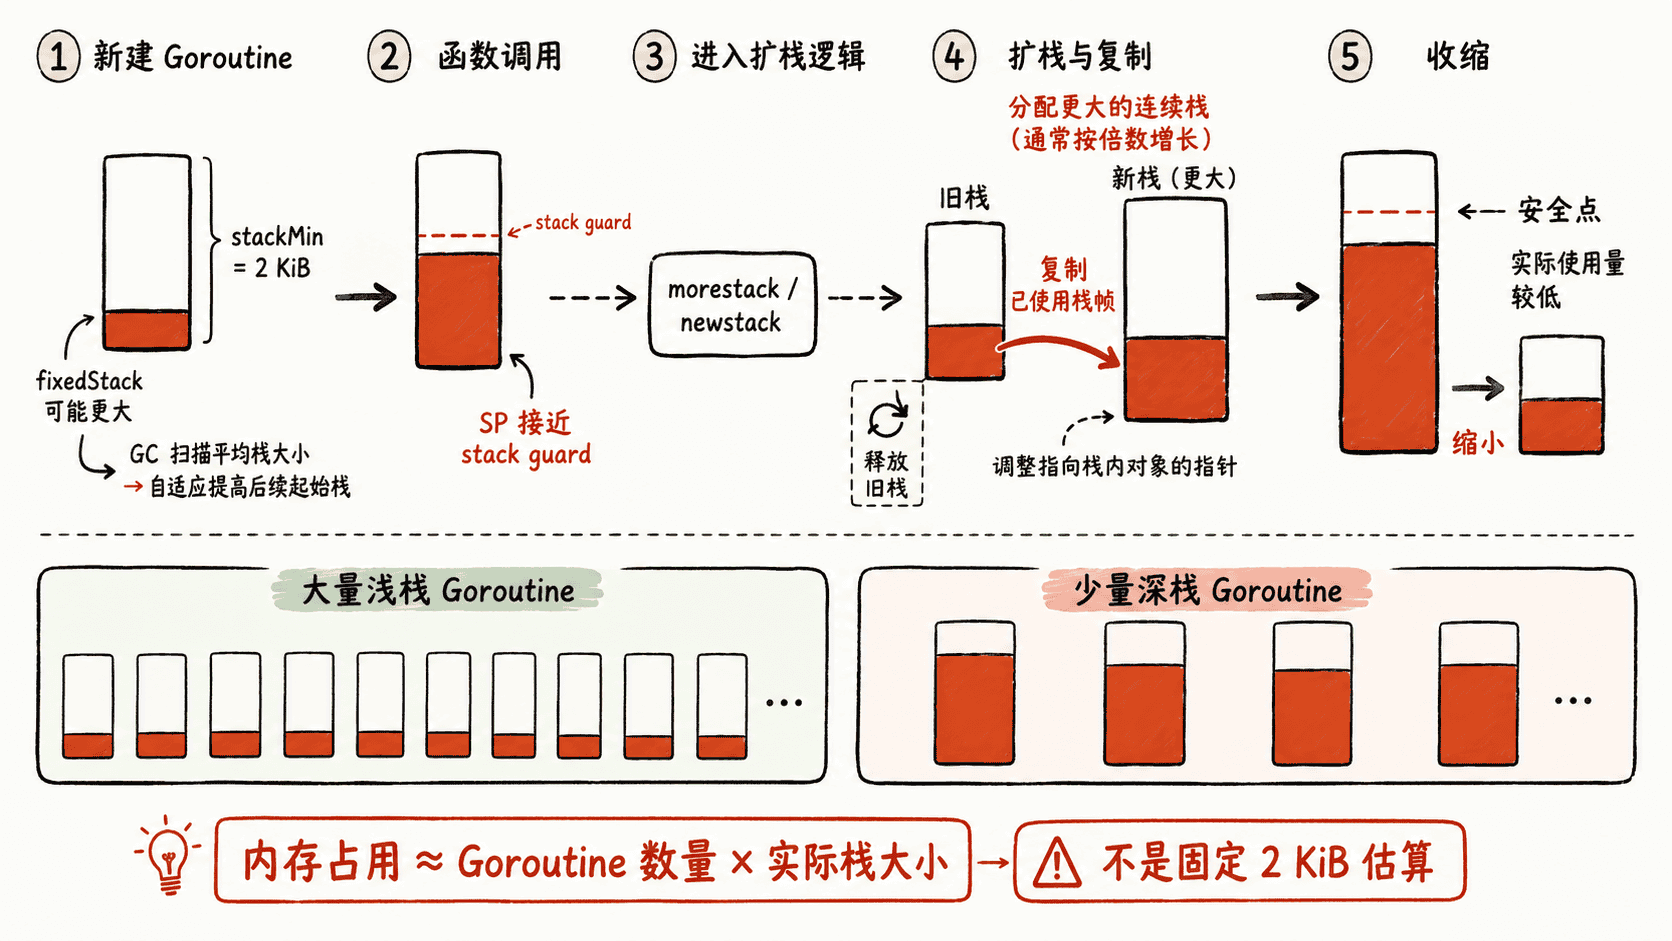
Go 运行时为每个存活 Goroutine 维护用户栈。当前运行时源码把 Go 代码的 stackMin 定义为 2 KiB,但实际分配还会受平台附加空间和自适应起始策略影响,因此不能理解为“每个 Goroutine 永远占 2 KiB”。运行时会在 GC 后根据扫描到的平均栈大小调整后续新 Goroutine 的起始栈,以减少频繁扩容。
这套策略的关键是按实际调用深度付费:浅调用 Goroutine 通常保持较小栈,递归较深、局部变量较大或长期阻塞在深层调用中的 Goroutine 会保留更大的有效栈。Goroutine 数量上升时,真正要估算的是“数量 × 实际栈规模”,而不是简单乘固定常数。
栈如何增长与收缩
函数进入前会进行栈边界检查。当剩余空间不足以安全执行新栈帧时,运行时进入扩栈路径,通常按倍数增大连续栈空间,把当前仍在使用的栈内容复制到新位置,并修正指向栈内对象的相关指针,然后释放旧栈。这样既保留连续栈的访问效率,也不要求一开始就预留很大的空间。
当深层调用返回后,栈不会因为每次函数返回就立刻缩小。运行时只会在安全条件满足时尝试收缩;当前实现会在已用空间明显低于当前栈容量时把栈缩小,但不会低于最小固定栈。增长和收缩都意味着运行时工作,因此频繁制造很深的栈峰值并不是免费的。
用实验观察栈内存
下面的程序启动 500 个 Goroutine,并让它们在 16 层递归的最深处阻塞。每层保留一个 1 KiB 局部数组,使这些 Goroutine 必须维持较深的活动栈;释放它们并等待退出后,再强制一次 GC 观察栈内存回落。
package main

import (
	"fmt"
	"runtime"
	"sync"
)

const (
	workers = 500
	depth   = 16
)

func deep(n int, ready chan<- struct{}, release <-chan struct{}) byte {
	var pad [1024]byte
	pad[0] = byte(n)
	pad[len(pad)-1] = byte(n + 1)

	if n == 0 {
		ready <- struct{}{}
		<-release
		return pad[0] + pad[len(pad)-1]
	}
	v := deep(n-1, ready, release)
	return v + pad[0] + pad[len(pad)-1]
}

func stackInuseKiB() uint64 {
	var m runtime.MemStats
	runtime.ReadMemStats(&m)
	return m.StackInuse / 1024
}

func main() {
	ready := make(chan struct{}, workers)
	release := make(chan struct{})
	var wg sync.WaitGroup
	wg.Add(workers)

	for i := 0; i < workers; i++ {
		go func() {
			defer wg.Done()
			_ = deep(depth, ready, release)
		}()
	}

	for i := 0; i < workers; i++ {
		<-ready
	}
	fmt.Printf("blocked goroutines=%d stack_inuse=%d KiB\n",
		runtime.NumGoroutine(), stackInuseKiB())

	close(release)
	wg.Wait()
	runtime.GC()
	fmt.Printf("after exit goroutines=%d stack_inuse=%d KiB\n",
		runtime.NumGoroutine(), stackInuseKiB())
}
预期输出
blocked goroutines=<VALUE> stack_inuse=<VALUE> KiB
after exit goroutines=<VALUE> stack_inuse=<VALUE> KiB
<VALUE> 会随 Go 版本、平台和运行时状态变化;应关注第一行的 StackInuse 明显高于 Goroutine 退出并 GC 后的第二行。StackInuse 统计的是正在使用的栈 span 字节数,并不等于逐个 Goroutine 精确相加后的逻辑栈大小,因此它适合做趋势和容量对比,不适合反推单个 Goroutine 的固定开销。
判断 Goroutine 数量的真实成本
大量 Goroutine 本身通常不是问题,问题是它们是否同时持有深调用链、大栈帧或长时间阻塞。若服务内存随着并发数上升而显著增长,应同时查看 Goroutine 数量、StackInuse、阻塞位置和调用深度,而不是只盯堆内存。
可以优先减少“深层阻塞”:如果某个 Goroutine 在完成深层计算后还要等待事件,尽量先返回到更浅的调用层再等待;对确实需要大量并发的工作,再配合并发上限控制峰值。这样既降低栈占用,也减少 GC 扫描大量活动栈时需要处理的指针范围。