
Go / 系统课时
区分 CPU 饱和与调度拥塞
区分 CPU 饱和与调度拥塞
线上吞吐下降、P99 升高时,CPU 高并不等于“机器算力不够”。本课用 CPU Profile、execution trace、Goroutine 状态与调度延迟交叉判断主要矛盾,避免把锁竞争、Runnable 堆积或阻塞问题误当成扩容问题。
学习目标
- 用多类证据区分 CPU 计算饱和、调度拥塞与阻塞等待
- 能采集 CPU Profile 与 trace,并从调度延迟视角验证结论
- 根据诊断结果选择优化计算、降低并发或治理竞争的动作
先把三种现象分开
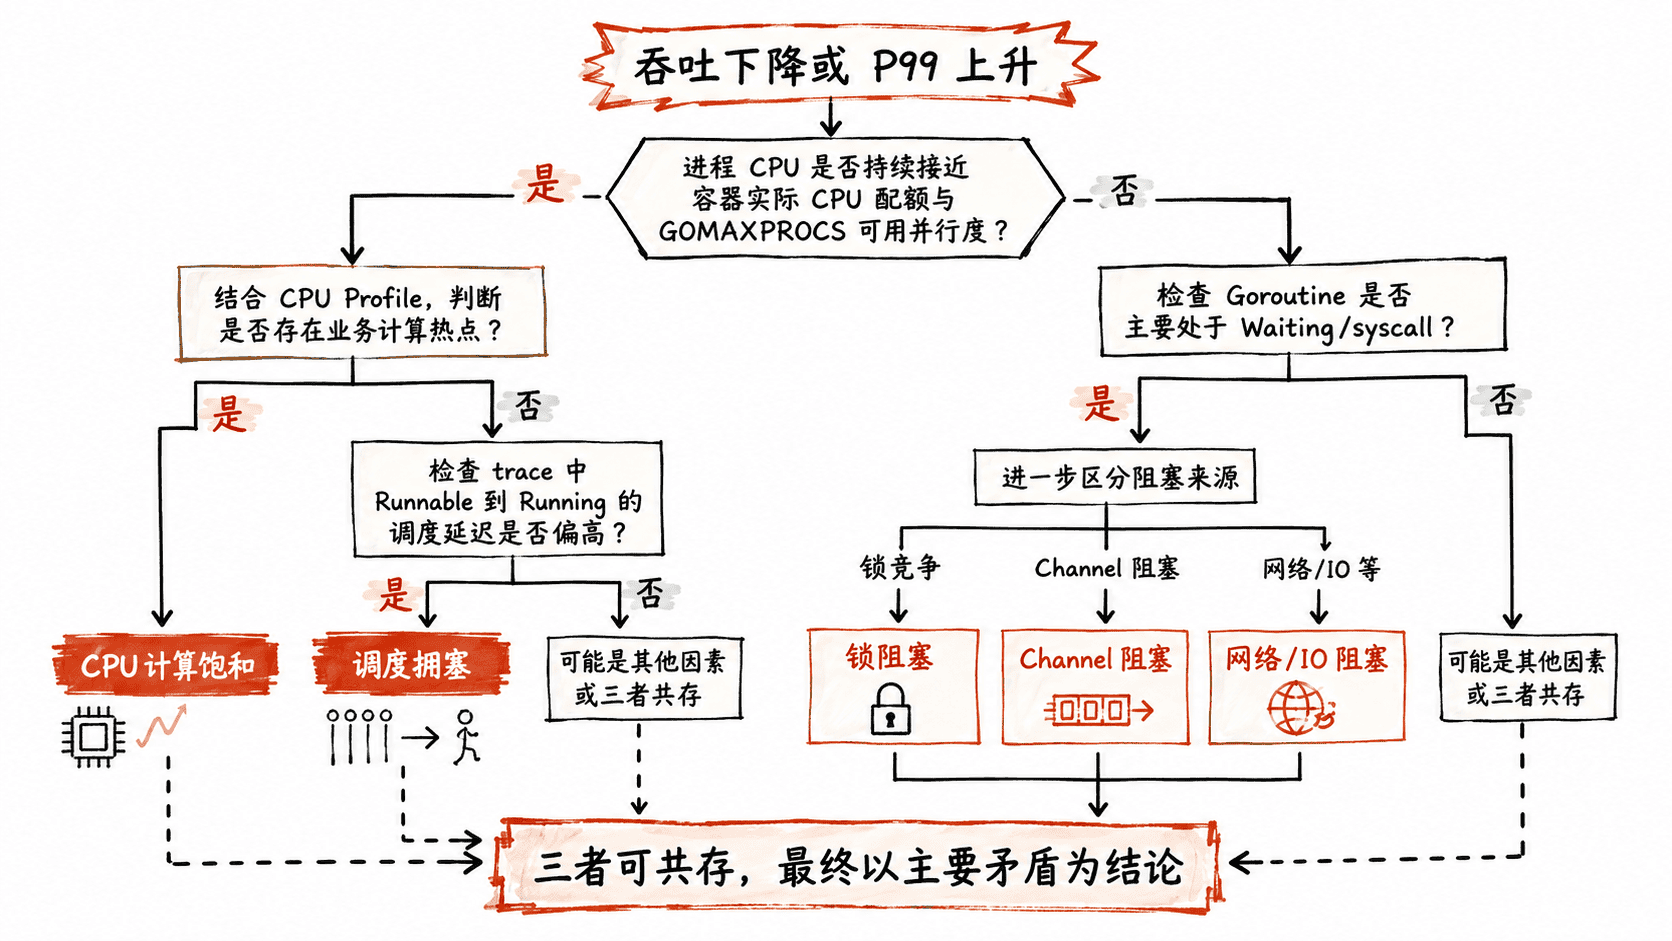
CPU 饱和指进程长期逼近可用 CPU 配额,真正的计算工作占满执行资源;调度拥塞指大量 Goroutine 已经可以运行,却迟迟拿不到 P 执行;阻塞等待则是 Goroutine 停在网络、系统调用、Channel 或锁上,本身并不处于 Runnable 状态。三者可以同时出现,因此要判断主要矛盾,不能只看一个 CPU 百分比。
| 证据 | CPU 计算饱和 | 调度拥塞 | 阻塞等待 |
|---|---|---|---|
| 进程 CPU | 持续接近可用上限 | 可高可中等 | 常低于上限 |
| CPU Profile | 少数计算函数占比高 | 未必有明显业务计算热点 | 通常解释不了主要延迟 |
| trace 调度延迟 | 可能升高但不是主因 | Runnable 到 Running 等待明显 | 主要时间在阻塞区间 |
| Goroutine 状态 | Running 较多 | Runnable 堆积 | Waiting、syscall 等状态较多 |
容器环境要用实际 CPU 配额与进程可用并行度解释“100%”。例如容器只获 2 核配额时,进程已用满这 2 核就是饱和,不应拿宿主机总核数作分母。
采集同一时间窗的证据
前提是服务只在受控管理端口启用 net/http/pprof,不要把调试端点暴露到公网。尽量在同一个异常时间窗采集 CPU Profile 和短 trace,否则两个样本可能对应不同负载状态。
curl -fsS -o cpu.pprof 'http://127.0.0.1:6060/debug/pprof/profile?seconds=30'
curl -fsS -o trace.out 'http://127.0.0.1:6060/debug/pprof/trace?seconds=5'
go tool pprof -top cpu.pprof
go tool trace -pprof=sched trace.out > sched.pprof
go tool pprof -top sched.pprof
预期输出
Showing nodes accounting for <VALUE>s, <VALUE>% of <VALUE>s total
      flat  flat%   sum%        cum   cum%  name
   <VALUE> <VALUE> <VALUE>    <VALUE> <VALUE> <FUNCTION>
...
Showing nodes accounting for <VALUE>s, <VALUE>% of <VALUE>s total
      flat  flat%   sum%        cum   cum%  name
   <VALUE> <VALUE> <VALUE>    <VALUE> <VALUE> <FUNCTION>
第一段 top 来自 CPU Profile,关注真正消耗 CPU 的函数;第二段来自 trace 的 sched 延迟 Profile,关注 Goroutine 已可运行后等待调度的时间。<VALUE>、<FUNCTION> 会随程序与负载变化,不能把示例中的占位符当成固定阈值。
按证据组合下结论
如果 CPU 持续贴近上限,CPU Profile 又集中在 JSON 编解码、压缩、加密、排序或业务循环等计算函数,而调度延迟没有异常放大,优先按算力或算法瓶颈处理:降低单请求计算量、减少复制与转换、优化热点算法,确认无效计算后再考虑增加 CPU。
如果 CPU 不一定满,但 trace 中 Runnable 到 Running 的等待显著增长,同时大量 Goroutine 被频繁唤醒,说明执行机会竞争比计算本身更值得关注。常见诱因是无上限地创建 Goroutine、过细任务切分、频繁 Channel 唤醒或并发度远高于可用 P;处理方向是限制并发、增大任务粒度并减少无效唤醒。
如果大量 Goroutine 长时间停在 mutex、Channel、网络或 syscall,CPU Profile 往往看不到与 P99 等量级的热点。这属于阻塞或资源竞争,应继续看 mutex/block Profile、网络依赖和系统调用,而不是用“加核”掩盖等待。
用一次改动验证因果
诊断完成后只改一个变量再复测。例如把入口并发上限降低 30%,若 CPU 下降不多但调度延迟和 P99 明显收敛,说明过度并发是重要因素;若调度延迟变化很小而 CPU 与吞吐仍线性受限,则更像计算饱和。
最终判断必须能形成闭环:同一异常窗口的指标显示问题,Profile 或 trace 给出机制证据,单变量修改后 P99、吞吐和对应证据同步改善。只有三者一致,才足以把“CPU 高”归因到真正的瓶颈。