
Go / 系统课时
理解本地队列与 Work Stealing
理解本地队列与 Work Stealing
只有 G-M-P 还不足以解释“很多 Goroutine 为什么能分摊到多个 P 上”。本课聚焦本地运行队列、全局队列与 Work Stealing,说明调度器如何降低共享队列竞争,并在负载不均时重新平衡可运行任务。
学习目标
- 说明为什么每个 P 都维护本地可运行队列,以及全局队列承担什么补充职责
- 理解空闲 P 通过 Work Stealing 获取任务的基本思路
- 判断队列不均、CPU 饱和和公平性对调度延迟可能造成的影响
本地队列为什么是快路径
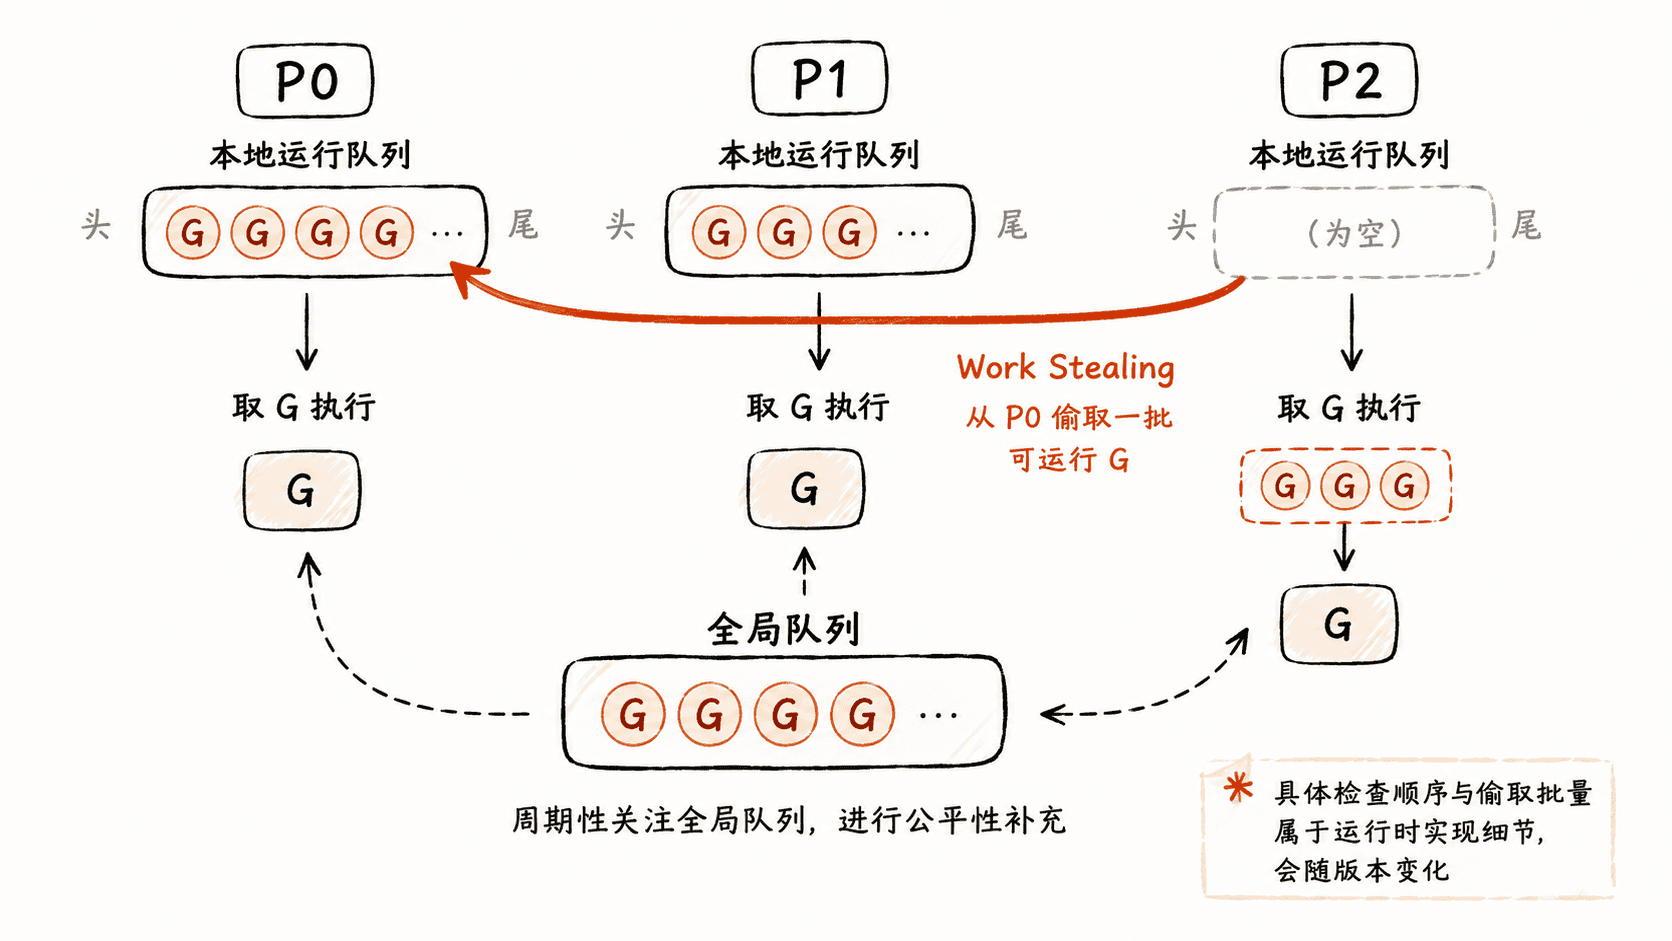
如果所有 runnable G 都竞争一个全局队列,每次入队和出队都会形成高频共享同步。Go 运行时因此让每个 P 维护本地运行队列:新任务和刚变为 runnable 的任务可以优先在局部流转,既减少共享竞争,也更有利于缓存局部性。
全局队列并没有消失。它承担跨 P 共享和公平性补充等职责,本地队列无法直接容纳或需要全局注入的任务也可能进入这里。调度器会周期性关注全局可运行任务,避免某个 P 的本地任务持续占据快路径而让全局任务长期得不到执行。
空闲 P 怎样重新找到工作
Work Stealing 的目标不是“随机搬家”,而是避免某个 P 没事做、另一个 P 的队列却排着大量 G。概念上,空闲 P 在自己的队列没有任务后,会继续寻找可运行工作;来源可能包括全局队列、网络轮询结果以及其他 P 的本地队列。
从其他 P 获取任务时,运行时会尝试批量偷取一部分 runnable G,而不是每次只抢一个,这样可以降低反复同步的成本并尽快形成新的本地工作集。不同 Go 版本对查找顺序、随机化和批量策略可能调整,因此不应把某个源码版本中的固定常量当成语言规范。
公平性为什么会影响尾延迟
本地队列提高吞吐,但如果调度器永远只消费本地任务,某些进入全局队列的 G 可能等待过久。因此运行时会穿插全局队列检查等公平性机制,让不同来源的 runnable G 都有机会进入执行。
Work Stealing 解决的是负载分布不均,不等于所有 G 都会立刻公平执行。CPU 已满载、单个 G 长时间占用处理器、锁竞争让大量 G 频繁唤醒,都会放大 runnable 排队时间。现代 Go 还会使用抢占机制缩短长时间运行 G 对其他任务的影响,但尾延迟最终仍取决于工作量、同步模式和系统负载。
用执行跟踪观察调度分布
下面的程序固定两个 P,启动 8 个 CPU 计算任务,并生成 trace.out。这个实验不能直接给每次 Work Stealing 打标签,但可以在 trace 中观察 Goroutine 的 runnable/running 状态以及任务如何分布到不同 P 上。
package main

import (
	"fmt"
	"os"
	"runtime"
	"runtime/trace"
	"sync"
)

func burn(seed int) {
	x := seed
	for i := 0; i < 2_000_000; i++ {
		x = (x*33 + i) ^ seed
	}
	if x == -1 {
		fmt.Println(x)
	}
}

func main() {
	// 固定两个 P,让多个 CPU 任务竞争有限的并行执行槽。
	runtime.GOMAXPROCS(2)

	f, err := os.Create("trace.out")
	if err != nil {
		panic(err)
	}
	// trace 会记录 Goroutine 状态变化和 P 上的执行活动。
	if err := trace.Start(f); err != nil {
		panic(err)
	}

	var wg sync.WaitGroup
	// 启动多于 P 数量的 runnable 工作,制造可观察的调度竞争。
	for i := 0; i < 8; i++ {
		wg.Add(1)
		go func(id int) {
			defer wg.Done()
			burn(id)
		}(i)
	}
	wg.Wait()

	// 先停止跟踪再关闭文件,确保尾部事件完整写入。
	trace.Stop()
	if err := f.Close(); err != nil {
		panic(err)
	}
	fmt.Println("trace written")
}
预期输出:
trace written程序结束后会在当前目录生成 trace.out。将它交给 Go 自带的 trace 查看器后,重点观察同一时间只有两个 P 执行 Go 代码、多个 G 在 runnable 与 running 之间切换,以及任务可能在不同 P 上继续执行;查看器地址和界面细节会因 Go 版本与本机环境不同。
什么时候队列机制会暴露成性能问题
当 CPU 仍有明显空闲,但某些任务长时间 runnable,可能存在工作分配不均、阻塞点或短时调度抖动;当 CPU 已经接近上限且 runnable G 持续增加,则更像是系统已经没有足够执行容量,Work Stealing 只能重新分配任务,不能创造额外 CPU。
因此,排查调度延迟时应把本地队列和 Work Stealing 当作解释“任务如何被分配”的机制,而不是万能优化开关。先确认 CPU 利用率、runnable 堆积、锁与 I/O 等阻塞,再结合 trace 判断执行分布,才能区分负载不均与真正的容量不足。