
CI/CD / 系统课时
部署后执行健康检查
部署后执行健康检查
服务进程成功重启,只能证明启动命令没有立即失败,不能证明用户已经能够正常访问。部署流程应在发布后主动请求 HTTP 健康端点或关键接口,并在超时、错误状态码或持续不可用时让流水线失败,从而尽早识别不可用版本。
学习目标
- 区分进程运行成功与应用真正可用
- 在 GitHub Actions 中实现带重试和超时的 HTTP 健康检查
- 为健康检查设置明确的成功条件和失败边界
为什么重启成功还不够
应用从重启到可对外服务通常存在时间差。进程可能已经运行,但仍在初始化连接池、加载配置或等待依赖;也可能成功监听端口,却因数据库不可达而无法处理业务请求。因此部署完成后的判断应从“命令是否成功”继续推进到“服务是否真的能响应”。
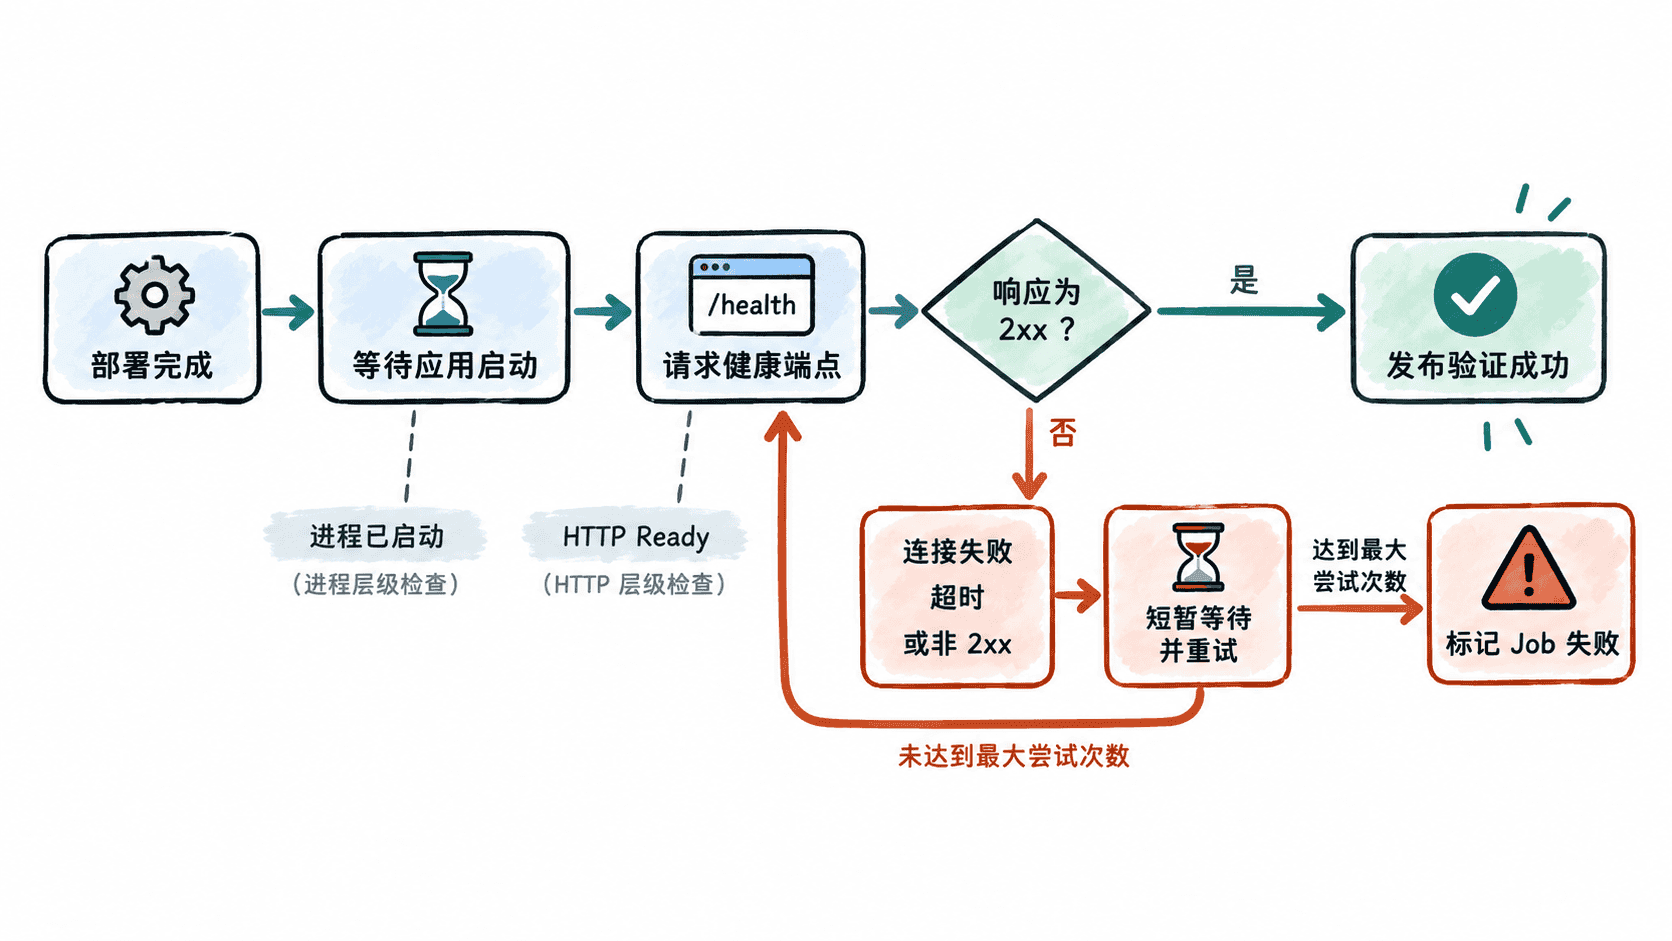
健康端点应尽量稳定且廉价。例如 /health 可以确认应用已经完成关键初始化;如果发布成功必须依赖数据库,也可以让 readiness 检查反映数据库是否可用,但不要在每次探测中执行昂贵业务逻辑。
在工作流中加入重试
刚重启的服务可能需要数秒才能 Ready,因此只执行一次 curl 很容易产生误报。下面的 GitHub Actions Step 最多尝试 12 次,每次请求最多等待 5 秒,失败后间隔 5 秒再次检查。
- name: Verify deployment health
  shell: bash
  env:
    HEALTH_URL: ${{ secrets.HEALTH_URL }}
  run: |
    set -euo pipefail

    for attempt in $(seq 1 12); do
      if curl --fail --silent --show-error \
        --connect-timeout 3 \
        --max-time 5 \
        "$HEALTH_URL" > /dev/null; then
        echo "Health check passed"
        exit 0
      fi

      echo "Health check attempt $attempt failed"
      sleep 5
    done

    echo "Health check failed after 12 attempts" >&2
    exit 1
预期结果:当端点在重试窗口内返回 HTTP 2xx 时,脚本输出成功信息并以退出码 0 结束。若 12 次都失败,则最后显式 exit 1,当前 Step 和 Job 被标记为失败。
Health check attempt 1 failed
Health check attempt 2 failed
Health check passed
--fail 会让 HTTP 400 及以上响应被视为失败,--connect-timeout 限制建立连接的等待时间,--max-time 限制单次请求总耗时。两层超时可以避免目标服务无响应时长期占住 Runner。
定义真正有意义的成功条件
健康检查不能只追求返回 200。端点的语义必须与部署成功条件一致:如果 /health 无论数据库是否可用都返回成功,它只能证明 HTTP 进程存活;如果部署要求服务已经具备接流量能力,则更适合检查 readiness 端点。
对于需要认证的关键接口,不要把长期有效 Token 直接写入工作流。凭据应通过 Secrets 注入,并确保健康检查日志不会打印请求头或敏感响应内容。若只需要确认状态码,像示例一样丢弃响应体通常更安全。
处理持续失败
健康检查持续失败时,流水线必须以非零退出码结束,否则后续步骤仍可能把不可用版本当作成功发布。失败之后是否自动回滚,应由发布策略决定;健康检查本身的职责是提供可靠的判定信号,而不是悄悄忽略错误。
排查时可以单独查看状态码与请求耗时。下面的命令不会输出响应体,适合确认目标地址从当前网络位置是否可达。
curl --silent --show-error --output /dev/null --write-out 'status=%{http_code} total=%{time_total}s\n' --max-time 5 https://service.example.com/health预期输出:健康服务会返回实际 HTTP 状态码和耗时;耗时属于动态值。下面仅表示一次成功请求的输出形态。
status=200 total=<TIME>s部署后的健康检查应成为发布流程的一部分,而不是人工打开网页确认。只要把检查端点、有限重试、单次超时和最终非零退出码定义清楚,流水线就能把“部署命令执行完”提升为“新版本已经通过可用性验证”。