
CI/CD / 系统课时
处理失败后仍需执行的步骤
处理失败后仍需执行的步骤
流水线失败时,最需要保留下来的往往正是失败现场。本节使用 GitHub Actions 的状态检查函数,让日志收集、测试报告上传和清理步骤在前序任务失败后仍按预期执行,同时避免把真正的失败误判成成功。
学习目标
- 理解默认成功条件为何会跳过失败后的步骤
- 使用
failure()、always()和cancelled()控制执行条件 - 为日志收集与清理设计不会掩盖原始故障的处理逻辑
为什么失败后的步骤会被跳过
GitHub Actions 的步骤可以通过 if 表达式决定是否运行。没有显式编写状态检查时,普通后续步骤实际上受到成功状态约束:前面的关键步骤失败后,后面的普通步骤通常不会继续执行。
这对构建流程合理,但对诊断流程并不合适。例如测试失败后,如果上传测试报告的步骤也被跳过,最终只知道“测试失败”,却失去了定位具体用例的证据。
根据状态选择后续动作
常用状态检查函数承担不同职责:failure() 适合只在失败时执行诊断;always() 适合无论成功或失败都需要执行的收尾工作;cancelled() 用于判断工作流或作业是否已经取消。
下面的工作流故意让测试步骤失败,以观察后续步骤的行为。上传日志使用 failure(),清理使用 always();示例中的命令只模拟这些动作,因此可以直接运行而不依赖额外文件。
name: failure-handling

on:
  workflow_dispatch:

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - name: Run tests
        run: |
          echo "running tests"
          exit 1

      - name: Collect failure logs
        if: ${{ failure() }}
        run: echo "collect diagnostic logs"

      - name: Cleanup
        if: ${{ always() }}
        run: echo "cleanup temporary resources"
预期结果
Run tests: failure
Collect failure logs: success
Cleanup: success
Job result: failure
界面显示的具体时间与日志前缀可能不同,但关键结果应一致:测试失败后两个处理步骤仍运行,整个作业仍保持失败状态。
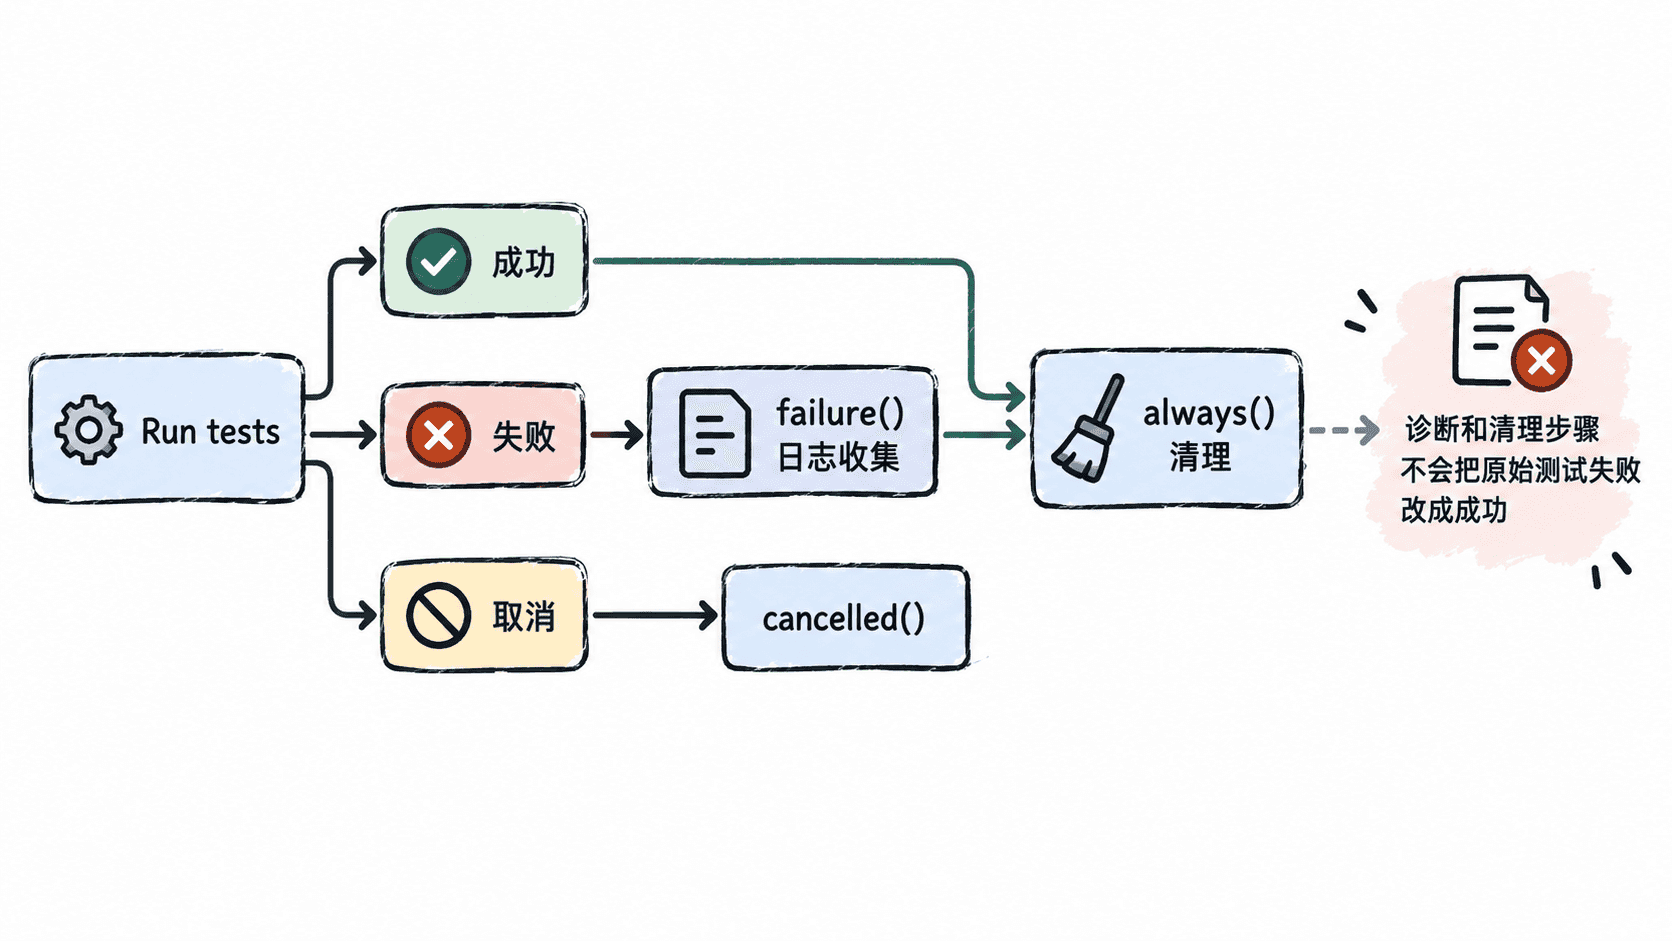
failure 与 always 不可互换
failure() 表达的是“前序执行已经出现失败”,所以适合收集错误日志、保存崩溃信息或执行失败通知。成功路径没有诊断需求时,这些步骤不必运行。
always() 更强:即使前面的步骤失败,它仍会尝试执行。因此它适合必须收尾的轻量操作,但不应机械地用于所有步骤。特别是可能长时间等待外部资源的关键操作,应谨慎使用无条件执行策略。
如果希望某个收尾步骤在成功和失败时运行、但取消后不继续,可以显式组合条件:
- name: Cleanup unless cancelled
  if: ${{ !cancelled() }}
  run: echo "cleanup after normal completion or failure"
预期结果
cleanup after normal completion or failure当作业未被取消时会执行该命令;取消情况下该步骤不会运行。实际 Actions 页面还会显示对应步骤的执行或跳过状态。
不要掩盖真正的失败
状态检查函数控制的是后续步骤是否运行,并不意味着应该忽略核心步骤的错误。测试或部署失败后,日志收集可以成功,原始失败仍应保留下来,使提交检查明确显示流水线存在问题。
设计失败处理时,可以把步骤分成三类:核心验证失败应使作业失败;故障证据只在失败时收集;必要清理根据是否允许取消后继续执行,选择 always() 或 !cancelled()。这样既能留下诊断信息,也不会把红灯错误地变成绿灯。