
CI/CD / 系统课时
跨 Job 下载并使用制品
跨 Job 下载并使用制品
当构建和测试拆成不同 Job 时,它们不会共享同一个 Runner 文件系统。正确做法是让构建 Job 上传 artifact,消费方等待构建完成后再下载同一份文件,从而保证测试、扫描或部署使用的是已经构建好的同一版本。
学习目标
- 理解不同 Job 之间为什么不能直接读取彼此的工作目录
- 使用
upload-artifact与download-artifact传递构建结果 - 通过 Job 依赖和下载路径验证制品是否正确交接
Job 之间为什么需要制品
每个 Job 都可能运行在独立 Runner 上。即使两个 Job 都使用 ubuntu-latest,也不能假设前一个 Job 创建的 dist/app.txt 会自动出现在后一个 Job 的文件系统中。
跨 Job 传递构建结果通常分为三个动作:生产者生成文件并上传 artifact,消费者通过 needs 等待生产者成功完成,然后下载指定 artifact。这样可以只构建一次,再让测试、扫描和部署复用相同结果。
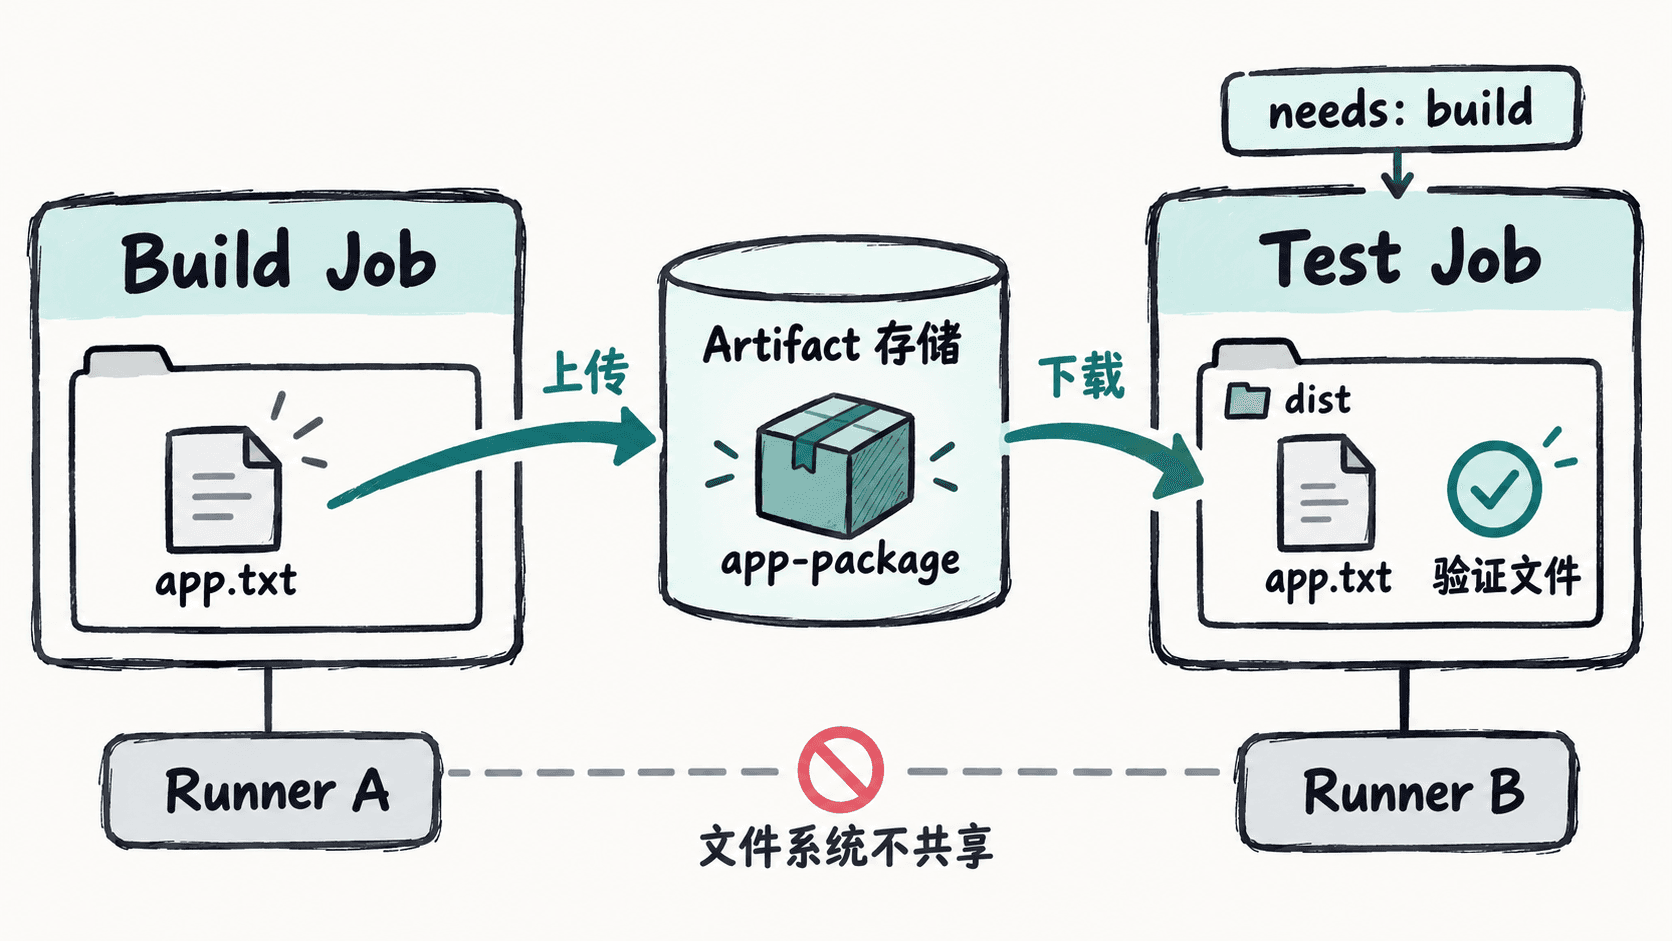
构建一次并在另一个 Job 使用
下面的完整 workflow 使用两个 Job。build 负责产生并上传文件,verify 通过 needs: build 建立依赖,再把名为 app-package 的 artifact 下载到 dist。
name: cross-job-artifact

on:
  workflow_dispatch:

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - name: Create package
        run: |
          mkdir -p dist
          printf 'version=1.0.0\n' > dist/app.txt

      - name: Upload package
        uses: actions/upload-artifact@v4
        with:
          name: app-package
          path: dist/app.txt

  verify:
    needs: build
    runs-on: ubuntu-latest
    steps:
      - name: Download package
        uses: actions/download-artifact@v4
        with:
          name: app-package
          path: dist

      - name: Verify downloaded package
        run: |
          test -f dist/app.txt
          cat dist/app.txt
预期输出
version=1.0.0这里的关键不是 cat,而是 test -f 能证明第二个 Job 的 Runner 上确实出现了下载后的文件。如果下载失败或路径不符合预期,该步骤会失败,而不是让后续流程继续使用不存在的产物。
控制执行顺序和下载位置
needs: build 同时表达执行依赖和成功条件:verify 要等 build 完成后才具备正常执行的前提。只写下载步骤而没有正确安排依赖,消费者可能在制品尚未产生时就开始执行。
下载时的 name 必须与上传时的 artifact 名称对应。path 则决定文件落到当前 Runner 的哪个目录。后续命令应该依据下载后的真实目录结构读取文件,而不能沿用构建 Job 中的路径假设。
为什么比重复构建更可靠
如果测试 Job 和部署 Job 分别重新执行构建,即使源码提交相同,也可能因为依赖解析、构建环境或外部资源变化得到不同结果。先构建一次,再传递同一个 artifact,可以让后续阶段围绕同一份二进制结果工作。
这种方式也能缩短流水线:昂贵的编译或前端打包只执行一次,多个消费者只负责下载。不过 artifact 仍会产生上传、存储和下载开销,因此几字节的状态值不值得打包成文件传递。
排查跨 Job 传递失败
遇到下载失败时,先确认生产 Job 是否成功上传,再核对上传与下载两端的 name,最后检查下载后的目录结构。若 build 本身失败,依赖它的普通 verify Job 通常不会继续执行,这时应先处理上游构建问题。
跨 Job 的核心边界很明确:Runner 文件系统彼此隔离,needs 负责建立作业依赖,artifact 负责保存和搬运文件。把这三个职责分开理解后,就可以自然扩展到“构建一次,测试、扫描、部署多次消费”的流水线。