
CI/CD / 系统课时
缓存依赖缩短构建时间
缓存依赖缩短构建时间
持续集成经常把时间浪费在重复下载相同依赖上。GitHub Actions 的依赖缓存可以在不同运行之间复用包管理器缓存;关键不是简单地“缓存目录”,而是设计能随依赖变化自动失效、又能尽量复用已有内容的缓存键。
学习目标
- 理解依赖缓存能缩短哪些构建阶段
- 使用
actions/setup-node为 npm 配置依赖缓存 - 根据锁文件变化判断缓存何时失效
缓存应该缓存什么
以 Node.js 项目为例,CI 通常先下载 npm 包,再执行测试或构建。依赖没有变化时,反复从远程仓库下载相同包既增加网络请求,也延长 Runner 占用时间。
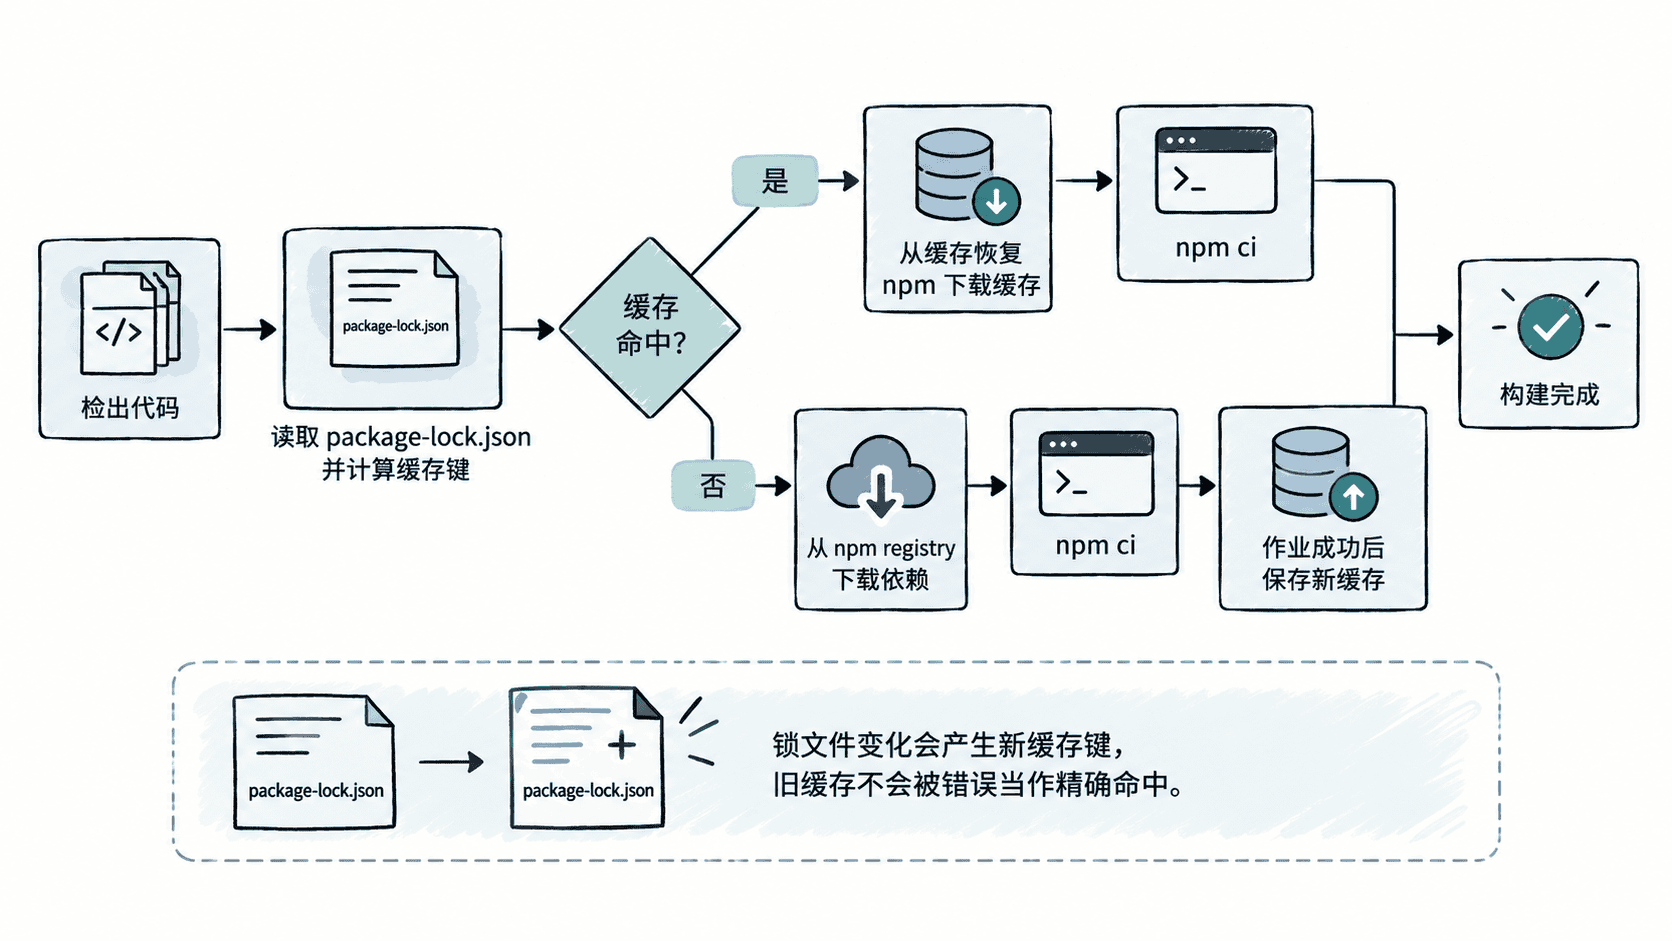
缓存的目标通常是包管理器的下载缓存,而不是直接保存整个 node_modules。配合 npm ci,仍然可以按照 package-lock.json 精确重建依赖,同时复用已经下载过的包。
用 setup-node 缓存 npm 依赖
官方 actions/setup-node 可以直接管理 npm 缓存。下面是一份完整的 CI 工作流,锁文件既用于 npm ci 安装,也参与缓存依赖路径的计算。
name: CI

on:
  push:
  pull_request:

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Setup Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '22'
          cache: 'npm'
          cache-dependency-path: 'package-lock.json'

      - name: Install dependencies
        run: npm ci

      - name: Run tests
        run: npm test
cache: 'npm' 启用 npm 缓存,cache-dependency-path 指定用于确定依赖状态的锁文件。这里不会缓存 node_modules,因此 npm ci 仍会执行,只是可以利用已经缓存的 npm 包减少网络下载。
预期结果
Run npm ci
<DEPENDENCY_INSTALL_OUTPUT>
Run npm test
<TEST_OUTPUT>
实际安装耗时和日志内容取决于项目及缓存是否命中;第二次运行且锁文件未变化时,通常可以减少依赖下载时间。
让依赖变化自然触发失效
缓存最重要的边界是:依赖集合发生变化后不能继续把旧缓存当作当前依赖的精确缓存。setup-node 会根据包管理器和依赖文件等信息管理缓存键,因此锁文件变化后会对应新的缓存状态。
不要只根据分支名设计一个长期不变的依赖缓存。例如只有 main 这样的键无法表达 package-lock.json 已经改变,容易让缓存生命周期与真实依赖状态脱节。
对于 monorepo,可以用 cache-dependency-path 指向实际锁文件;存在多个匹配文件时也可以使用多行或通配模式,让缓存状态跟随相关依赖清单变化。路径必须与仓库结构一致,否则缓存可能无法按预期工作。
判断缓存是否真的有收益
缓存不是让所有步骤都变快。编译、测试本身很慢时,依赖缓存只能优化下载与安装相关阶段。评估时应比较相同依赖状态下首次运行与后续运行的安装耗时,而不是只观察整个工作流总时长。
如果依赖下载本来只占几秒,增加复杂的自定义缓存策略可能得不偿失;当依赖数量多、Runner 每次都是干净环境或网络下载明显占据构建时间时,缓存才最值得优先配置。