
计算机网络 / 系统课时
高并发真正受限的是哪一层
高并发真正受限的是哪一层
连接数升高时,服务变慢并不等于“线程不够”或“epoll 不够快”。真正的瓶颈可能出现在连接资源、调度、系统调用、内核缓冲区或业务处理任意一层。按层拆开观察,才能避免只调并发参数却把拥塞继续向后传。
学习目标
- 把高并发服务拆成连接、执行、内核 I/O 与业务处理等层次
- 根据队列、CPU、上下文切换和缓冲区信号判断瓶颈所在
- 用一组 Linux 指标建立可重复的定位顺序
并发链路里每一层都可能先到上限
一个请求从到达网卡到完成响应,至少要经过套接字与内核缓冲区、事件通知、线程或协程调度、业务逻辑,以及数据库或其他下游。连接数只是入口规模,并不能直接说明哪一层已经饱和。
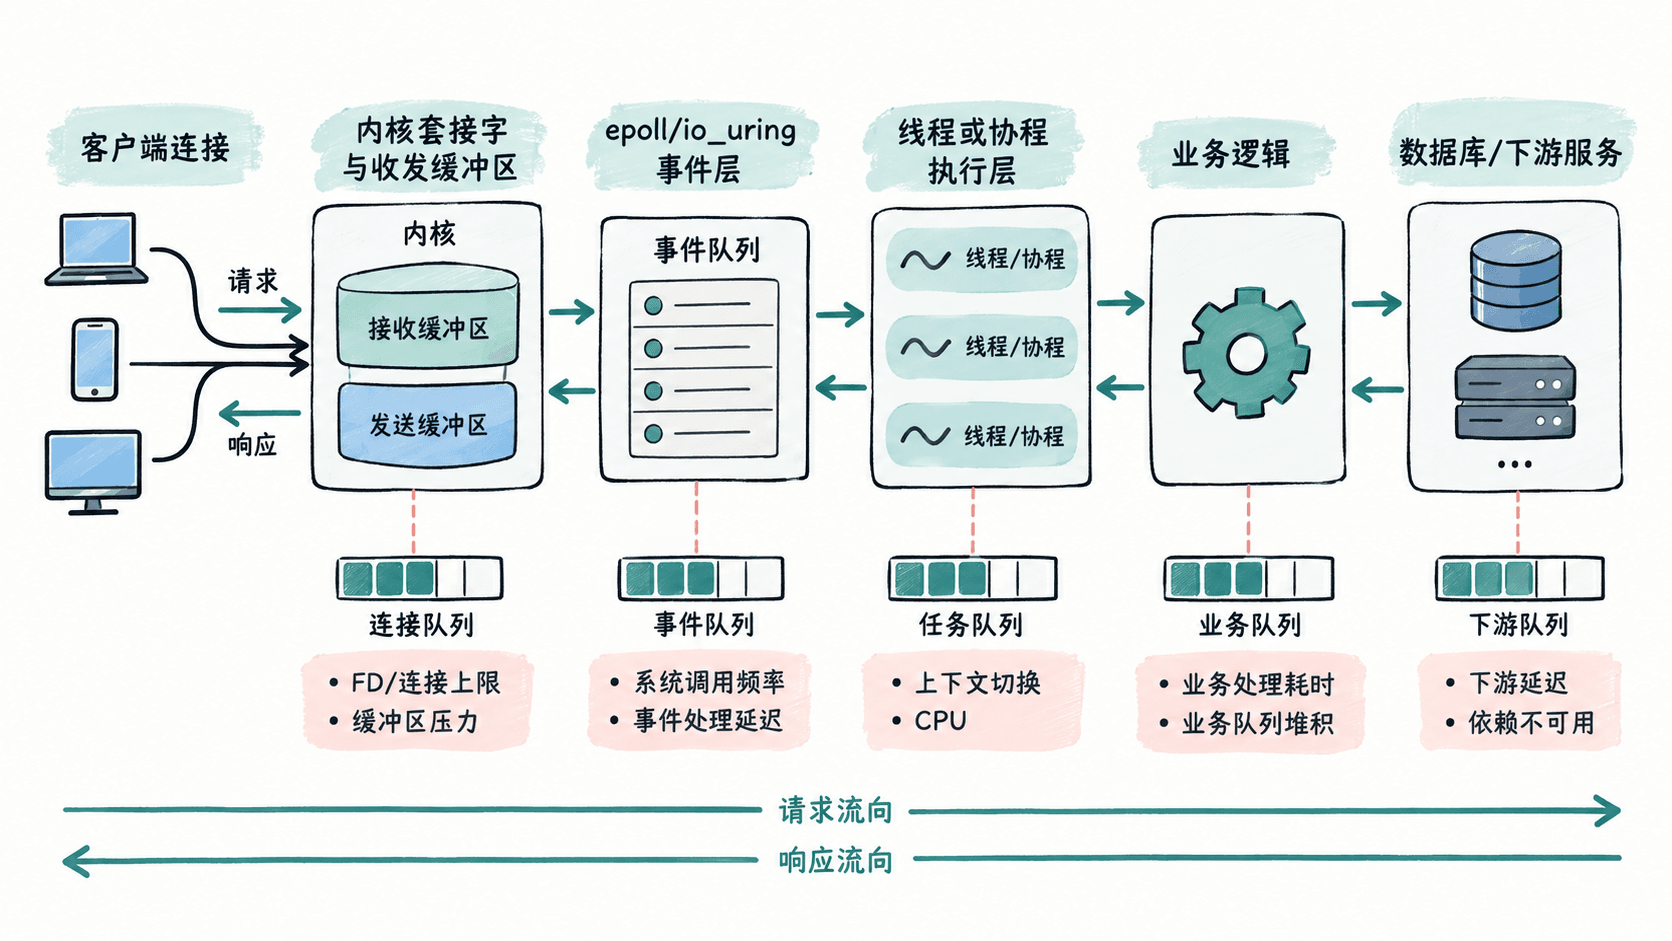
如果连接层先满,常见现象是文件描述符或监听队列接近上限;如果执行层先满,CPU 和上下文切换会快速上升;如果业务层先满,事件循环可能仍然健康,但请求会堆在任务队列或下游调用上。瓶颈看的是最先无法继续消化负载的那一层,而不是最显眼的指标。
先判断是“等 I/O”还是“忙计算”
CPU 已经接近饱和时,继续增加线程通常只会增加调度成本。此时应再区分:CPU 时间花在业务计算,还是大量系统调用、锁竞争与上下文切换上。相反,如果 CPU 不高但延迟持续增加,更应该检查等待中的连接、任务队列和下游响应时间。
线程数也不能单独解释吞吐。大量线程可能意味着阻塞 I/O,也可能只是配置冗余;少量线程配合事件循环也可能因为单个回调执行过久而阻塞全部连接。判断时要把线程数量、可运行线程、上下文切换和每请求 CPU 时间放在一起看。
再检查内核资源有没有形成背压
内核层常见的限制包括文件描述符、监听队列、套接字数量、TCP 内存和收发缓冲区。缓冲区不是越大越好:它能吸收短时抖动,却也可能把拥塞隐藏成更长的排队延迟。
下面的 Linux 检查只依赖 /proc,把 <ID> 替换为目标服务进程 PID。输出中的 <N> 是动态值,实际数值会随负载变化。
PID="<ID>"
printf 'fd_count='
ls "/proc/$PID/fd" | wc -l
grep -E '^(Threads|voluntary_ctxt_switches|nonvoluntary_ctxt_switches):' "/proc/$PID/status"
grep -E '^(sockets:|TCP:|UDP:)' /proc/net/sockstat
预期输出
fd_count=<N>
Threads: <N>
voluntary_ctxt_switches: <N>
nonvoluntary_ctxt_switches: <N>
sockets: used <N>
TCP: inuse <N> orphan <N> tw <N> alloc <N> mem <N>
UDP: inuse <N> mem <N>
这里不要用某个单点阈值直接下结论。更有价值的是在低负载与高负载下重复采样:如果连接数基本稳定但上下文切换陡增,先查执行模型;如果线程与 CPU 都平稳而 TCP 内存持续上涨,则更像收发速度不匹配或下游处理变慢。
按队列增长的位置定位瓶颈
最有效的顺序是沿请求路径寻找“哪一个队列在持续变长”。监听队列增长,说明应用接受连接不够快;已建立连接很多但事件处理及时,问题可能转移到业务任务;业务队列增长而下游延迟同步升高,则网络层继续优化也不会提高端到端吞吐。
排查时应优先做对照实验:固定请求大小与并发度,只改变一个变量,例如线程数、每连接处理时长或下游延迟,并记录 CPU、上下文切换、套接字与应用队列。只有指标随单一变量呈稳定关联,才足以支持“这一层是当前瓶颈”的判断。
高并发优化的目标不是让每一层都更“快”,而是让入口速率与各层处理能力匹配,并在压力超过能力时尽早背压或限流。只要先找到最先堆积的队列,再决定调线程、换 I/O 模型、扩缓冲区还是优化业务逻辑,调优才不会变成参数碰运气。