
计算机网络 / 系统课时
io_uring怎么提交多个操作
io_uring怎么提交多个操作
单次 I/O 很快时,真正拖慢程序的常常不是设备本身,而是频繁进入内核。批量提交的核心是先连续准备多个 SQE,再一次发布给提交队列,让一次提交动作携带更多工作。本节用可运行的 NOP 示例观察批处理,并把 SQ ring 的更新时机说清楚。
学习目标
- 能连续获取并填写多个 SQE,再用一次提交发布它们。
- 理解 SQE、SQ ring tail 与
io_uring_submit之间的关系。 - 能判断什么时候值得积攒一批操作,什么时候应立即提交。
批量提交到底批了什么
io_uring_get_sqe 只是为当前 ring 取得一个可填写的提交项。连续调用它,可以在用户态先准备多条操作;这些操作还没有逐条触发一次系统调用。真正的批量效果来自随后的一次 io_uring_submit:它把当前待提交的 SQE 一并发布。
传统 SQ ring 模式下,liburing 会在提交阶段把待发布的 SQE 索引写入 SQ ring,并推进提交队列的 tail,使内核能看到新工作;随后根据 ring 配置决定是否需要进入内核。启用 SQPOLL 等模式时,唤醒和系统调用行为会不同,因此不要把“提交一次”机械等同为“必然只有一次系统调用”。
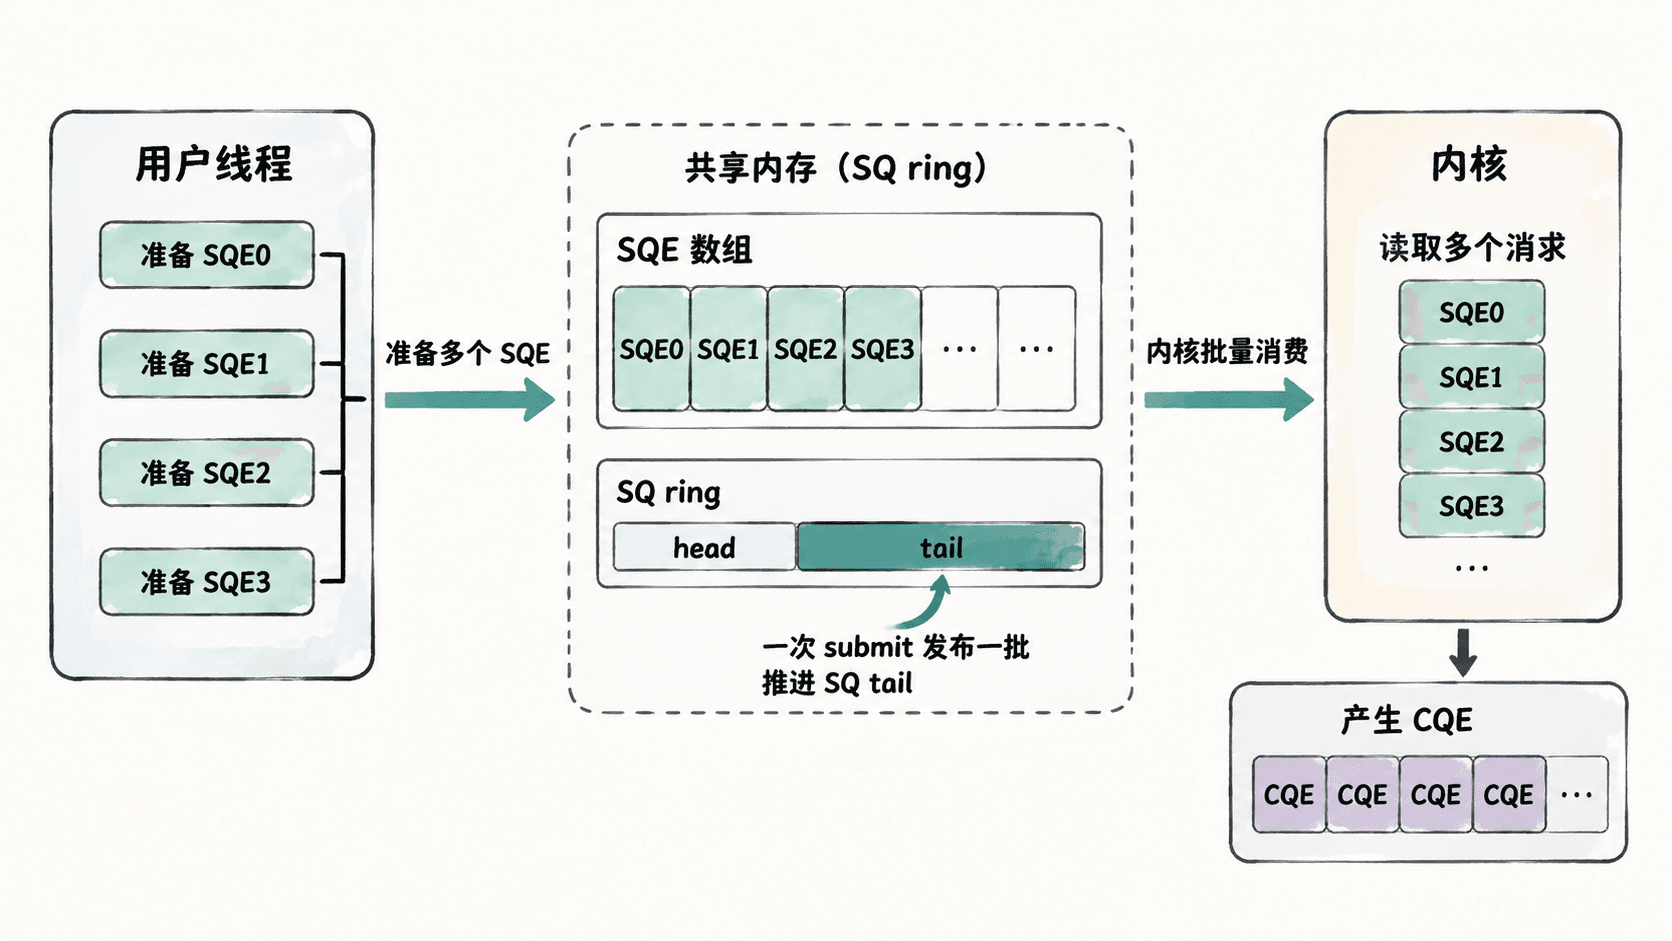
用一次提交发送四个操作
下面使用四个 IORING_OP_NOP,这样可以只观察提交与完成过程,不受磁盘、网络和权限因素干扰。ring 深度为 8,四个 SQE 可以一次放入队列。
#include <liburing.h>
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    struct io_uring ring;
    int ret = io_uring_queue_init(8, &ring, 0);
    if (ret < 0) {
        fprintf(stderr, "queue_init: %d\n", ret);
        return 1;
    }

    /* 先在用户态连续准备四个 SQE,不在循环里逐个 submit。 */
    for (unsigned i = 0; i < 4; ++i) {
        struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
        if (sqe == NULL) {
            fprintf(stderr, "no free SQE\n");
            io_uring_queue_exit(&ring);
            return 1;
        }

        io_uring_prep_nop(sqe);
        io_uring_sqe_set_data64(sqe, i + 1);
    }

    /* 一次发布当前已经准备好的全部 SQE。 */
    ret = io_uring_submit(&ring);
    if (ret < 0) {
        fprintf(stderr, "submit: %d\n", ret);
        io_uring_queue_exit(&ring);
        return 1;
    }
    printf("submitted=%d\n", ret);

    /* CQE 的到达顺序不作为正确性条件,只统计完成数量。 */
    unsigned completed = 0;
    while (completed < 4) {
        struct io_uring_cqe *cqe;
        ret = io_uring_wait_cqe(&ring, &cqe);
        if (ret < 0) {
            fprintf(stderr, "wait_cqe: %d\n", ret);
            io_uring_queue_exit(&ring);
            return 1;
        }

        if (cqe->res < 0) {
            fprintf(stderr, "operation failed: %d\n", cqe->res);
        }
        ++completed;
        io_uring_cqe_seen(&ring, cqe);
    }

    printf("completed=%u\n", completed);
    io_uring_queue_exit(&ring);
    return 0;
}
预期输出
submitted=4
completed=4
这个程序需要支持 io_uring 的 Linux 内核和 liburing 开发库。不同内核与 liburing 版本可能改变内部提交路径,但四个 NOP 被同一次 io_uring_submit 发布这一点不变。
提交时机决定延迟和吞吐
批处理不是越大越好。积攒更多 SQE 可以摊薄进入内核、队列同步和函数调用的固定成本,因此在连接多、单次 I/O 很小、吞吐优先的场景中更有价值。
代价是等待成批的过程会增加排队延迟。事件循环通常采用“先处理当前一轮产生的请求,再统一 submit”的方式,而不是为了凑固定数量无限等待。低延迟 RPC、握手、心跳等操作往往应尽快发布。
队列满时不要继续硬塞
io_uring_get_sqe 返回 NULL 表示当前没有可用 SQE。常见原因是应用准备速度超过了提交或内核消费速度。正确处理方式通常是先提交已经准备好的请求,消费 CQE 释放进度,再继续准备后续操作。
批量大小应结合 ring 深度、业务延迟目标和每轮事件循环产生的 I/O 数量决定。实践中更重要的是减少“每个请求一次 submit”的模式,而不是追求某个固定批次数字。