
计算机网络 / 系统课时
一个读操作怎么走完io_uring链路
一个读操作怎么走完io_uring链路
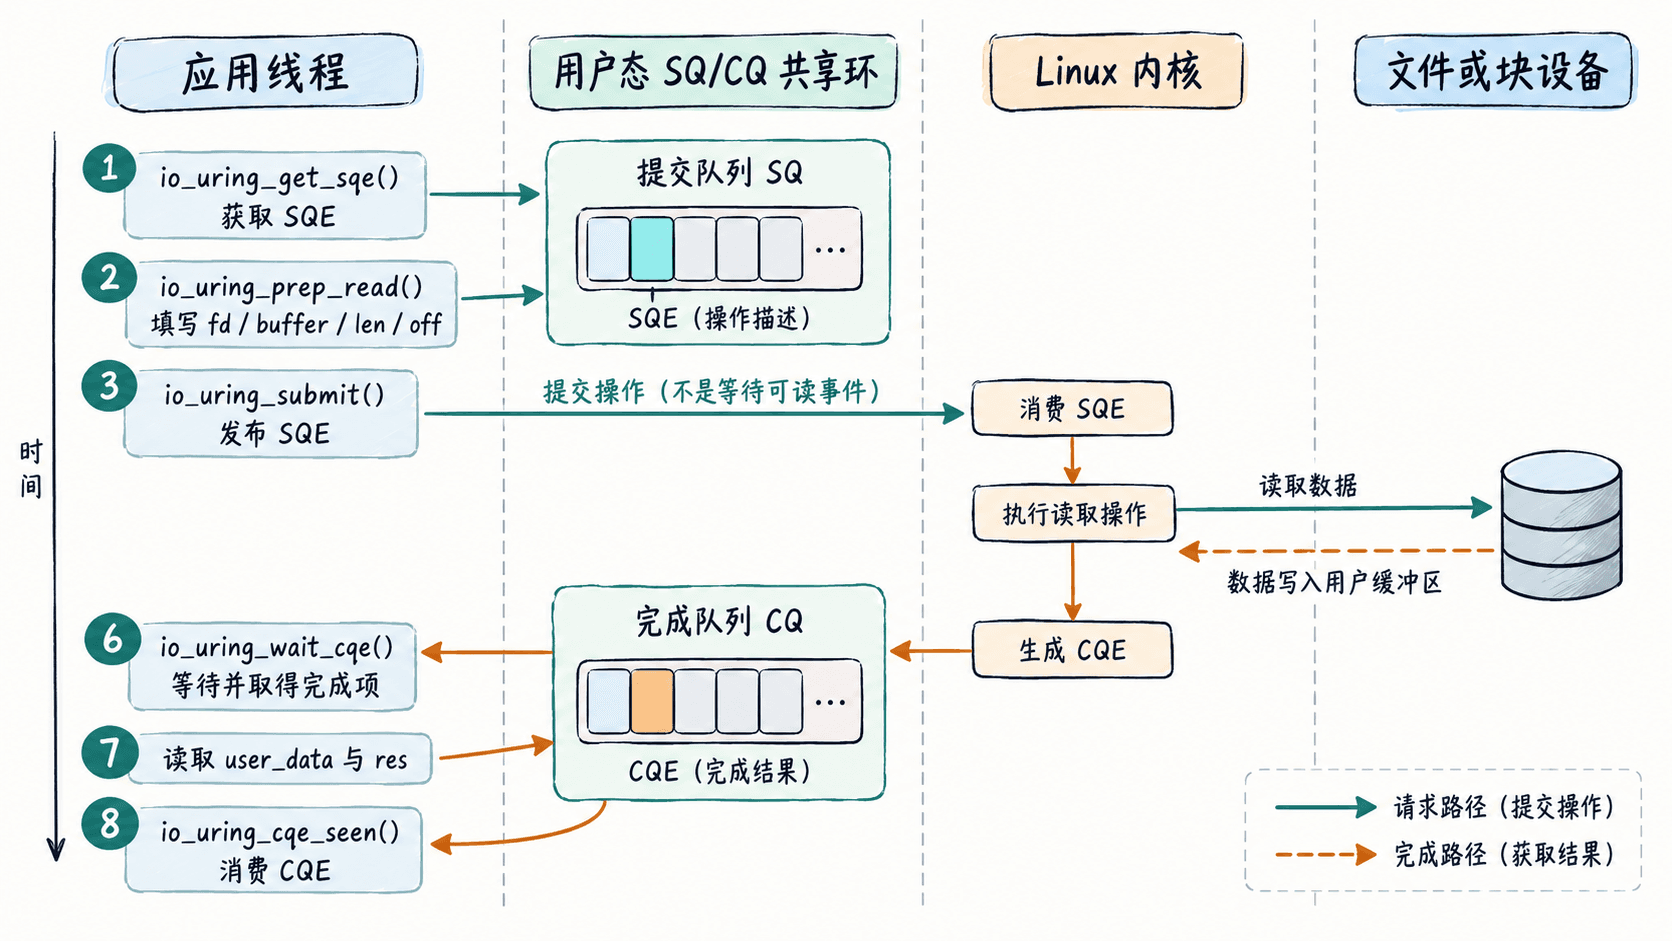
io_uring 的读操作不是先等“可读事件”再调用 read(),而是把“读取这件事”直接提交给内核,随后等待完成结果。下面沿着一个真实文件读取请求,跟踪 SQE 准备、提交、内核执行、CQE 返回与消费的完整链路。
学习目标
- 能按顺序解释一次
read请求从 SQE 到 CQE 的全过程。 - 能使用 liburing 完成一次可运行的异步读取并校验结果。
- 能正确处理成功、EOF 与负 errno 三类完成状态。
准备读取请求
应用先初始化 ring,再从提交队列取得一个 SQE。io_uring_prep_read() 会把“从哪个 fd、读到哪里、最多读多少、从什么偏移开始”等信息写入 SQE;此时操作还没有完成,甚至可能还没有真正进入内核执行阶段。
本例创建一个临时文件,先写入固定内容,再通过 io_uring 从偏移 0 读取:
#include <fcntl.h>
#include <liburing.h>
#include <stdio.h>
#include <string.h>
#include <unistd.h>

int main(void) {
    const char *path = "/tmp/io_uring_read_demo.txt";
    const char *text = "hello uring";
    char buf[64] = {0};
    struct io_uring ring;
    struct io_uring_sqe *sqe;
    struct io_uring_cqe *cqe;
    int fd, ret, read_res;
    ssize_t written;

    fd = open(path, O_CREAT | O_RDWR | O_TRUNC, 0600);
    if (fd < 0) {
        perror("open");
        return 1;
    }

    written = write(fd, text, strlen(text));
    if (written != (ssize_t)strlen(text)) {
        if (written < 0) {
            perror("write");
        } else {
            fprintf(stderr, "short write\n");
        }
        close(fd);
        return 1;
    }

    ret = io_uring_queue_init(8, &ring, 0);
    if (ret < 0) {
        fprintf(stderr, "queue_init: %s\n", strerror(-ret));
        close(fd);
        return 1;
    }

    sqe = io_uring_get_sqe(&ring);
    io_uring_prep_read(sqe, fd, buf, sizeof(buf) - 1, 0);
    io_uring_sqe_set_data64(sqe, 1001);

    ret = io_uring_submit(&ring);
    if (ret < 0) {
        fprintf(stderr, "submit: %s\n", strerror(-ret));
        io_uring_queue_exit(&ring);
        close(fd);
        return 1;
    }

    ret = io_uring_wait_cqe(&ring, &cqe);
    if (ret < 0) {
        fprintf(stderr, "wait_cqe: %s\n", strerror(-ret));
        io_uring_queue_exit(&ring);
        close(fd);
        return 1;
    }

    read_res = cqe->res;
    if (read_res < 0) {
        fprintf(stderr, "read failed: %s\n", strerror(-read_res));
    } else {
        buf[read_res] = '\0';
        printf("id=%llu bytes=%d data=%s\n",
               (unsigned long long)cqe->user_data,
               read_res,
               buf);
    }

    io_uring_cqe_seen(&ring, cqe);
    io_uring_queue_exit(&ring);
    close(fd);
    unlink(path);
    return read_res < 0 ? 1 : 0;
}
编译并运行:
cc read_demo.c -o read_demo -luring
./read_demo
预期输出:
id=1001 bytes=11 data=hello uring提交之后发生了什么
io_uring_submit() 把已经准备好的 SQE 发布给内核。具体实现可能因为 ring 配置和内核版本而减少系统调用次数,但从编程模型看,提交完成后应用就应把该 SQE 视为不可再修改。
内核消费 SQE 后执行读操作,并把完成状态写成 CQE。与 epoll 的“就绪通知”不同,CQE 表示的是这次读请求已经完成,因此应用通常不需要在收到 CQE 后再调用一次 read()。
读取 CQE 时怎么判断结果
io_uring_wait_cqe() 的职责是等待并返回一个完成项,而不是返回这次读操作的字节数。真正的读取结果在 cqe->res:
cqe->res > 0:成功读取对应字节数。cqe->res == 0:到达 EOF,没有更多数据。cqe->res < 0:操作失败,值为负 errno,例如-EIO、-EBADF。
处理完 CQE 后必须调用 io_uring_cqe_seen(),否则应用没有推进完成队列的消费位置,长期运行时会逐渐耗尽可用 CQ 空间。
从链路看完成驱动模型
这条链路的关键变化是:应用先描述并提交一个 I/O 操作,然后等待“操作完成”,而不是先等待某个 fd 变得可读、再由应用补做读调用。这样,调度、批量提交和完成收集都围绕 SQE/CQE 展开。
当你需要同时管理大量连接时,通常会给每个 SQE 设置可追踪的 user_data,在 CQE 返回后快速定位对应连接和请求上下文。只要始终遵守“准备 SQE → 提交 → 读取 cqe->res → cqe_seen”这条闭环,就能把一次读取安全地走完整个 io_uring 链路。