
计算机网络 / 系统课时
替换为io_uring并保持接口一致
替换为io_uring并保持接口一致
把 epoll 改成 io_uring 的难点不是调用几个新 API,而是避免让完成式 I/O 语义渗透到业务层。本节先固定业务接口,再替换底层实现,并用同一套验证与压测口径比较结构和性能。
学习目标
- 设计稳定的 I/O 抽象,使业务处理代码不依赖 epoll 或 io_uring 细节。
- 理解就绪通知与完成通知在缓冲区、取消、错误和生命周期上的差异。
- 用一致的负载、指标和验收条件比较两种后端,而不是只看单次吞吐数字。
先固定业务边界再替换 I/O 层
业务层最好只表达“收取一段数据”“发送一段数据”“关闭连接”等意图,不直接持有 epoll fd、SQE 或 CQE。这样替换 I/O 后端时,协议解析、路由和业务逻辑仍沿用原接口,变化被限制在后端内部。
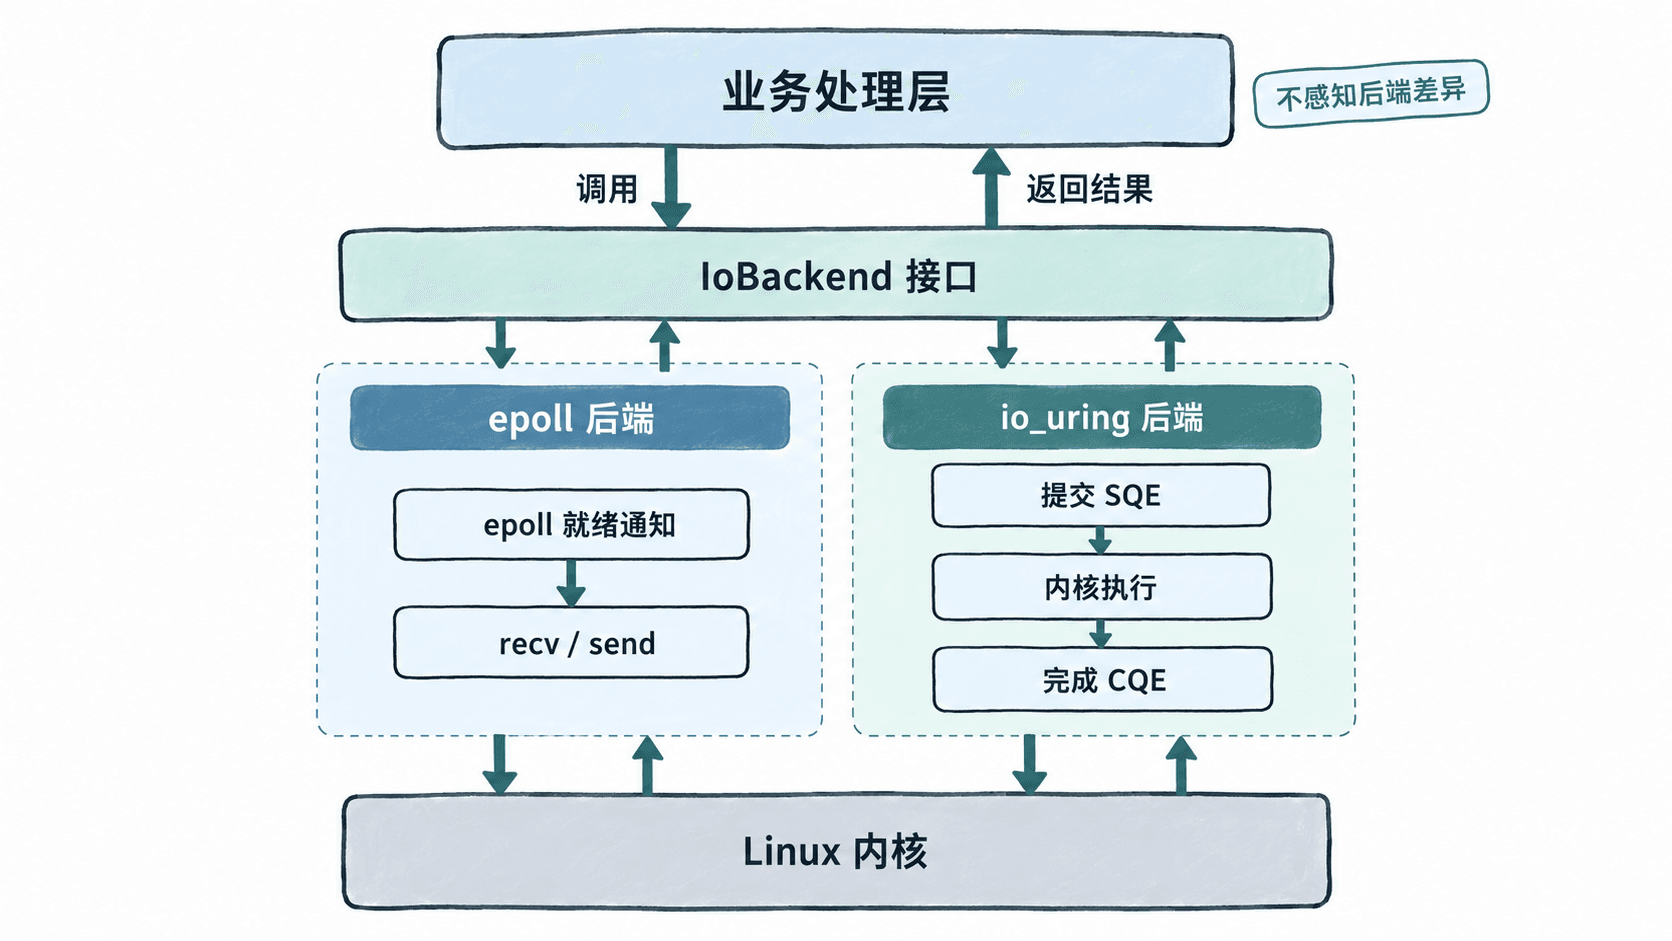
下面的完整示例定义统一的 IoBackend::recv_some 接口。EpollBackend 等待可读事件后调用 recv,IoUringBackend 则提交 recv 请求并等待 CQE;业务函数 handle_one 完全不需要修改。运行环境需要 Linux、支持 io_uring 的内核以及已安装的 liburing,编译时需链接 -luring。
#include <liburing.h>
#include <sys/epoll.h>
#include <sys/socket.h>
#include <unistd.h>

#include <cerrno>
#include <cstddef>
#include <iostream>
#include <stdexcept>
#include <string>
#include <system_error>

// 业务层只依赖这个接口,不感知具体 I/O 模型。
class IoBackend {
public:
    virtual ~IoBackend() = default;
    virtual ssize_t recv_some(int fd, void* buffer, std::size_t size) = 0;
};

class EpollBackend final : public IoBackend {
public:
    EpollBackend() : epfd_(epoll_create1(EPOLL_CLOEXEC)) {
        if (epfd_ < 0) {
            throw std::system_error(errno, std::generic_category(), "epoll_create1");
        }
    }

    ~EpollBackend() override {
        close(epfd_);
    }

    ssize_t recv_some(int fd, void* buffer, std::size_t size) override {
        epoll_event event{};
        event.events = EPOLLIN;
        event.data.fd = fd;

        if (epoll_ctl(epfd_, EPOLL_CTL_ADD, fd, &event) < 0) {
            throw std::system_error(errno, std::generic_category(), "epoll_ctl add");
        }

        // epoll 只报告“可读”,真正搬运数据仍由 recv 完成。
        epoll_event ready{};
        int n = epoll_wait(epfd_, &ready, 1, -1);
        int wait_errno = errno;
        epoll_ctl(epfd_, EPOLL_CTL_DEL, fd, nullptr);

        if (n < 0) {
            throw std::system_error(wait_errno, std::generic_category(), "epoll_wait");
        }

        ssize_t received = recv(fd, buffer, size, 0);
        if (received < 0) {
            throw std::system_error(errno, std::generic_category(), "recv");
        }
        return received;
    }

private:
    int epfd_;
};

class IoUringBackend final : public IoBackend {
public:
    IoUringBackend() {
        int rc = io_uring_queue_init(8, &ring_, 0);
        if (rc < 0) {
            throw std::system_error(-rc, std::generic_category(), "io_uring_queue_init");
        }
    }

    ~IoUringBackend() override {
        io_uring_queue_exit(&ring_);
    }

    ssize_t recv_some(int fd, void* buffer, std::size_t size) override {
        io_uring_sqe* sqe = io_uring_get_sqe(&ring_);
        if (sqe == nullptr) {
            throw std::runtime_error("no available SQE");
        }

        // 缓冲区必须一直有效,直到对应 CQE 被消费。
        io_uring_prep_recv(sqe, fd, buffer, size, 0);

        int rc = io_uring_submit(&ring_);
        if (rc < 0) {
            throw std::system_error(-rc, std::generic_category(), "io_uring_submit");
        }

        io_uring_cqe* cqe = nullptr;
        rc = io_uring_wait_cqe(&ring_, &cqe);
        if (rc < 0) {
            throw std::system_error(-rc, std::generic_category(), "io_uring_wait_cqe");
        }

        int result = cqe->res;
        io_uring_cqe_seen(&ring_, cqe);
        if (result < 0) {
            throw std::system_error(-result, std::generic_category(), "io_uring recv");
        }
        return result;
    }

private:
    io_uring ring_{};
};

std::string handle_one(IoBackend& io, int fd) {
    char buffer[64]{};
    ssize_t n = io.recv_some(fd, buffer, sizeof(buffer));
    return std::string(buffer, buffer + n);
}

void run_case(const char* name, IoBackend& backend) {
    // socketpair 让两个后端在本机得到完全相同的输入。
    int sv[2];
    if (socketpair(AF_UNIX, SOCK_STREAM, 0, sv) < 0) {
        throw std::system_error(errno, std::generic_category(), "socketpair");
    }

    if (send(sv[1], "ping", 4, 0) != 4) {
        close(sv[0]);
        close(sv[1]);
        throw std::runtime_error("send failed");
    }

    std::cout << name << ": " << handle_one(backend, sv[0]) << '\n';
    close(sv[0]);
    close(sv[1]);
}

int main() {
    EpollBackend epoll_backend;
    IoUringBackend uring_backend;

    run_case("epoll", epoll_backend);
    run_case("io_uring", uring_backend);
}
预期输出
epoll: ping
io_uring: ping
这个示例只验证“业务接口可以不变”,并不是生产级事件循环。生产实现应长期复用 epoll 实例和 io_uring ring,并同时处理大量连接,而不是每次调用都只等待一个操作。
接口一致不等于语义天然一致
epoll 告诉你“现在可能可以读写”,真正的数据搬运仍由 recv、send 完成;io_uring 则把操作提交给内核,之后通过 CQE 得到完成结果。抽象接口可以一致,但后端必须正确处理两种不同的生命周期。
最容易出错的是缓冲区所有权。epoll 路径通常在当前调用栈里完成 recv;io_uring 提交后,缓冲区在 CQE 到来前都不能释放或复用。连接关闭、超时和任务取消也要与未完成请求协调,否则会出现悬空指针、重复回收或晚到 CQE 操作已复用连接的问题。
部分读写同样不能被抽象层掩盖。无论 epoll 还是 io_uring,一次操作都不保证得到完整应用层消息;业务接口最好返回“本次完成了多少字节”,由协议层继续累计,而不是假设一次完成就对应一个请求。
用同一套基准比较两种实现
比较时只改变 I/O 后端,其余条件保持不变:相同协议、连接数、请求体大小、业务逻辑、线程数、CPU 亲和性和压测时长。至少记录吞吐、P50/P99 延迟、CPU 利用率、上下文切换、系统调用数量、事件或完成数量以及错误率。
| 观察项 | epoll 后端 | io_uring 后端 |
|---|---|---|
| 业务接口 | 同一套 | 同一套 |
| 内核通知模型 | 就绪通知 | 完成通知 |
| 主要热路径 | epoll_wait + recv/send |
SQE 提交 + CQE 消费 |
| 缓冲区生命周期 | 通常与当前读写调用绑定 | 必须跨提交到完成保持有效 |
| 性能结果 | 以实测数据填写 | 以实测数据填写 |
不要预设 io_uring 一定更快。小连接数、短请求或业务逻辑占比高时,I/O 模型差异可能被其他成本淹没;只有在相同负载下看到稳定的吞吐、尾延迟或 CPU 改善,替换才有量化依据。
为切换保留可回退路径
上线时保留同一业务接口下的两个后端,可以通过启动参数或配置选择实现。先用功能测试确认响应字节、错误语义和连接关闭行为一致,再在相同压测场景中对照指标,最后小流量启用 io_uring。
如果新后端出现 CQE 积压、取消异常、内核兼容问题或尾延迟回退,可以直接切回 epoll,而不需要回滚业务代码。稳定的接口不仅方便替换,更重要的是把性能实验变成可控、可验证、可撤销的工程改动。