
计算机网络 / 系统课时
单Reactor为什么会被业务拖慢
单Reactor为什么会被业务拖慢
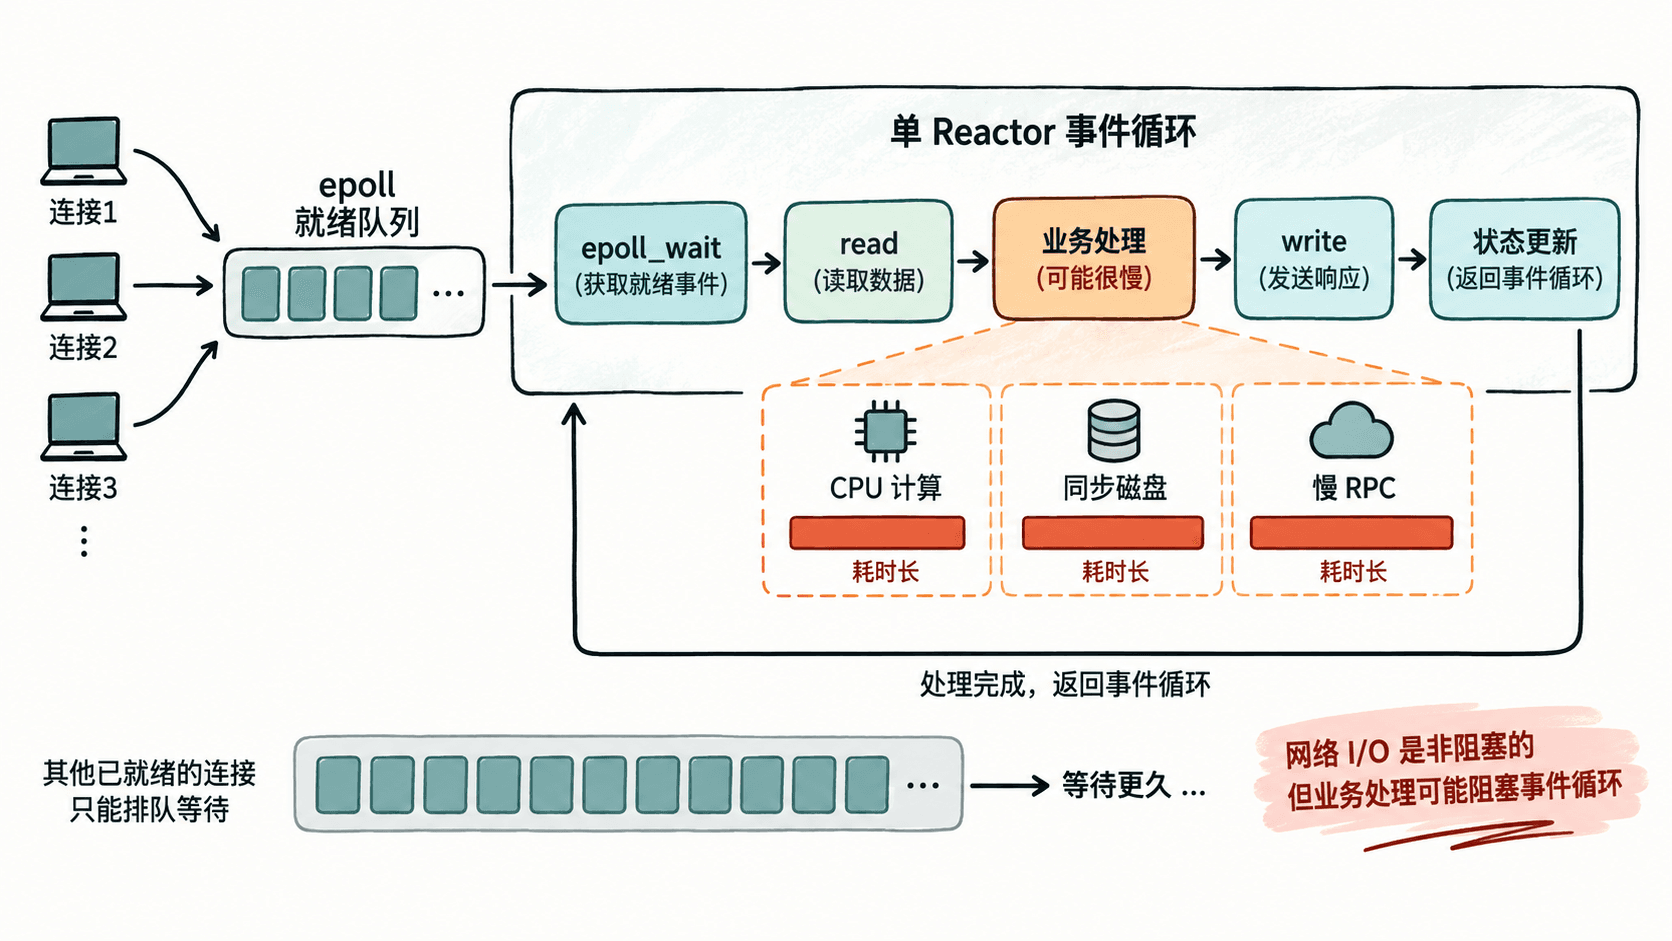
单 Reactor 的瓶颈往往不在 epoll,而在事件回调里做了太多事。只要某个可读事件进入业务计算、同步磁盘或慢 RPC,事件循环就无法继续处理其他就绪连接。本节用最小实验观察这条阻塞链路,并划清网络 I/O 与业务执行的边界。
学习目标
- 解释慢业务如何把单 Reactor 的事件循环整体拖住
- 区分“非阻塞网络 I/O”和“业务代码不会阻塞”这两个概念
- 判断哪些工作应留在 I/O 线程,哪些应移出事件循环
阻塞发生在事件循环哪里
Reactor 的核心节奏是“等待就绪事件 → 读取或写入少量数据 → 更新连接状态 → 尽快返回事件循环”。epoll_wait 返回后,多个连接可能已经同时就绪,但单 Reactor 仍然只能逐个执行回调。
如果第一个回调里做 300 ms 的压缩、数据库查询、同步文件读取或远程调用,这 300 ms 内其他就绪连接不会被处理。即使所有 socket 都设置为非阻塞,也只能保证 socket 操作本身不会长时间睡眠,不能约束业务函数、锁、磁盘或第三方库。
用一个最小实验观察排队
下面用 Python selectors 模拟单线程 Reactor。socketpair 预先写入两个字节,事件循环每次只取一个;处理 A 时故意睡眠 300 ms,所以已经到达的 B 只能等下一轮循环。
import selectors
import socket
import time

selector = selectors.DefaultSelector()
reactor_sock, peer_sock = socket.socketpair()
reactor_sock.setblocking(False)
selector.register(reactor_sock, selectors.EVENT_READ)

peer_sock.sendall(b"AB")

for _ in range(2):
    events = selector.select()
    for key, _ in events:
        data = key.fileobj.recv(1)
        print(f"{time.monotonic():.6f} recv {data.decode()}")

        # 用同步睡眠模拟 CPU 重计算、磁盘访问或慢 RPC。
        if data == b"A":
            time.sleep(0.3)

        print(f"{time.monotonic():.6f} done {data.decode()}")

selector.close()
reactor_sock.close()
peer_sock.close()
预期输出
<TIME> recv A
<TIME> done A
<TIME> recv B
<TIME> done B
<TIME> 代表实际时间值。虽然 B 在程序进入事件循环前就已经到达,但它仍要等 A 的慢处理结束,说明“数据已经就绪”和“应用已经有机会处理”是两回事。
I/O 与业务的边界怎么划
适合留在 Reactor I/O 线程里的工作,应当短、可预测,并且直接维护连接状态,例如读取 socket、解析到完整帧、检查协议头、更新发送缓冲区、执行非阻塞 send,以及注册或修改关注事件。
应移出事件循环的通常是耗时不可预测的工作:复杂计算、压缩与编码、大量 JSON 处理、同步数据库访问、文件系统操作、可能等待锁的共享资源,以及任何慢 RPC。判断标准不是“它是不是业务代码”,而是“它最坏情况下会不会长时间占住 I/O 线程”。
判断单 Reactor 是否已经被拖慢
排查时先看事件循环延迟,而不是只看 CPU 使用率。可以记录一次循环从取到就绪事件到重新进入等待的耗时,并同时观察连接排队、请求尾延迟和业务处理耗时。
如果出现“业务处理时间上升 → 事件循环间隔变长 → 已就绪连接等待增加 → P99 延迟放大”的链路,就应优先缩短回调或把慢任务移出 I/O 线程。单 Reactor 并非只能处理简单协议,关键是让它负责快速驱动连接状态,而不是承担不可预测的业务执行时间。