
计算机网络 / 系统课时
阻塞调用为什么会卡住工作线程
阻塞调用为什么会卡住工作线程
阻塞 Socket 的“卡住”不是线程失效,而是线程进入系统调用后,所需条件尚未满足,内核让它睡眠等待。accept、read、write 等待的条件并不相同;只有分清具体在等什么,才能判断何时需要非阻塞 I/O、事件通知或更多工作线程。
学习目标
- 区分
accept、read、write三类阻塞各自在等待什么条件。 - 通过可运行实验观察线程进入阻塞后如何被连接、数据或缓冲区空间唤醒。
- 理解“阻塞线程”与“CPU 忙循环”不是同一种性能问题。
阻塞不是线程一直占着 CPU
当阻塞式 accept 没有可取出的连接、read 没有数据可读时,内核通常会让当前线程睡眠,直到对应事件发生。线程虽然没有继续执行用户代码,但通常也不会持续消耗一个 CPU 核心。
write 的条件更容易被误解。一次小写入往往只是把数据复制到内核发送缓冲区,很快就返回;只有发送缓冲区没有足够空间,而且调用仍是阻塞式时,写线程才需要等待缓冲区重新出现可用空间。
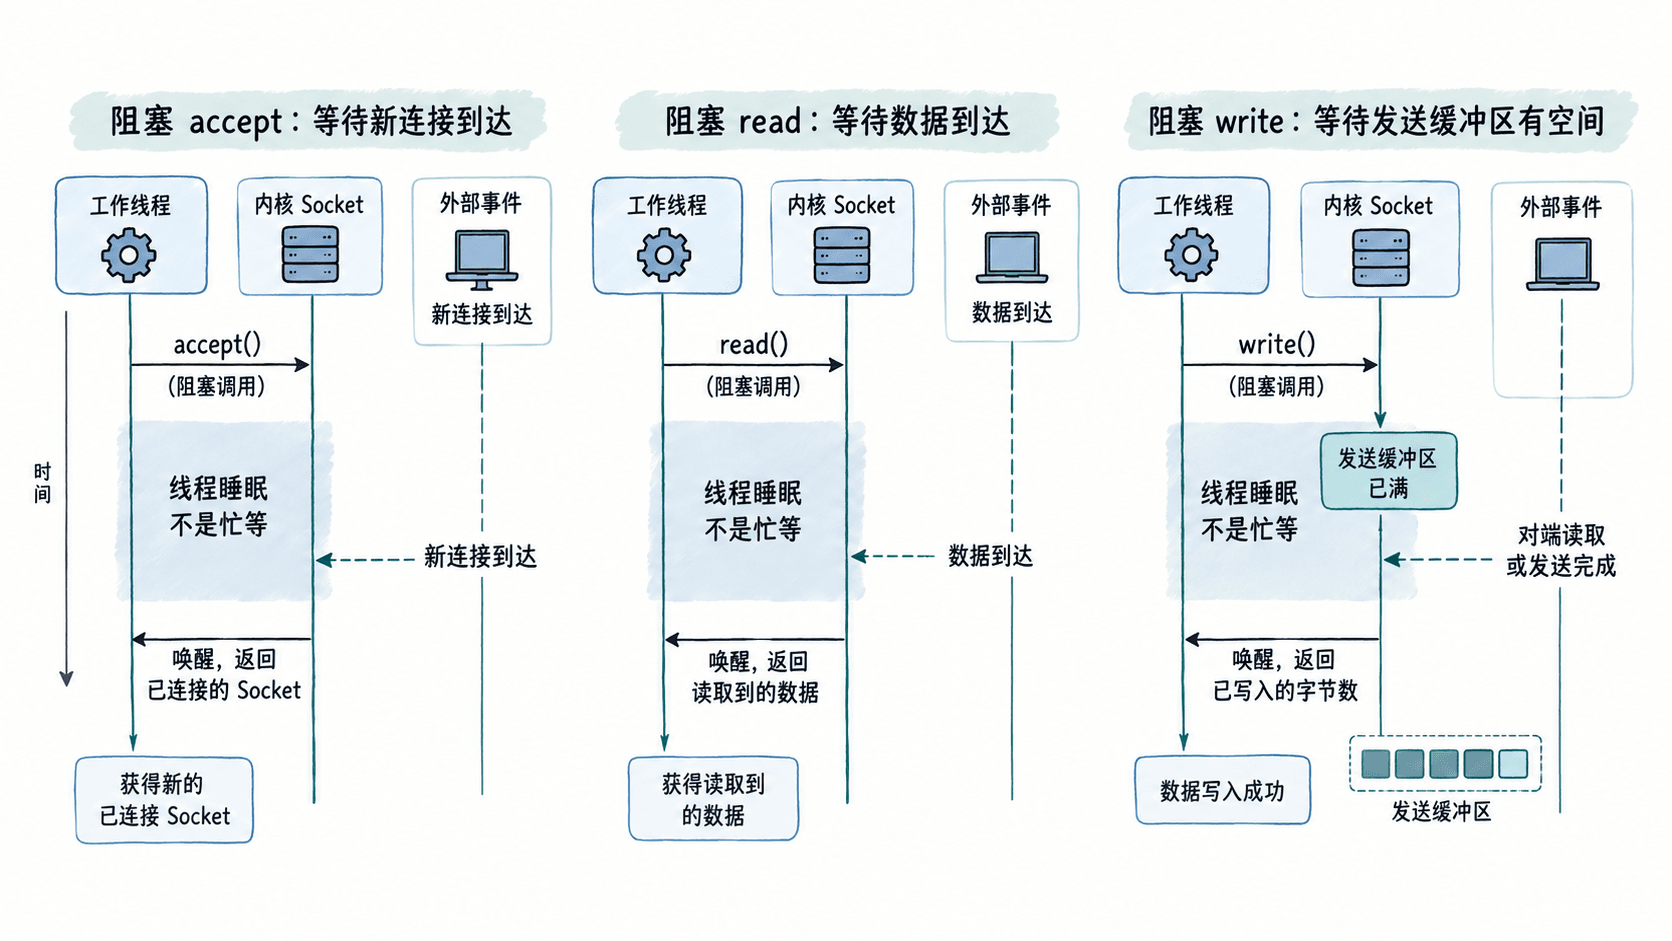
这三种等待都表现为“函数迟迟不返回”,但根因完全不同,所以排查时不能只看到线程停在 Socket 调用就笼统归结为网络慢。
用三个实验观察等待点
下面的 Python 程序分别制造约 1 秒的 accept、read 和写缓冲区等待。读实验直接调用 os.read,写实验循环调用 os.write,便于对应 POSIX 的 read 和 write 语义。
import os
import socket
import threading
import time


def timed(label, func):
    start = time.monotonic()
    func()
    elapsed = time.monotonic() - start
    print(f"{label}: {elapsed:.2f}s")


def experiment_accept():
    listener = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    listener.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    listener.bind(("127.0.0.1", 0))
    listener.listen(1)
    port = listener.getsockname()[1]

    def accept_once():
        conn, _ = listener.accept()
        conn.close()

    t = threading.Thread(target=lambda: timed("accept", accept_once))
    t.start()
    time.sleep(1.0)
    with socket.create_connection(("127.0.0.1", port)):
        pass
    t.join()
    listener.close()


def experiment_read():
    left, right = socket.socketpair()

    def read_once():
        data = os.read(left.fileno(), 4)
        print("read bytes:", data.decode())

    t = threading.Thread(target=lambda: timed("read", read_once))
    t.start()
    time.sleep(1.0)
    right.sendall(b"ping")
    t.join()
    left.close()
    right.close()


def experiment_write():
    left, right = socket.socketpair()
    left.setsockopt(socket.SOL_SOCKET, socket.SO_SNDBUF, 4096)
    payload = b"x" * (1024 * 1024)

    def write_all():
        view = memoryview(payload)
        total = 0
        while total < len(view):
            total += os.write(left.fileno(), view[total:])
        print("write bytes:", total)

    t = threading.Thread(target=lambda: timed("write", write_all))
    t.start()
    time.sleep(1.0)

    received = 0
    while received < len(payload):
        received += len(right.recv(65536))

    t.join()
    left.close()
    right.close()


if __name__ == "__main__":
    experiment_accept()
    experiment_read()
    experiment_write()
预期输出
accept: <TIME>s
read bytes: ping
read: <TIME>s
write bytes: 1048576
write: <TIME>s
三个 <TIME> 通常都接近 1 秒,但线程调度和系统负载会让实际值略有不同。关键不是精确计时,而是每个调用都要等到对应条件成立后才继续。
三种阻塞分别在等什么
accept 等待的是监听 Socket 上出现可接受的连接。没有客户端连接时,一个停在阻塞 accept 的线程就无法同时执行自己的其他业务逻辑。
read 等待的是接收缓冲区中出现可返回的数据,或者连接出现 EOF、错误等终止条件。客户端已经完成 TCP 连接,并不等于服务端下一次 read 一定能马上返回。
write 等待的是本地发送缓冲区重新出现可用空间。对端暂时没有调用 read 不一定立刻导致服务端 write 阻塞,因为内核还能先缓存一部分数据;持续写入使缓冲区压力足够大后,阻塞才会显现。
为什么工作线程会被拖住
阻塞 I/O 的直接成本是“这个线程在等待期间不能去处理另一条连接”。如果采用一连接一线程模型,空闲连接越多,需要保留的线程就可能越多;线程栈、调度和上下文切换带来的成本也会随之增加。
这并不意味着阻塞模型永远错误。连接数很少、请求简单、开发成本更重要时,阻塞代码反而直观可靠。问题出现在并发连接明显上升,而大量线程同时停在 accept、read 或 write 上时。
如果目标是让少量线程同时照看大量连接,就需要把“等待某个 FD 就绪”从阻塞线程里拆出来,交给内核事件通知机制处理;这正是后续 epoll 与 Reactor 要解决的问题。