
计算机网络 / 系统课时
批处理为什么影响io_uring性能
批处理为什么影响io_uring性能
io_uring 的优势不只来自“异步”,还来自一次提交或回收多个请求。批次过小会把收益消耗在频繁进入内核上,批次过大又可能增加等待凑批和完成回收的延迟。本节用可运行实验把提交批次、系统调用和队列深度拆开看。
学习目标
- 理解提交批次、完成批次与队列深度分别控制什么
- 能解释批次大小如何同时影响吞吐、CPU 开销和尾延迟
- 能用小实验验证“减少提交次数”与“性能更好”不是同一件事
批处理减少了什么开销
普通做法是每准备一个请求就立刻提交。io_uring 允许先连续取得多个 SQE,填入 Submission Queue,再一次调用提交接口。批次从 1 增大到 B 时,处理 N 个请求所需的提交调用次数大致从 N 降到 ceil(N / B)。
这减少的是用户态到内核态的固定成本、提交路径上的检查,以及高频小提交造成的指令和缓存扰动。它并不会让一次 I/O 本身变快,因此批次收益通常在高事件率、小请求和 CPU 已接近瓶颈时更明显。
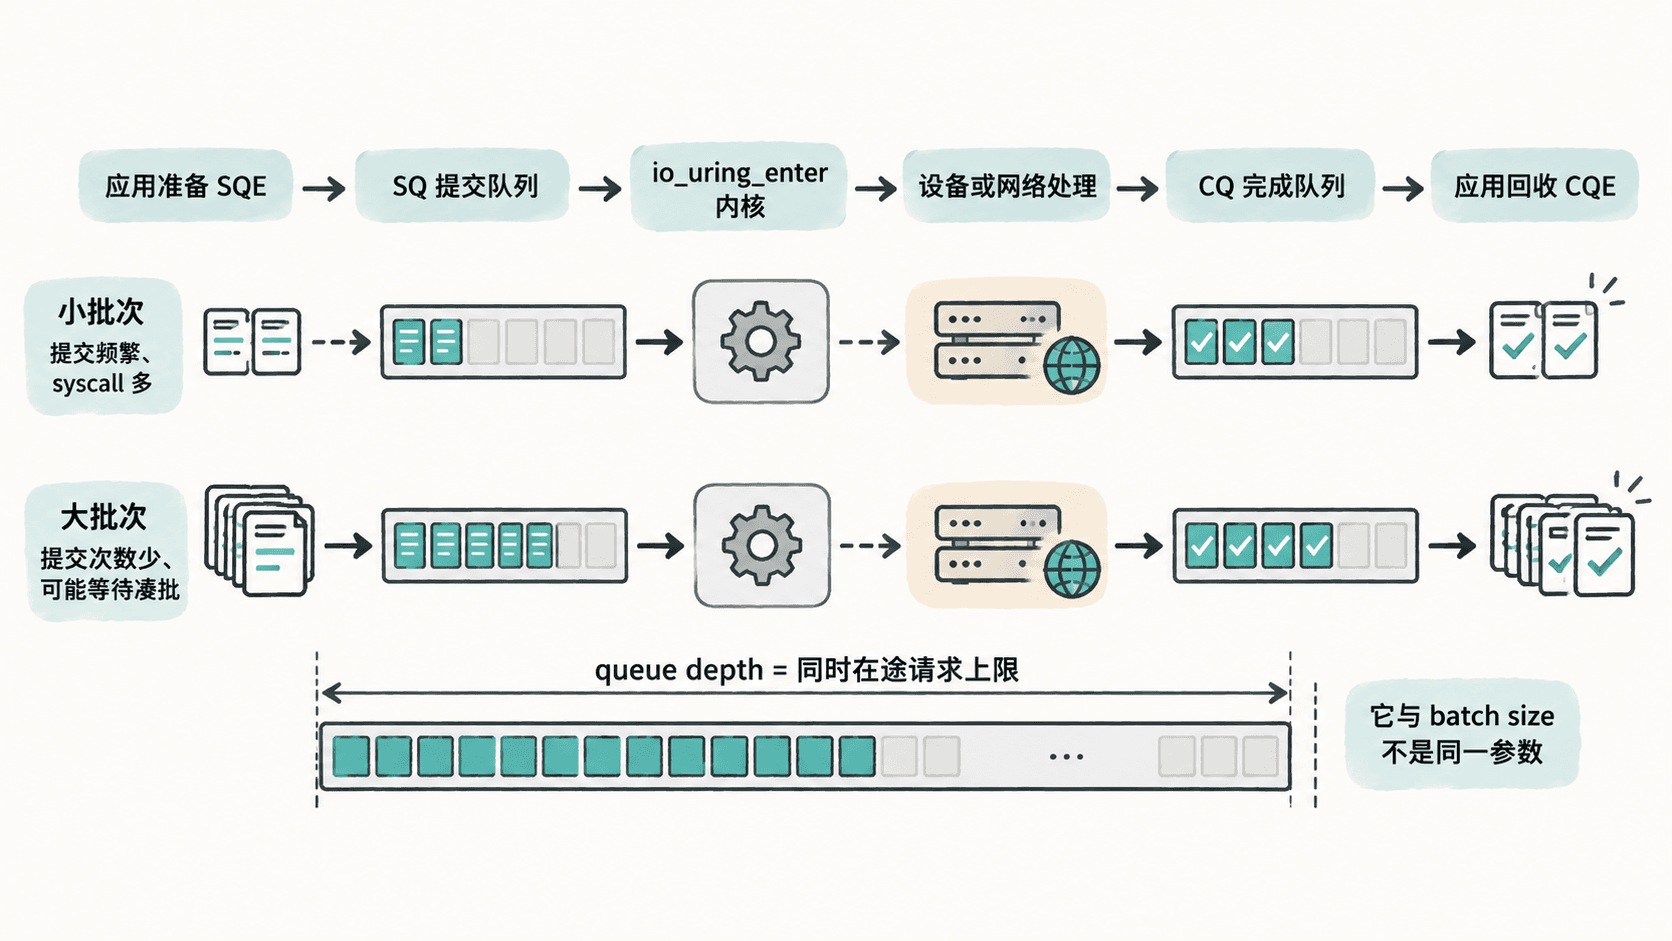
批次大小和队列深度不要混为一谈
批次大小描述一次准备或一次回收多少条请求;队列深度描述允许多少请求同时处于在途状态。批次为 16、队列深度为 128,意味着程序可以每次提交 16 个请求,同时让多个批次留在内核处理中。
如果批次很大但每提交一批就等待这一批全部完成,实际并发仍然不高。反过来,队列深度很大但每次只提交 1 个请求,会保留并发能力,却可能产生大量提交调用。因此调优时要分别观察“每秒提交次数”和“平均在途请求数”。
用NOP实验隔离提交批次
下面的示例需要 Linux、liburing 开发包和 C 编译器。它用 NOP 请求排除磁盘或网络设备差异,只改变每次提交的 SQE 数量,并统计 io_uring_submit() 调用次数。
set -euo pipefail

cat > batch_demo.c <<'EOF'
#include <liburing.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>

static uint64_t now_ns(void) {
    struct timespec ts;
    clock_gettime(CLOCK_MONOTONIC, &ts);
    return (uint64_t)ts.tv_sec * 1000000000ULL + (uint64_t)ts.tv_nsec;
}

static void run_batch(unsigned batch, unsigned total) {
    struct io_uring ring;
    int rc = io_uring_queue_init(128, &ring, 0);
    if (rc < 0) {
        fprintf(stderr, "queue_init: %s\n", strerror(-rc));
        exit(1);
    }

    unsigned done = 0;
    unsigned submit_calls = 0;
    uint64_t start = now_ns();

    while (done < total) {
        unsigned n = batch;
        if (n > total - done) {
            n = total - done;
        }

        for (unsigned i = 0; i < n; ++i) {
            struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
            if (sqe == NULL) {
                fprintf(stderr, "no free SQE\n");
                exit(1);
            }
            io_uring_prep_nop(sqe);
        }

        int submitted = io_uring_submit(&ring);
        if (submitted < 0) {
            fprintf(stderr, "submit: %s\n", strerror(-submitted));
            exit(1);
        }
        if ((unsigned)submitted != n) {
            fprintf(stderr, "partial submit: %d/%u\n", submitted, n);
            exit(1);
        }
        ++submit_calls;

        for (unsigned i = 0; i < n; ++i) {
            struct io_uring_cqe *cqe;
            rc = io_uring_wait_cqe(&ring, &cqe);
            if (rc < 0) {
                fprintf(stderr, "wait_cqe: %s\n", strerror(-rc));
                exit(1);
            }
            if (cqe->res < 0) {
                fprintf(stderr, "cqe error: %s\n", strerror(-cqe->res));
                exit(1);
            }
            io_uring_cqe_seen(&ring, cqe);
        }

        done += n;
    }

    uint64_t elapsed = now_ns() - start;
    printf("batch=%u submit_calls=%u elapsed_ns=%llu\n",
           batch, submit_calls, (unsigned long long)elapsed);
    io_uring_queue_exit(&ring);
}

int main(void) {
    const unsigned batches[] = {1, 4, 16, 64};
    for (unsigned i = 0; i < sizeof(batches) / sizeof(batches[0]); ++i) {
        run_batch(batches[i], 4096);
    }
    return 0;
}
EOF

cc -O2 -Wall -Wextra batch_demo.c -luring -o batch_demo
./batch_demo
预期输出
batch=1 submit_calls=4096 elapsed_ns=<TIME_NS>
batch=4 submit_calls=1024 elapsed_ns=<TIME_NS>
batch=16 submit_calls=256 elapsed_ns=<TIME_NS>
batch=64 submit_calls=64 elapsed_ns=<TIME_NS>
<TIME_NS> 会随 CPU、内核和系统负载变化,但提交调用次数是确定的。这个实验只能证明批处理减少了应用层提交次数;要判断真实网络服务是否更快,还必须继续观察吞吐、CPU 和延迟。
为什么批次过大也会变慢
如果应用为了凑满一批才提交,批次越大,最早到达的请求等待时间越长;完成侧如果等到 CQE 积累到较大数量才处理,也会推迟上层看到完成事件的时间。吞吐可能继续上升,但 P99 或 P999 延迟会先恶化。
工程上通常从小批次开始逐步增加,保持连接数、请求大小和并发度不变,同时记录每秒提交次数、CPU 使用率、吞吐和尾延迟。找到“提交次数已经明显下降,但尾延迟尚未拐头上升”的区间,比追求单一最大批次更可靠。