
计算机网络 / 系统课时
高连接数下应该看哪些指标
高连接数下应该看哪些指标
连接数升高并不等于系统正在做更多有效工作。大量空闲连接可能只占用文件描述符和内存,而高事件率才会把事件循环、syscall 与 CPU 推向瓶颈。本节建立一条统一观察链,把连接、事件、系统调用、CPU、延迟和吞吐放在同一时间窗口里解释。
学习目标
- 区分连接存量、事件速率和请求吞吐,避免只盯在线连接数
- 用归一化指标判断 syscall 是否因批处理不足或无效唤醒而放大
- 根据 CPU、吞吐和尾延迟的组合识别不同瓶颈形态
先把六类指标放到同一条链上
高连接数分析最容易犯的错误,是把不同含义的指标直接横向比较。连接数是“存量”,事件数、syscall 次数和吞吐是“速率”,CPU 是资源消耗,延迟是用户看到的结果。它们必须使用同一采样窗口和相同流量模型。
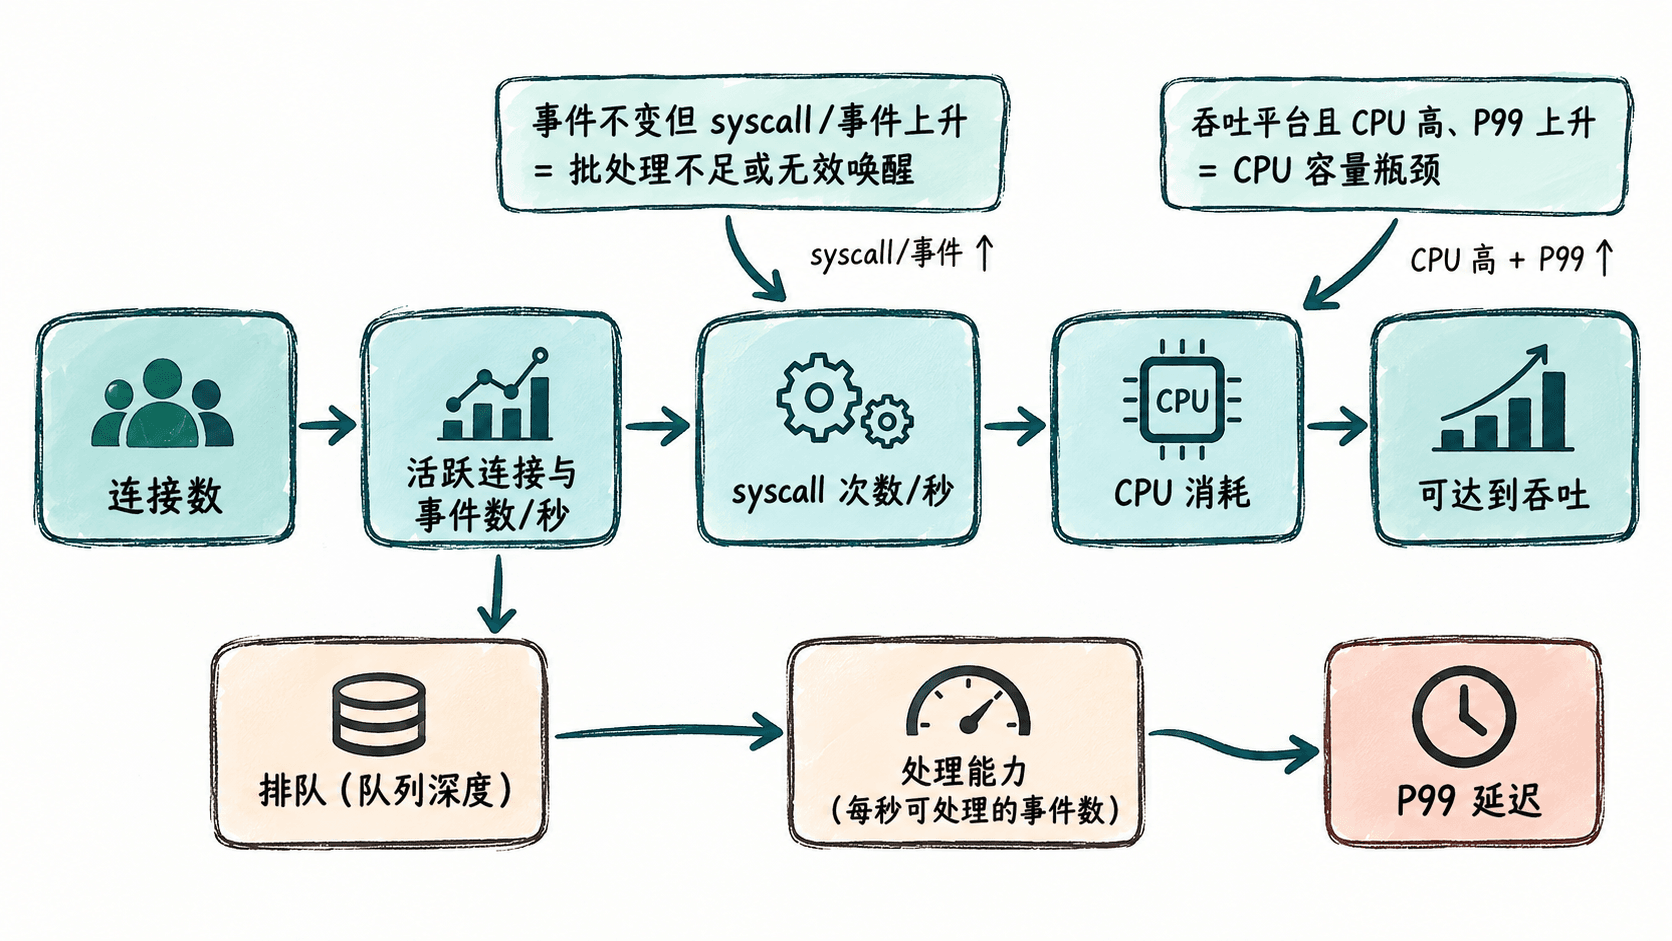
| 指标 | 先转换成什么 | 主要回答的问题 |
|---|---|---|
| 连接数 | 当前 established 数量 | 系统挂着多少连接 |
| 事件数 | events/s | 事件循环实际被触发多频繁 |
| syscall | syscalls/s、syscalls/event | 内核边界开销是否被放大 |
| CPU | 进程 CPU%、每千请求 CPU | 处理每单位业务要消耗多少计算 |
| 延迟 | P50、P99、P999 | 排队和处理抖动是否扩大 |
| 吞吐 | req/s、msg/s 或 bytes/s | 最终完成了多少有效工作 |
用比率而不是只看绝对值
绝对值会随着连接规模变化,真正有诊断价值的是比率。例如 events / connections 能区分“连接很多但大多空闲”和“连接很多且都很活跃”;syscalls / events 能观察每个事件平均触发多少次内核交互;syscalls / requests 则能看系统调用成本是否被业务吞吐摊薄。
下面用一组固定快照计算这些比率。实际采集时,把同一 1~10 秒窗口内的真实数据替换进去即可。
from dataclasses import dataclass

@dataclass
class Snapshot:
    connections: int
    events_per_s: int
    syscalls_per_s: int
    cpu_percent: float
    p99_ms: float
    throughput_rps: int

s = Snapshot(
    connections=50000,
    events_per_s=120000,
    syscalls_per_s=15000,
    cpu_percent=320.0,
    p99_ms=12.4,
    throughput_rps=80000,
)

print(f"events_per_conn_s={s.events_per_s / s.connections:.3f}")
print(f"syscalls_per_event={s.syscalls_per_s / s.events_per_s:.3f}")
print(f"syscalls_per_request={s.syscalls_per_s / s.throughput_rps:.3f}")
print(f"cpu_points_per_1k_rps={s.cpu_percent / s.throughput_rps * 1000:.3f}")
print(f"p99_ms={s.p99_ms:.1f}")
预期输出
events_per_conn_s=2.400
syscalls_per_event=0.125
syscalls_per_request=0.188
cpu_points_per_1k_rps=4.000
p99_ms=12.4
这里的 320% CPU 表示进程大约消耗 3.2 个逻辑 CPU 的计算时间。单次快照没有好坏结论,价值在于和相同请求大小、相同连接活跃度下的基线对比。
常见指标组合怎么解释
如果连接数持续上升,但 events/s、CPU 和吞吐基本不变,说明新增连接大多空闲;这时应优先检查文件描述符、socket 内存和保活策略,而不是盲目优化事件循环。
如果 events/s 基本不变,而 syscalls/event 明显升高,通常意味着批处理不足、频繁唤醒或重复控制操作。此时即使连接数没变,CPU 也可能上涨,而吞吐没有同比增加。
如果吞吐进入平台期、CPU 接近可用核心上限,同时 P99 快速上升,往往是处理能力已经饱和,后续事件只能排队。若 CPU 并不高却 P99 上升,则要继续查锁竞争、阻塞 I/O、队列等待或下游服务,而不能把问题简单归因于连接数。
建立可复现的观测顺序
先固定连接规模、请求大小、协议行为和压测速率,再选择统一采样窗口。连接数可以来自 ss,CPU 可用 pidstat 或 perf,syscall 分布可用 strace -c 或 perf tracepoint,事件数最好直接由事件循环埋点提供,延迟和吞吐则来自压测端或业务指标。
每次只改变一个变量,例如连接数从 1 万升到 5 万,其他条件保持不变。随后比较 events/connection、syscalls/event、CPU/throughput 与 P99 的变化方向。这样才能把“连接更多”与“工作更多”“内核交互更多”区分开,避免用相关性替代根因判断。