
计算机网络 / 系统课时
吞吐上不去时先排哪一层
吞吐上不去时先排哪一层
吞吐停在某个上限时,最浪费时间的做法是直接改业务代码。更可靠的方式是从压测端开始,沿网络、内核、事件循环直到业务处理逐层排除,把“流量根本没送到服务”与“服务收到却处理不动”分开。
学习目标
- 建立客户端、网络、内核、事件循环、业务处理的固定排查顺序。
- 用每一层的输入、输出和饱和证据判断瓶颈是否已经出现。
- 通过本机与远端对照压测缩小问题范围,避免跨层猜测。
先按流量路径逐层排除
吞吐的上限一定出现在请求路径上的某一层:压测客户端发不出来、网络送不到、内核收不进来、事件循环取不走,或业务处理完成不了。排查顺序应与数据流方向一致,因为上游没有提供足够负载时,下游指标“很轻松”没有诊断价值。
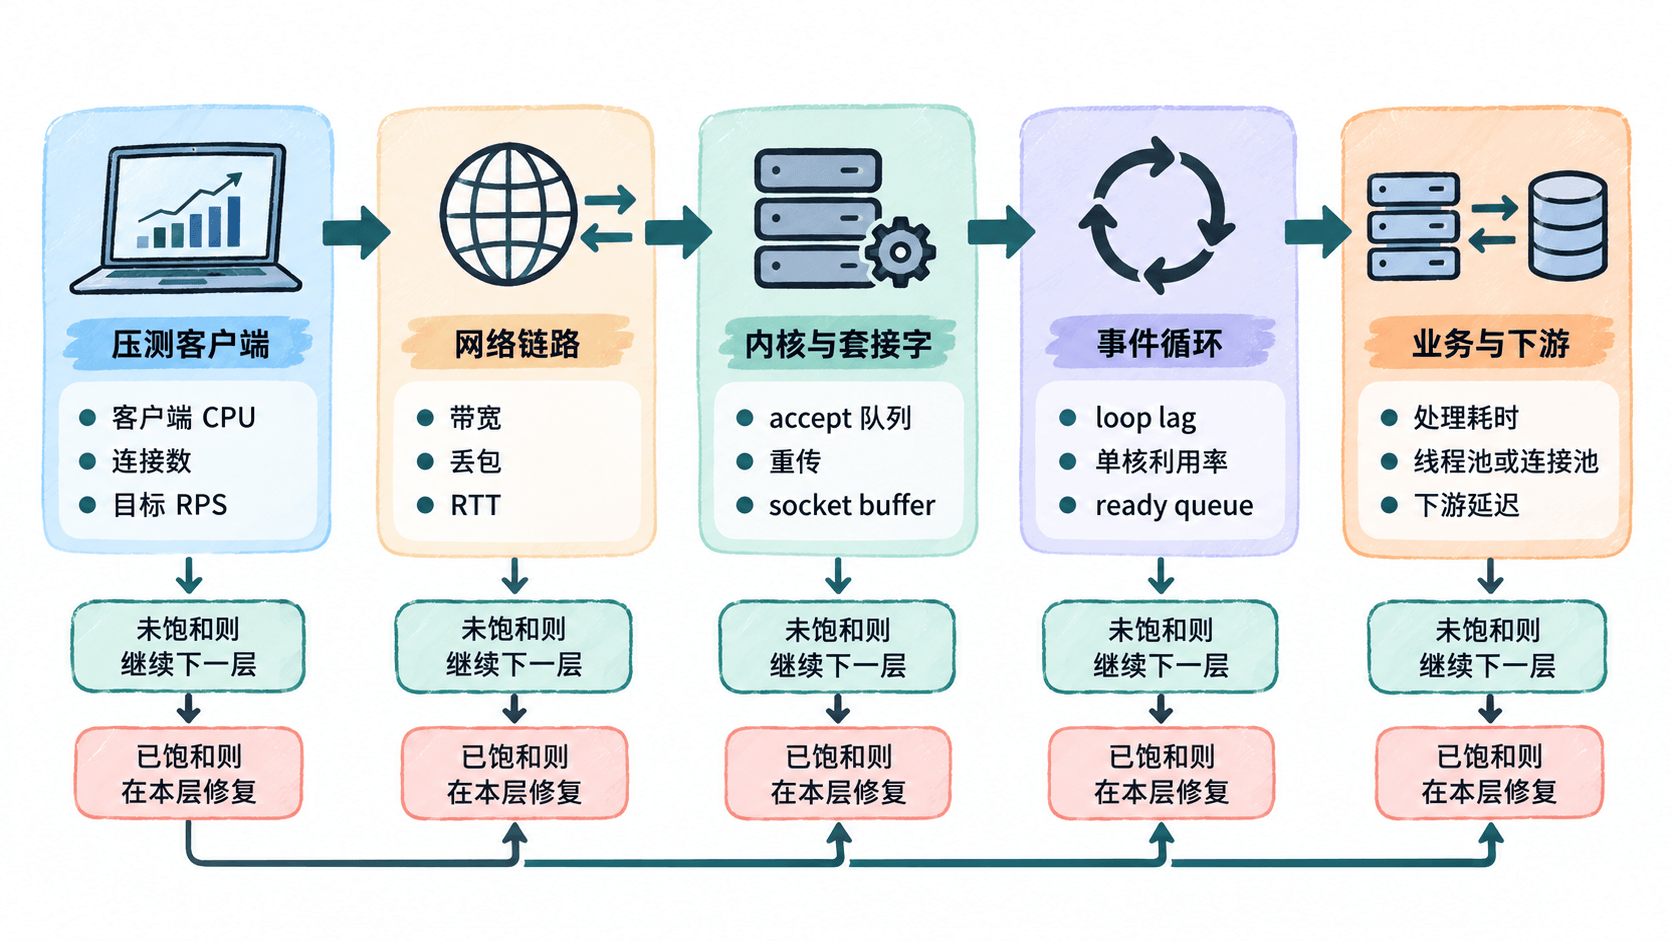
每一层都只回答一个问题:它的输入是否足够,它的输出是否跟得上,以及是否出现饱和证据。不要看到服务 CPU 不高就跳过客户端和网络,也不要看到丢包就立刻认定它是吞吐上限,必须确认丢包与吞吐拐点是否同时出现。
先证明压测端真的能把流量打满
先在服务本机做一次基线,再从远端压测机重复相同配置。以下示例假设已安装 wrk,并且服务暴露一个轻量 HTTP 端点。保存为 local-throughput.sh 后,以 bash local-throughput.sh <PORT> 运行;线程数、连接数和持续时间需要根据机器能力调整。
#!/usr/bin/env bash
set -euo pipefail

PORT="${1:?usage: $0 <PORT>}"
wrk -t4 -c128 -d15s --latency "http://127.0.0.1:${PORT}/health"
预期输出
Running 15s test @ http://127.0.0.1:<PORT>/health
  4 threads and 128 connections
  Latency   <VALUE>
  Req/Sec   <VALUE>
Requests/sec: <VALUE>
Transfer/sec: <VALUE>
如果本机吞吐明显高于远端,先排网络路径、负载均衡、TLS 或中间代理;如果本机也很低,再进入内核和事件循环。压测端本身也要检查 CPU、文件描述符和连接建立速率,否则服务端看到的低负载只是客户端先饱和了。
再看网络与内核有没有截住吞吐
网络层重点看链路利用率、丢包、重传和 RTT 是否在吞吐拐点附近同步恶化。带宽已接近网卡或云网络上限时,继续优化用户态几乎不会提高吞吐;RTT 上升但带宽未满,则要检查队列、拥塞和中间设备。
进入主机后,看监听队列、连接数、TCP 重传、socket buffer 以及网卡软中断是否异常。accept 队列持续积压说明应用接连接不够快;收包速率正常但应用读取速率跟不上,问题已经从“网络送不到”缩小到“内核到用户态消费不及时”。
再看事件循环是不是局部饱和
事件驱动服务常见“整机 CPU 不高,但某个事件循环线程打满”的情况。此时应观察每核利用率、loop lag、ready queue、每轮处理事件数以及回调执行时间。若一个核心长期接近满载,而其他核心空闲,应先查连接是否均匀分配、回调是否过重,以及是否把阻塞操作放进了事件循环。
如果事件循环取事件很快,但完成率仍上不去,继续看业务线程池、数据库连接池、缓存、RPC 和锁。判断原则仍然是输入输出守恒:收到的请求速率高而业务完成速率低,并且某个池或下游已满,瓶颈才真正落在业务层。
一次只跨一层做验证
排查时把每层的“通过条件”写清楚,能显著减少来回猜测:
| 层级 | 继续向下的条件 | 留在本层处理的信号 |
|---|---|---|
| 客户端 | 实际发送 RPS 达到目标且客户端未饱和 | 客户端 CPU、连接或发包能力先到上限 |
| 网络 | 带宽、丢包、RTT 在目标负载下正常 | 吞吐拐点与带宽、重传或丢包同步恶化 |
| 内核 | accept 与 socket 队列稳定 | 队列持续增长、软中断或协议栈成为热点 |
| 事件循环 | loop lag 低、单核未长期打满 | 单核饱和、ready queue 增长、回调过慢 |
| 业务 | 处理速率能跟上到达率 | 线程池、连接池、锁或下游依赖饱和 |
修复后必须回到同一负载模型重新测吞吐和延迟。如果某层指标恢复正常,但整体 RPS 仍停在原上限,就继续向下一层推进;如果瓶颈转移到新的层级,这是容量被成功释放后的正常现象,而不是前一次优化无效。