
计算机网络 / 系统课时
select 和 poll 为什么会变慢
select 和 poll 为什么会变慢
select 和 poll 都能让一个线程等待多个文件描述符,但“能等待很多”不等于“fd 越多成本仍然稳定”。本节拆开一次等待前后发生的工作,理解集合传递、内核扫描和用户态遍历如何随着 fd 数量增加而放大。
学习目标
- 理解
select与poll在大量 fd 下的共同线性成本。 - 区分集合表示方式不同与核心扫描模型相同这两件事。
- 判断何时性能瓶颈来自 fd 总数,而不是实际活跃连接数。
一次等待要做哪些工作
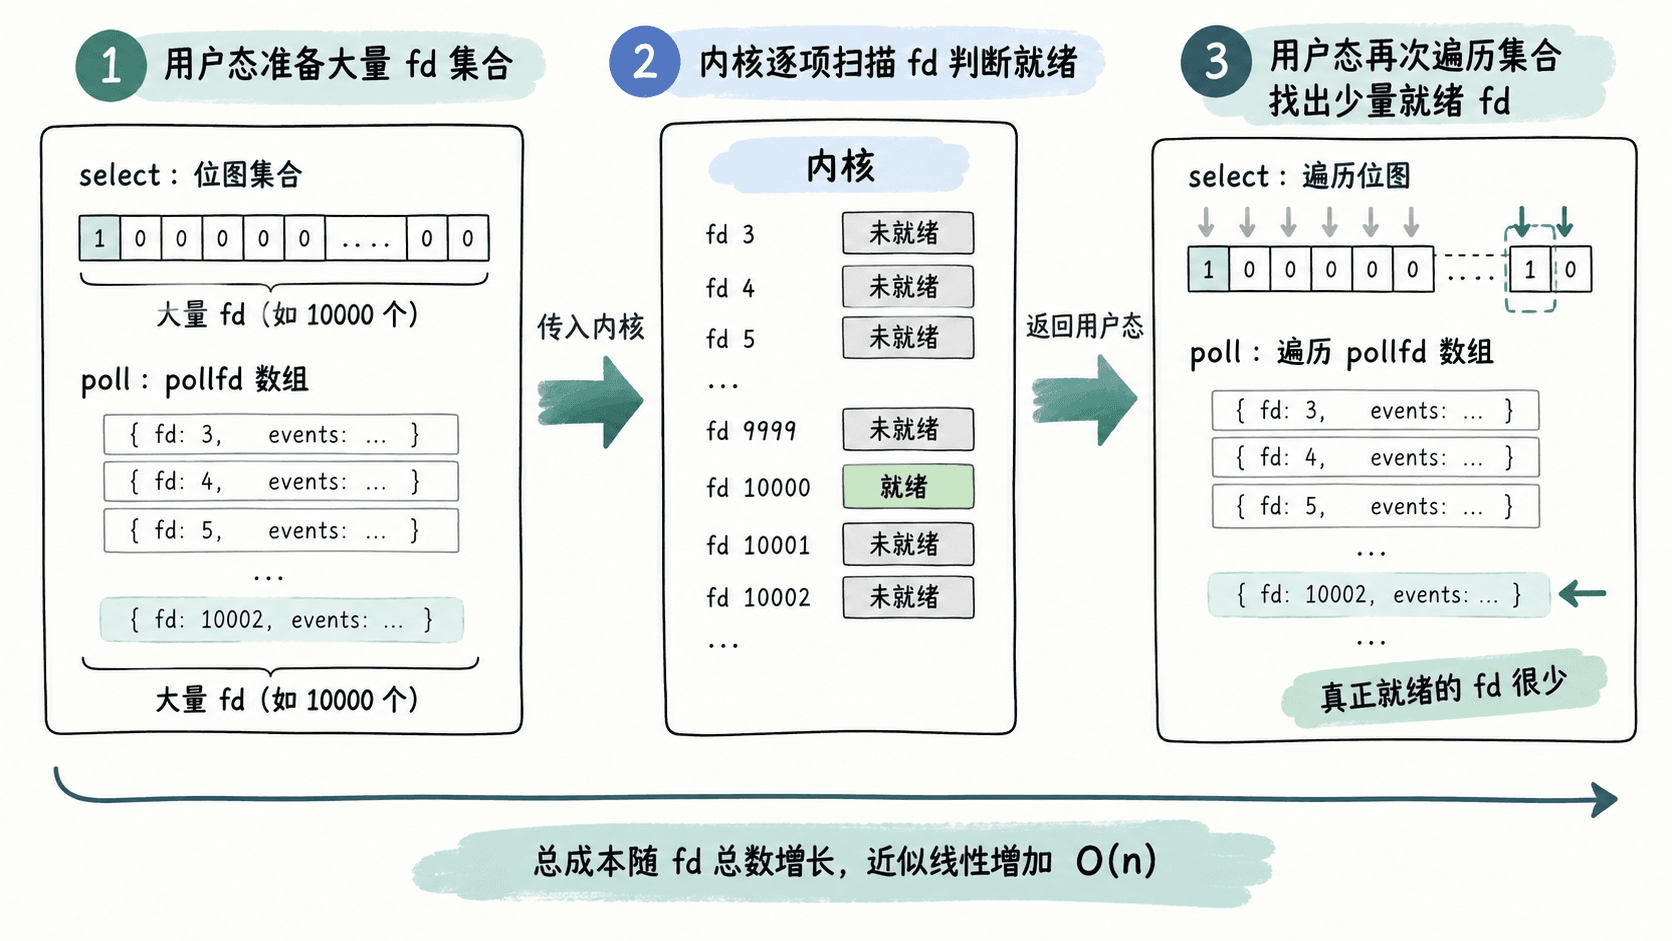
应用调用 select 或 poll 时,不能只告诉内核“帮我等事件”,还要提供本轮关注的文件描述符集合。内核需要检查这些 fd 当前是否满足读、写或异常条件;调用返回后,应用还要找出到底哪些 fd 已经就绪。
这意味着一次事件循环通常包含三类成本:把关注集合传给内核、内核检查集合、用户态遍历返回结果。真正关键的是,这些工作大多与“关注了多少 fd”有关,而不是只与“有多少 fd 就绪”有关。
select 的额外限制
select 使用位集合表示关注的 fd。调用前,应用要准备读、写、异常等集合;调用返回后,这些集合会被修改为“本轮就绪”的结果,因此下一轮等待前通常需要重新构造。
它还有一个常见限制:可表示的 fd 范围受 FD_SETSIZE 约束,很多平台的默认值并不大。即使通过平台支持的方式改变相关限制,核心问题也没有改变:调用仍然需要处理整个关注范围,而不是只处理实际就绪的少量 fd。
因此,select 的性能压力通常同时来自“集合表示受限”和“每轮处理成本随规模增长”。前者是容量问题,后者才是高并发下更根本的复杂度问题。
poll 改进了什么,又没改进什么
poll 不再使用固定大小的 fd 位图,而是接收一个 pollfd 数组,因此它通常不受 FD_SETSIZE 这种固定集合容量的直接约束。应用可以更自然地表示大量 fd,这是相对 select 的明显改进。
但 poll 仍然要把数组交给内核,内核仍需检查数组中的描述符,调用返回后应用仍要遍历结果找出 revents 非零的项。也就是说,它改善了“怎么表示 fd 集合”,却没有改变“每轮扫描整个关注集合”的基本模型。
假设监听 10000 个连接,而一次只有 20 个连接活跃。即使最终只处理 20 个事件,本轮仍可能围绕 10000 个条目产生检查和遍历成本。连接越多、活跃比例越低,这种浪费越明显。
为什么低活跃长连接更容易暴露问题
select 和 poll 并不是连接数一上升就必然不可用。真正需要警惕的是“总 fd 很多、每轮就绪 fd 很少”的场景,例如即时通信、网关长连接、推送服务或大量 keep-alive 连接。
如果大多数连接都很活跃,那么扫描成本至少伴随着较多有效工作;如果绝大多数连接长期空闲,应用会反复为同一批未就绪 fd 付费。此时事件循环的时间会越来越多地花在“寻找有事可做的连接”,而不是处理真正的网络数据。
可以把这种差异理解为:select 和 poll 更接近“每轮问所有人有没有事”,而 epoll 这类就绪通知机制更接近“有事的人进入就绪队列”。后者的优势不是省掉所有内核工作,而是避免应用在每一轮都重新扫描全部关注对象。
判断瓶颈时看什么
排查这类性能问题时,不要只看连接总数。更有价值的是同时观察 fd 总数、每轮就绪数量、事件循环频率和 CPU 占用。如果 fd 总数持续增加,但就绪数长期很少,同时 CPU 花在等待调用前后扫描与分发上的比例上升,就符合线性扫描模型的典型特征。
poll 解决了 select 的集合容量与表达方式问题,却没有从根本上改变扫描成本。理解这一点,才能看清为什么后续的 epoll、kqueue 等机制要维护就绪结果,而不是每轮重新检查整个 fd 集合。