
计算机网络 / 系统课时
读缓冲区为什么需要自己管理
读缓冲区为什么需要自己管理
TCP 只提供连续字节流,不会替应用保存“这一段正好是一条请求”的边界。一次 read 可能只拿到半条消息,也可能同时拿到多条消息。本篇用长度前缀协议设计连接输入缓冲区,让解析器能安全处理半包、粘包和剩余数据。
学习目标
- 理解 TCP 读取结果为什么不能直接等同于一条业务消息
- 能用连接级输入缓冲区保存未消费字节并反复解析完整帧
- 能正确处理半包、粘包、一次读取多帧和异常长度
read返回的只是当前可用字节
假设协议格式是“4 字节大端长度 + N 字节正文”。发送端连续写入两条消息,接收端完全可能得到以下任意切分:
- 第一次只读到 2 字节长度头,属于半包。
- 第一次读到 4 字节长度头和部分正文,仍然是半包。
- 一次读到第一条完整消息加第二条完整消息,表现为粘包。
- 一次读到第一条完整消息和第二条的一部分,需要消费前者并保留后者。
因此,read(fd, buf, size) 的返回值只能说明“这次拿到了多少字节”,不能说明“拿到了一条消息”。协议边界必须由应用层解析器自行恢复。
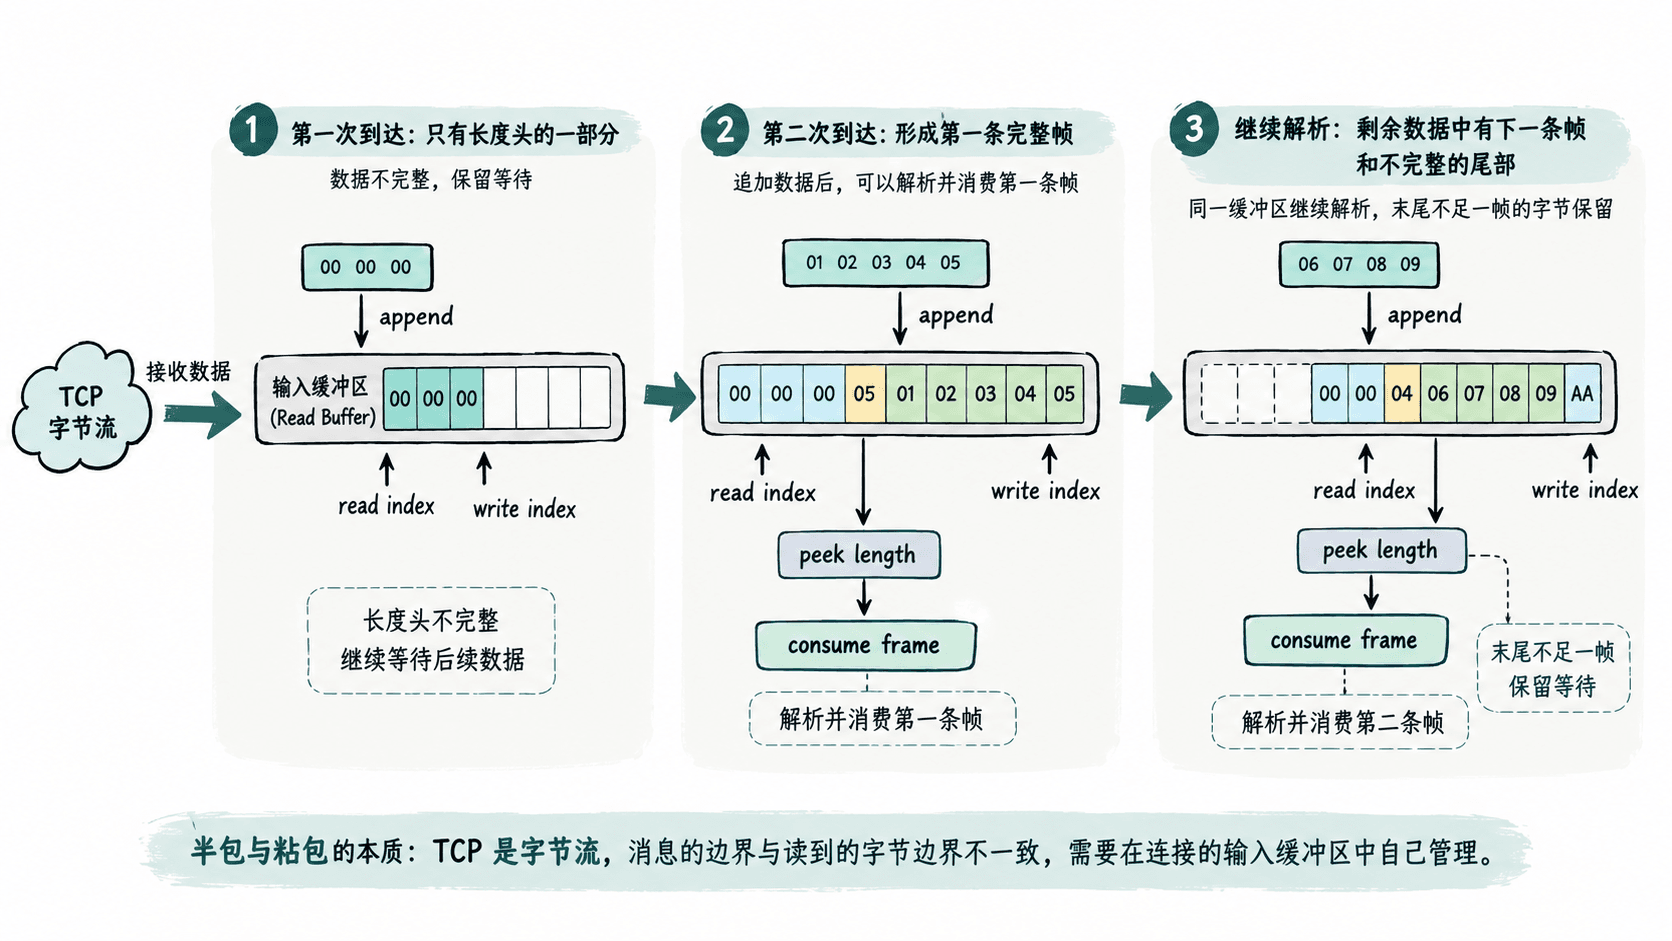
一个可用的缓冲区要保存什么
最小实现至少需要两类状态:尚未消费的字节,以及当前已消费到的位置。简单场景可以直接用可增长数组,并在解析成功后删除前缀;高性能实现通常会维护读写索引,避免每解析一帧就整体搬移内存。
解析循环的规则很稳定:
- 缓冲区不足 4 字节,停止解析,等待下次读取。
- 读取长度字段,但先不消费。
- 如果长度非法,立即关闭连接或进入协议错误处理。
- 如果缓冲区不足“4 + 消息长度”,停止解析。
- 缓冲区已经包含完整帧,取出正文并推进读指针。
- 继续循环,因为当前缓冲区里可能还有下一帧。
这里最重要的是“一次 append,循环解析多次”。如果每次网络读取后最多解析一条消息,那么粘在同一次读取里的后续消息就会一直滞留,直到下一次网络事件才有机会处理。
用长度前缀协议验证三种情况
下面的 Python 示例实现一个连接级 FrameDecoder。它使用 bytearray 保存未消费字节,并把 4 字节大端无符号整数解释为正文长度。为了避免恶意长度导致内存膨胀,示例限制单帧最大 1024 字节。
import struct

MAX_FRAME_SIZE = 1024

class FrameDecoder:
    def __init__(self):
        self.buffer = bytearray()

    def feed(self, data: bytes) -> list[bytes]:
        self.buffer.extend(data)
        frames: list[bytes] = []

        while True:
            if len(self.buffer) < 4:
                break

            frame_len = struct.unpack("!I", self.buffer[:4])[0]
            if frame_len > MAX_FRAME_SIZE:
                raise ValueError(f"frame too large: {frame_len}")

            total_len = 4 + frame_len
            if len(self.buffer) < total_len:
                break

            frames.append(bytes(self.buffer[4:total_len]))
            del self.buffer[:total_len]

        return frames

def encode(payload: bytes) -> bytes:
    return struct.pack("!I", len(payload)) + payload

def main():
    decoder = FrameDecoder()
    stream = encode(b"hello") + encode(b"world") + encode(b"!")

    # 故意按不规则边界切分,制造半包和一次读取多帧。
    chunks = [stream[:2], stream[2:11], stream[11:]]

    for index, chunk in enumerate(chunks, start=1):
        frames = decoder.feed(chunk)
        decoded = [frame.decode("utf-8") for frame in frames]
        print(f"chunk {index}: frames={decoded}, buffered={len(decoder.buffer)}")

if __name__ == "__main__":
    main()
运行:
python3 frame_decoder.py预期输出:
chunk 1: frames=[], buffered=2
chunk 2: frames=['hello'], buffered=2
chunk 3: frames=['world', '!'], buffered=0
第一次只有 2 字节,解析器不猜测、不丢弃;第二次追加后刚好得到 hello;第三次读取同时包含两条完整消息,解析循环一次性把两条都消费掉。这就是连接输入缓冲区存在的直接价值。
缓冲区设计还要守住哪些边界
首先要限制帧长度。只检查“当前缓冲区有没有这么多字节”还不够,如果对端声明一个几百 MB 的长度,程序可能持续积累数据直到耗尽内存。长度字段必须在分配或等待之前做上限校验。
其次要区分“已读入”和“已消费”。在 C/C++ 网络库中,常见做法是维护 readerIndex 与 writerIndex:网络读取追加到写指针,协议解析只推进读指针;当可读区耗尽或前部浪费过多时,再统一整理空间。
最后,不要假设一次 recv 会填满你提供的缓冲区,也不要写“循环读取直到凑够一帧”而把事件循环阻塞住。非阻塞 Reactor 中,正确做法是把当前能读到的数据追加进连接缓冲区,解析所有完整帧,然后把不完整尾部留到下一次可读事件。
缓冲区应归连接而不是归请求
输入缓冲区的生命周期应与 TCP 连接一致,因为半条消息可能跨越任意多次可读事件。把缓冲区作为临时局部变量放在一次回调里,会在回调返回时丢失未完成帧;把同一个缓冲区共享给多个连接,则会破坏数据隔离。
当每个连接都有独立缓冲区,解析器只消费完整帧,并对长度设置明确上限时,半包和粘包就不再是特殊故障,而只是“本轮数据不足”或“本轮数据有多帧”这两种普通状态。