
计算机网络 / 系统课时
用故障注入验证背压和恢复
用故障注入验证背压和恢复
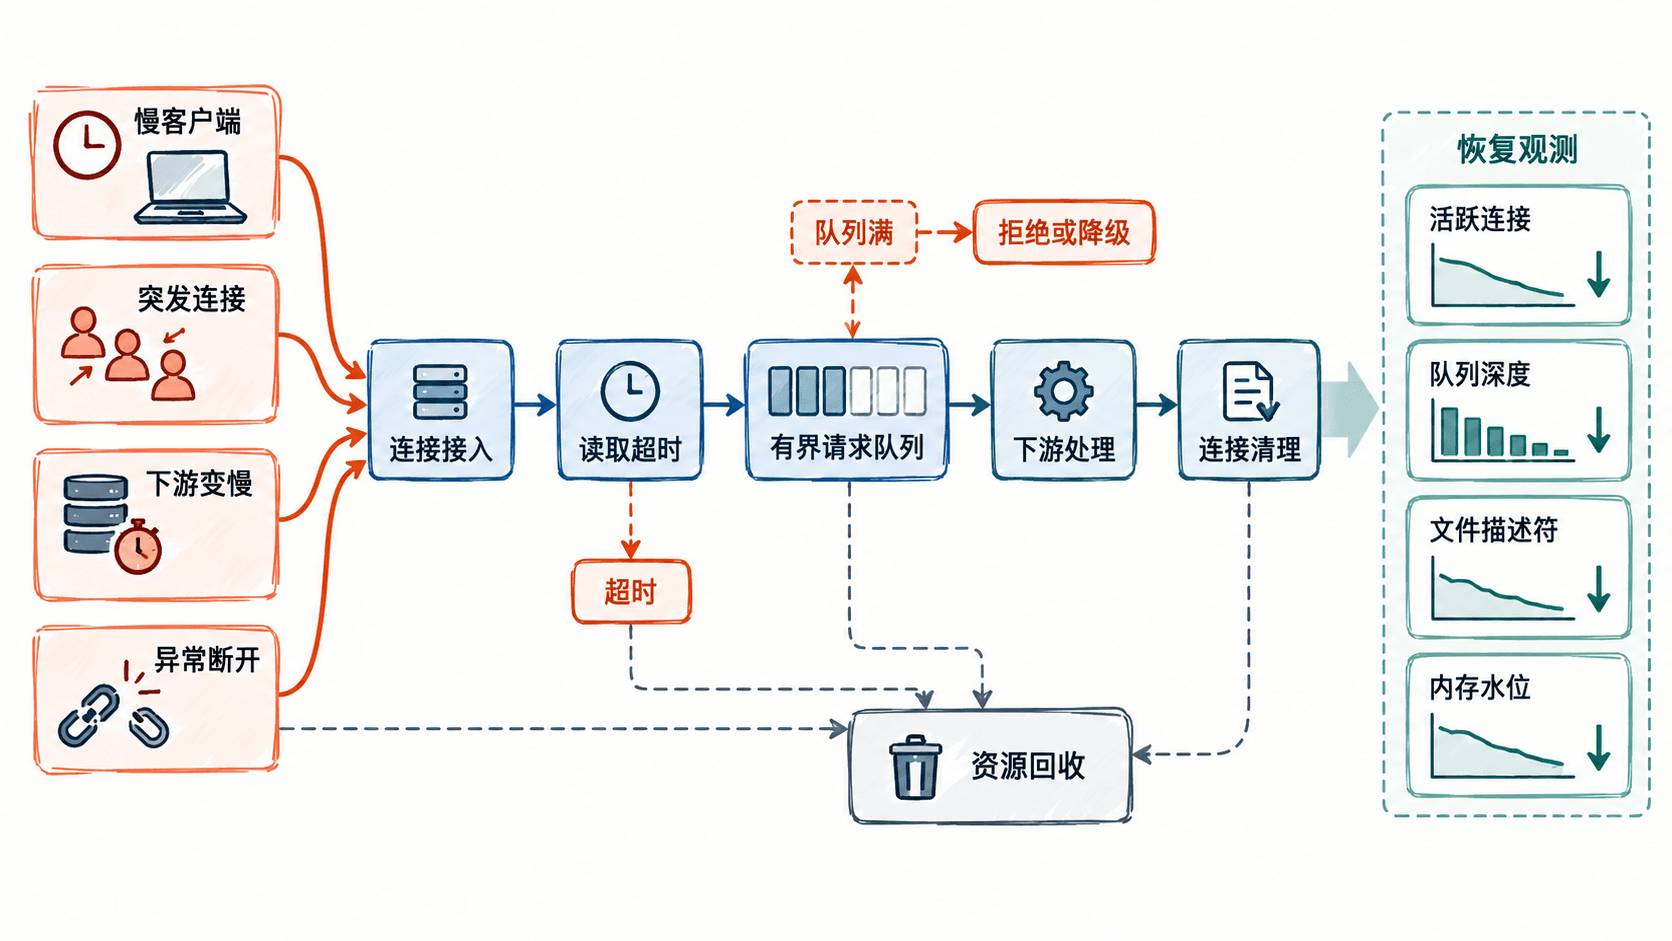
高性能服务真正危险的不是峰值慢,而是压力异常时继续无限接收,最终把队列、内存或文件描述符拖垮。本节用可重复的故障注入,把慢客户端、突发连接、下游变慢和异常断开转成可验证的限流、超时与资源回收条件。
学习目标
- 为慢客户端、连接突发、下游积压和异常断开定义明确的通过条件。
- 用一个可运行的 TCP 实验验证超时、队列背压和连接资源是否能恢复。
- 把故障后的恢复时间、拒绝量和资源水位纳入性能验收,而不是只看正常吞吐。
先定义故障后的通过条件
故障注入不是“把服务弄坏看看”,而是先写清异常出现后系统应该怎样退化。至少同时记录请求成功率、拒绝或超时数量、活跃连接数、待处理队列深度、进程内存与文件描述符数量;故障解除后还要观察这些指标是否回落。
| 故障 | 注入方式 | 期望保护动作 | 恢复验收 |
|---|---|---|---|
| 慢客户端 | 长时间不发完整请求或不读取响应 | 读写超时、限制单连接占用 | 超时连接关闭,活跃连接回落 |
| 突发连接 | 短时间并发建立大量连接 | 接入限流或有界排队 | 峰值后连接数和队列下降 |
| 下游变慢 | 人为增加处理延迟 | 队列达到上限后拒绝或降级 | 下游恢复后队列逐步清空 |
| 异常断开 | 请求中途直接断开 | 捕获重置并进入统一清理路径 | 不遗留连接、任务或缓冲区 |
用最小实验验证背压
下面的 Python 程序只依赖标准库。服务端设置短读超时和容量为 4 的有界队列,下游工作线程故意变慢;客户端分别制造半包慢读、20 个并发请求和中途断开。这个实验验证的是应用层接入与队列背压,生产服务还应额外观测 socket 待发送字节和实际 drain 延迟。
python
import asyncio

READ_TIMEOUT = 0.15
QUEUE_SIZE = 4
DOWNSTREAM_DELAY = 0.20

class Lab:
    def __init__(self):
        self.queue = asyncio.Queue(maxsize=QUEUE_SIZE)
        self.timeouts = 0
        self.rejected = 0
        self.active = 0

    async def worker(self):
        while True:
            item = await self.queue.get()
            try:
                # 故意放慢下游,让有界队列产生可观察的背压。
                await asyncio.sleep(DOWNSTREAM_DELAY)
            finally:
                self.queue.task_done()

    async def handle(self, reader, writer):
        self.active += 1
        try:
            try:
                line = await asyncio.wait_for(reader.readline(), READ_TIMEOUT)
            except asyncio.TimeoutError:
                self.timeouts += 1
                return

            if not line:
                return

            try:
                self.queue.put_nowait(line)
            except asyncio.QueueFull:
                self.rejected += 1
                writer.write(b"BUSY\n")
            else:
                writer.write(b"OK\n")
            await writer.drain()
        except (ConnectionResetError, BrokenPipeError):
            pass
        finally:
            self.active -= 1
            writer.close()
            try:
                await writer.wait_closed()
            except ConnectionResetError:
                pass

async def slow_client(port):
    _, writer = await asyncio.open_connection("127.0.0.1", port)
    writer.write(b"P")
    await writer.drain()
    await asyncio.sleep(READ_TIMEOUT * 2)
    writer.close()
    try:
        await writer.wait_closed()
    except ConnectionResetError:
        pass

async def burst_client(port):
    reader, writer = await asyncio.open_connection("127.0.0.1", port)
    writer.write(b"REQ\n")
    await writer.drain()
    reply = await asyncio.wait_for(reader.readline(), 1.0)
    writer.close()
    await writer.wait_closed()
    return reply.strip()

async def abnormal_disconnect(port):
    _, writer = await asyncio.open_connection("127.0.0.1", port)
    writer.write(b"DROP\n")
    await writer.drain()
    writer.transport.abort()

async def main():
    lab = Lab()
    worker = asyncio.create_task(lab.worker())
    server = await asyncio.start_server(lab.handle, "127.0.0.1", 0)
    port = server.sockets[0].getsockname()[1]

    await slow_client(port)
    replies = await asyncio.gather(*(burst_client(port) for _ in range(20)))
    await abnormal_disconnect(port)

    await lab.queue.join()
    await asyncio.sleep(0.05)

    print(f"PASS slow_client_timeout={lab.timeouts >= 1}")
    print(f"PASS backpressure_rejected={lab.rejected >= 1}")
    print(f"PASS resource_recovered={lab.active == 0}")
    print(
        "INFO "
        f"burst_ok={sum(r == b'OK' for r in replies)} "
        f"burst_busy={sum(r == b'BUSY' for r in replies)}"
    )

    server.close()
    await server.wait_closed()
    worker.cancel()
    try:
        await worker
    except asyncio.CancelledError:
        pass

asyncio.run(main())
预期输出
text
PASS slow_client_timeout=True
PASS backpressure_rejected=True
PASS resource_recovered=True
INFO burst_ok=<N> burst_busy=<N>
两个 <N> 会随调度略有变化,但 burst_busy 应大于 0;前三个布尔值才是本实验的稳定验收条件。若 resource_recovered=False,应优先检查异常路径是否遗漏 close、取消任务或队列清理,而不是先调大连接上限。
把恢复过程纳入压测
单次通过仍不够。更接近生产的做法是在固定基线负载上周期性注入故障,例如让下游延迟升高 30 秒,再恢复正常,然后观察队列和资源水位是否回到基线。若吞吐恢复了但文件描述符持续增长,说明资源泄漏仍然存在。
验收时给每类故障记录“触发阈值、保护动作、恢复时间、残留资源”四项。这样背压就从代码里的一个机制,变成可以在版本回归中重复执行的性能契约。
按自己的节奏,确认真正理解。