
计算机网络 / 系统课时
先测吞吐和延迟再谈优化
先测吞吐和延迟再谈优化
性能优化前先固定服务、压测参数与观测窗口。本节用一条最小链路同时采集并发连接、吞吐、延迟和 CPU,让每次改动都有可比较的基线,而不是只凭“感觉更快”做判断。
学习目标
- 建立包含连接数、吞吐、延迟和 CPU 的最小性能基线。
- 能用固定压测参数重复得到可比较的数据。
- 能根据多项指标判断优化是否真的有效,而不是只看单个 RPS。
先固定可比较的基线
性能数字只有在测试条件一致时才有意义。至少固定服务版本、请求内容、压测时长、线程数、目标并发和运行机器;同一轮对比中不要一边改代码,一边又改变压测参数。
最小基线建议记录四类指标:目标并发连接数、实际吞吐 Requests/sec、延迟分位数以及服务进程 CPU。平均延迟容易掩盖尾部抖动,因此至少同时保留 p50 与 p99。
| 指标 | 关注的问题 |
|---|---|
| 并发连接 | 服务在什么负载规模下被测量 |
| 吞吐 | 单位时间处理了多少请求 |
| p50 / p99 延迟 | 典型请求与尾部请求分别有多慢 |
| CPU | 吞吐增长是否以更多计算资源为代价 |
建立最小压测链路
一条可解释的压测链路至少包含负载发生器、被测服务和观测工具。wrk 负责产生请求并给出吞吐和延迟;pidstat 观察服务进程 CPU;ss 在压测进行中采样服务端 TCP Socket 数量。
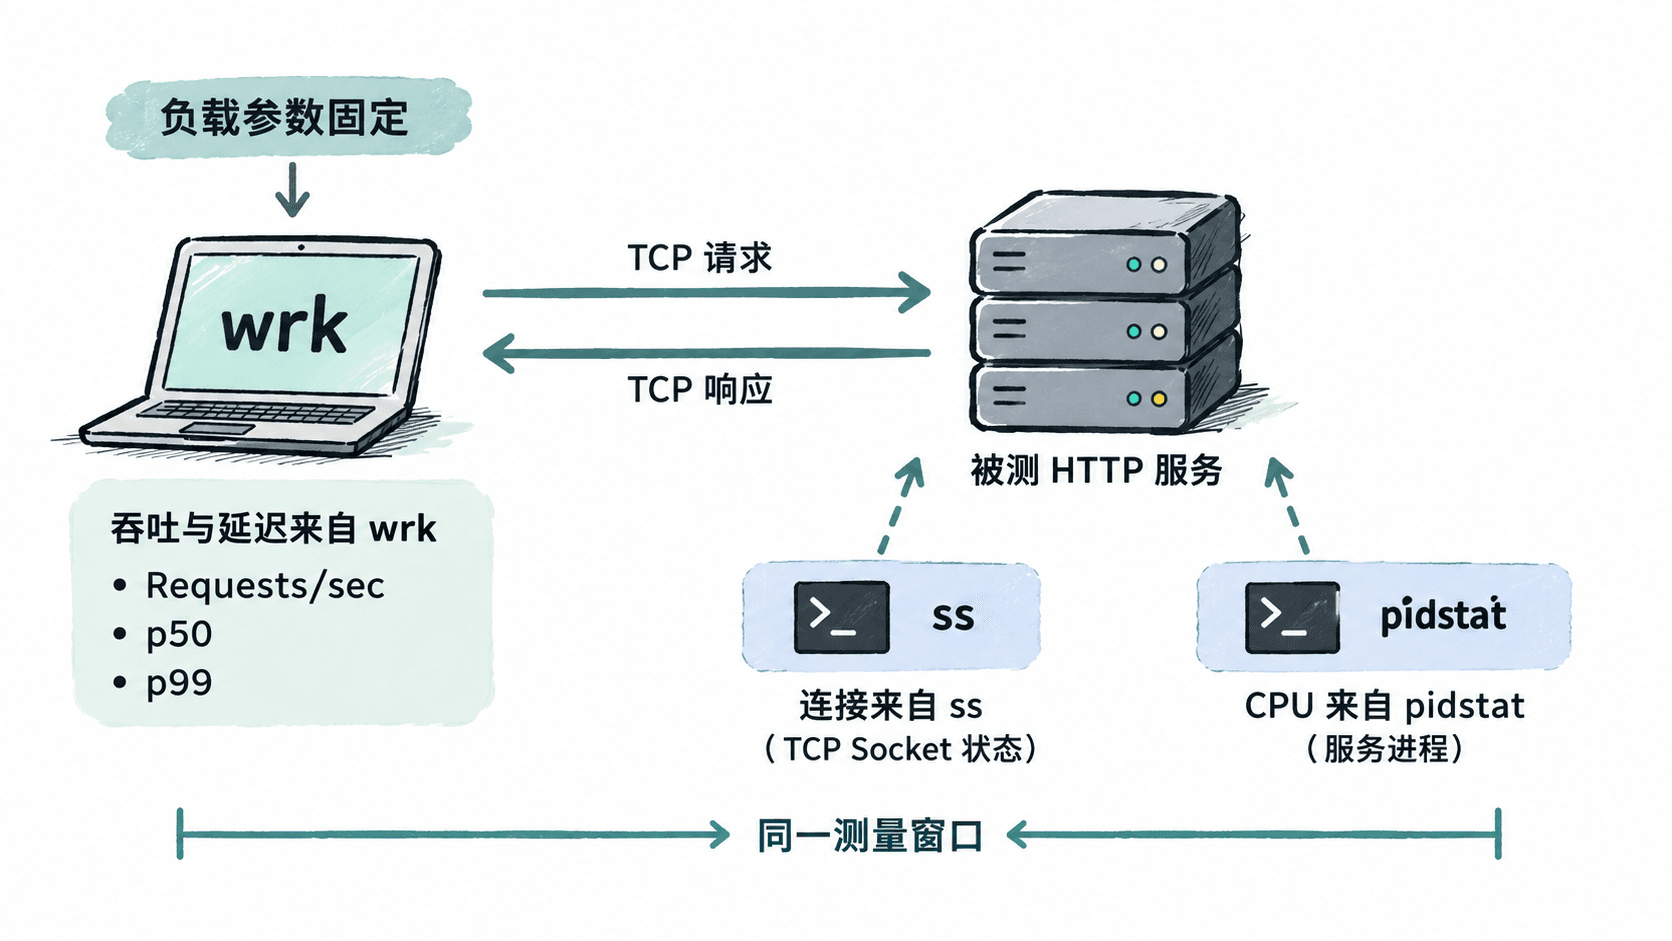
只看吞吐无法判断系统状态。例如 RPS 提高 10%,但 p99 翻倍或 CPU 从 50% 升到 95%,这种变化不一定是可接受的优化。基线的价值在于把“快了多少”和“付出了什么代价”同时记录下来。
跑一次可复现的基线
下面的主示例会临时创建一个返回固定 ok 的 HTTP 服务,然后先预热,再同时运行 wrk、pidstat 和 ss。需要 Linux、Python 3、wrk、pidstat 与 ss;其中 pidstat 通常由 sysstat 软件包提供。
把 <PORT> 替换成本机未占用的数字端口后执行,实际端口可以不同:
set -euo pipefail

PORT="<PORT>"
WORKDIR="$(mktemp -d)"

for cmd in python3 wrk pidstat ss; do
  command -v "$cmd" >/dev/null || {
    echo "missing command: $cmd" >&2
    exit 1
  }
done

cat >"$WORKDIR/server.py" <<'EOF_PY'
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
import sys

class Handler(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"

    def do_GET(self):
        body = b"ok\n"
        self.send_response(200)
        self.send_header("Content-Type", "text/plain")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, fmt, *args):
        pass

port = int(sys.argv[1])
ThreadingHTTPServer(("127.0.0.1", port), Handler).serve_forever()
EOF_PY

python3 "$WORKDIR/server.py" "$PORT" >"$WORKDIR/server.log" 2>&1 &
SERVER_PID=$!
trap 'kill "$SERVER_PID" 2>/dev/null || true; rm -rf "$WORKDIR"' EXIT
sleep 1

wrk -t1 -c16 -d2s "http://127.0.0.1:${PORT}/" >/dev/null

pidstat -u -p "$SERVER_PID" 1 10 >"$WORKDIR/cpu.txt" &
PIDSTAT_PID=$!

wrk -t2 -c64 -d10s --latency "http://127.0.0.1:${PORT}/" >"$WORKDIR/wrk.txt" &
WRK_PID=$!

sleep 2
CONNECTIONS="$(ss -Htan "sport = :${PORT}" | wc -l)"

wait "$WRK_PID"
wait "$PIDSTAT_PID"

cat "$WORKDIR/wrk.txt"
echo "sampled_tcp_connections=$CONNECTIONS"
tail -n 3 "$WORKDIR/cpu.txt"
预期输出
Running 10s test @ http://127.0.0.1:<PORT>/
Latency Distribution
     50%    <P50>
     99%    <P99>
Requests/sec: <RPS>
sampled_tcp_connections=<CONNECTIONS>
Average: ... <PID> ... <CPU_PERCENT> ...<P50>、<P99>、<RPS>、<CONNECTIONS>、<PID> 与 <CPU_PERCENT> 都会随机器和负载变化。这里不追求某个“标准答案”,而是确认每次测试都能稳定产出同一组维度。
用多项指标判断优化是否成立
比较两个版本时,先看压测条件是否完全一致,再看吞吐与延迟是否共同改善。若 RPS 上升且 p99 不恶化,同时 CPU 持平或下降,通常说明单位资源处理能力确实提高;若吞吐上升只是因为 CPU 使用率明显增加,则要判断这是不是预期的资源换性能。
CPU 已接近单核或多核上限、同时延迟持续上升,说明服务可能进入计算或调度饱和区;CPU 很低但吞吐上不去,则还需要继续检查锁竞争、网络等待、连接限制或其他 I/O。单个指标只能给方向,不能直接证明根因。
ss 的采样值也不要机械等同于 wrk -c64。前者看到的是采样时刻符合过滤条件的服务端 TCP Socket,连接建立与关闭、协议复用和采样时机都会让它与目标并发不同。
让每次优化都能复测
把基线结果和版本信息放在同一条记录中,至少保留代码版本、压测命令、机器信息和核心指标。后续每次只改变一个主要因素,例如事件循环策略、缓冲区大小或线程数量,再使用完全相同的负载重新测量。
| 版本 | 并发 | RPS | p50 | p99 | CPU |
|---|---|---|---|---|---|
| baseline | 64 | <RPS_BASE> |
<P50_BASE> |
<P99_BASE> |
<CPU_BASE> |
| changed | 64 | <RPS_NEW> |
<P50_NEW> |
<P99_NEW> |
<CPU_NEW> |
当这张表能回答“吞吐是否提高、尾延迟是否恶化、CPU 代价是否变化”时,才具备继续讨论 epoll、Reactor 或 io_uring 优化效果的可靠起点。