
计算机网络 / 系统课时
io_uring解决的主要开销是什么
io_uring解决的主要开销是什么
io_uring 的价值不在于“让内核不再做 I/O”,而在于改变用户态与内核交换请求和完成结果的方式。本节以 epoll 为基线,拆开系统调用、批量提交和完成通知的成本,避免把它误解成自动零拷贝或万能加速器。
学习目标
- 说明
epoll就绪驱动路径中主要的系统调用与状态切换成本 - 理解 SQ、CQ 如何把逐操作调用改成共享内存上的批量交换
- 判断
io_uring能减少哪些开销,以及哪些成本依然存在
先用 epoll 建立比较基线
典型 epoll 服务先通过 epoll_wait 得到“某个 fd 现在可读或可写”,然后再调用 read、recv、write 或 send 真正执行 I/O。也就是说,就绪通知和实际 I/O 往往是两步;在大量小请求下,系统调用次数、事件重新注册或修改、用户态与内核态之间的往返都会变得显眼。
io_uring 不是简单把 epoll_wait 换成另一个等待函数。它把“要做什么”编码成提交队列项 SQE,把“做完了什么”编码成完成队列项 CQE,使应用可以先准备一批操作,再统一提交和收割结果。
| 维度 | epoll 常见路径 | io_uring 常见路径 |
|---|---|---|
| 驱动方式 | 就绪后再执行 I/O | 提交操作,等待完成 |
| 请求描述 | 每次 I/O 通过系统调用参数传入 | SQE 写入共享映射的提交环 |
| 完成通知 | 先得到 fd 就绪,再调用 I/O | CQE 直接给出完成结果 |
| 批处理 | 需要应用自行组织多次调用 | 原生支持成批准备与提交 |
| 可选优化 | 依赖具体系统调用 | 固定文件、注册缓冲区、SQPOLL 等 |
两个环把高频交互变成批量交换
SQ 和 CQ 都位于用户态与内核共享映射的内存中。应用写入 SQE 后,内核消费这些请求并执行操作;完成后,内核把结果写成 CQE,应用再从 CQ 中读取。一次 io_uring_enter 可以同时承担提交、唤醒和等待等动作,具体何时进入内核通常由 liburing 根据环状态决定。
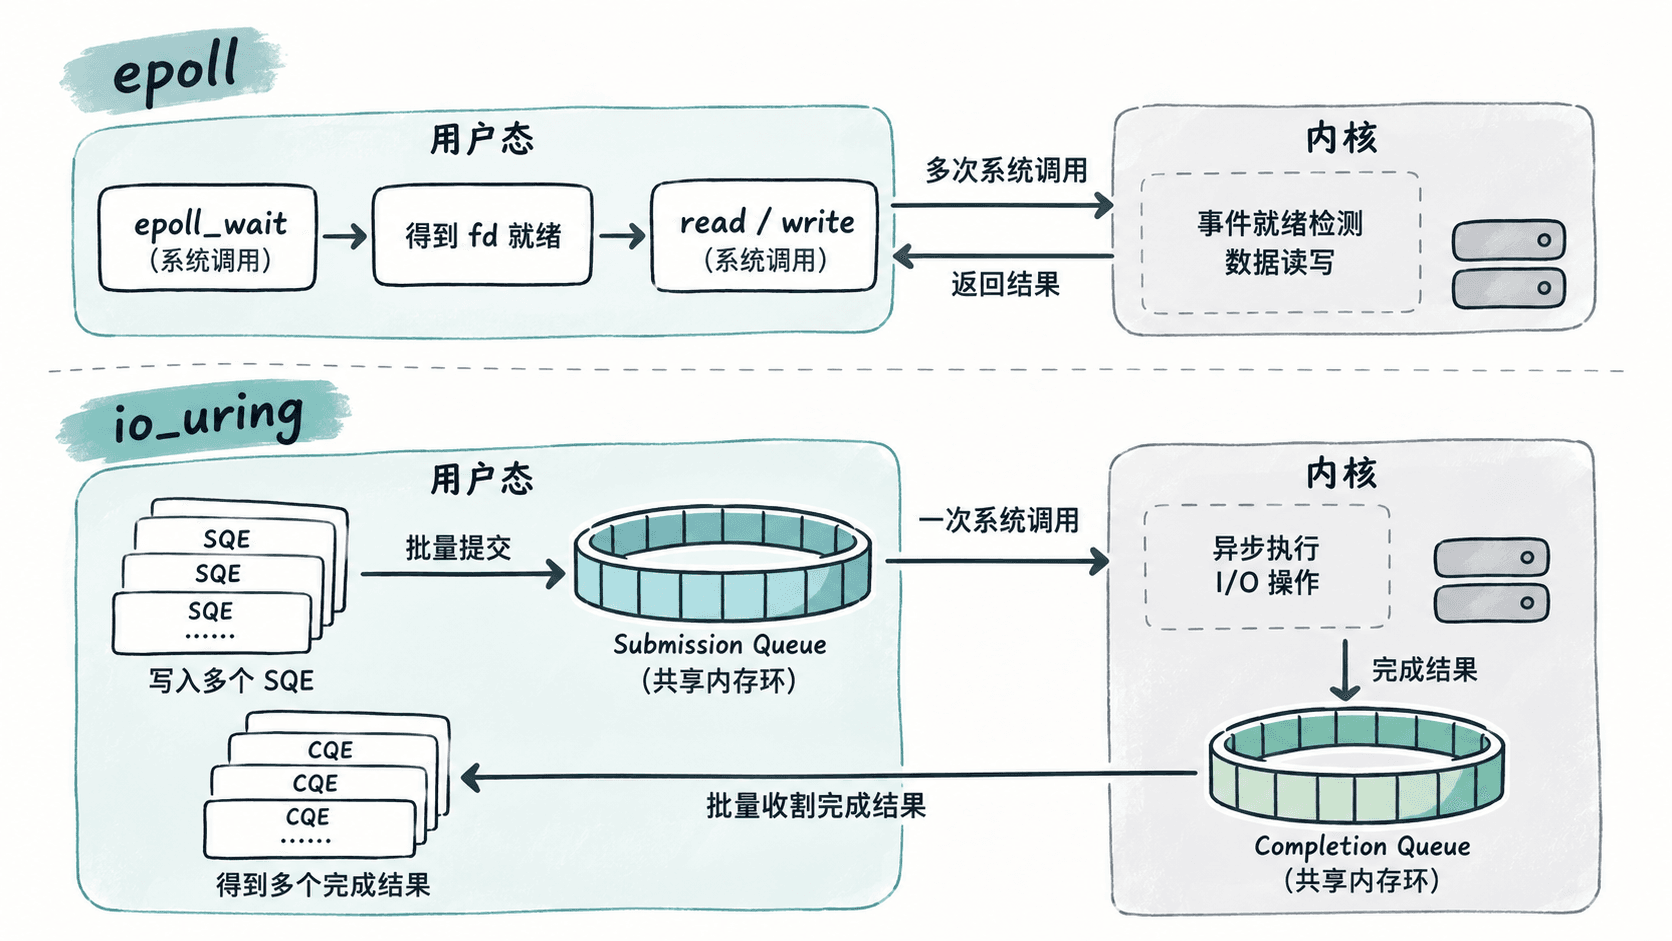
这套设计主要减少三类开销:第一,多个操作可以合并提交,降低“一个操作一次系统调用”的固定成本;第二,应用不必先处理就绪事件再发起同一个 I/O,状态机更短;第三,注册缓冲区、固定文件等机制可以减少部分重复校验和资源查找。若启用 SQPOLL,内核线程还能轮询 SQ,从而在部分场景减少提交时进入内核的次数,但会额外占用 CPU。
用 NOP 观察批量提交语义
下面示例一次准备 8 个 NOP,然后一次调用 io_uring_submit 提交,再从 CQ 中收割 8 个完成事件。它不用于性能基准,只用于验证“先批量准备,再批量完成”的基本模型。系统需已安装 liburing 开发包。保存为 batch.c,使用 cc batch.c -luring -o batch && ./batch 编译运行。
#include <liburing.h>
#include <stdio.h>
#include <string.h>

int main(void) {
    struct io_uring ring;
    int ret = io_uring_queue_init(16, &ring, 0);
    if (ret < 0) {
        fprintf(stderr, "queue_init: %s\n", strerror(-ret));
        return 1;
    }

    for (unsigned i = 0; i < 8; ++i) {
        struct io_uring_sqe *sqe = io_uring_get_sqe(&ring);
        if (sqe == NULL) {
            fprintf(stderr, "no free SQE\n");
            io_uring_queue_exit(&ring);
            return 1;
        }
        io_uring_prep_nop(sqe);
        io_uring_sqe_set_data64(sqe, i);
    }

    ret = io_uring_submit(&ring);
    if (ret < 0) {
        fprintf(stderr, "submit: %s\n", strerror(-ret));
        io_uring_queue_exit(&ring);
        return 1;
    }
    printf("submitted=%d\n", ret);

    int completed = 0;
    while (completed < 8) {
        struct io_uring_cqe *cqe;
        ret = io_uring_wait_cqe(&ring, &cqe);
        if (ret < 0) {
            fprintf(stderr, "wait_cqe: %s\n", strerror(-ret));
            io_uring_queue_exit(&ring);
            return 1;
        }
        if (cqe->res < 0) {
            fprintf(stderr, "operation failed: %s\n", strerror(-cqe->res));
        }
        ++completed;
        io_uring_cqe_seen(&ring, cqe);
    }

    printf("completed=%d\n", completed);
    io_uring_queue_exit(&ring);
    return 0;
}
预期输出:
submitted=8
completed=8
如果内核版本、容器安全策略或系统配置禁止 io_uring,初始化阶段可能直接失败;这属于运行环境限制,而不是示例的完成语义发生变化。
它没有消失的成本
io_uring 不会自动消除设备延迟、内核协议栈处理、调度排队,也不会让普通 read 或 write 天然变成零拷贝。数据是否复制、请求是否能真正异步、某个操作能否绕过阻塞线程,都取决于具体 opcode、文件类型、内核版本和注册方式。
因此判断收益时,先看服务是否存在大量高频、小粒度 I/O 和系统调用往返,再看能否稳定批量提交与处理完成事件。若业务瓶颈本来就在 CPU 计算、锁竞争或上游延迟,单纯把 epoll 改成 io_uring,通常不会自动得到同等级的性能提升。