
计算机网络 / 系统课时
perf怎么看出热点函数
perf怎么看出热点函数
当压测已经稳定,但 CPU 仍然是主要瓶颈时,perf 可以回答“CPU 时间到底花在哪些函数上”。本节用采样、调用栈和 Self/Children 开销定位热点,并区分事件循环、内存拷贝与业务处理三类常见成本。
学习目标
- 能对运行中的网络服务采样 CPU,并生成带调用栈的 perf.data
- 能根据 Self 与 Children 开销区分“函数自身慢”和“下游调用链慢”
- 能把热点归类到事件循环、拷贝或业务处理,并据此选择下一步优化方向
先确认采样对象与负载稳定
perf 只能解释采样期间真正发生的工作,所以应先启动服务,再用固定参数持续压测,让 CPU 进入稳定区间。采样窗口通常取几十秒即可;太短容易被偶然事件主导,太长则增加数据量和分析成本。
对多线程 Reactor 服务,不要只看某个工作线程是否“忙”,而要看 CPU 样本最终落到哪些符号。若服务使用多个进程,则应明确采样哪个 PID,或者分别采样后再比较。<PID> 替换为被测进程的实际进程号。
采样调用栈并生成报告
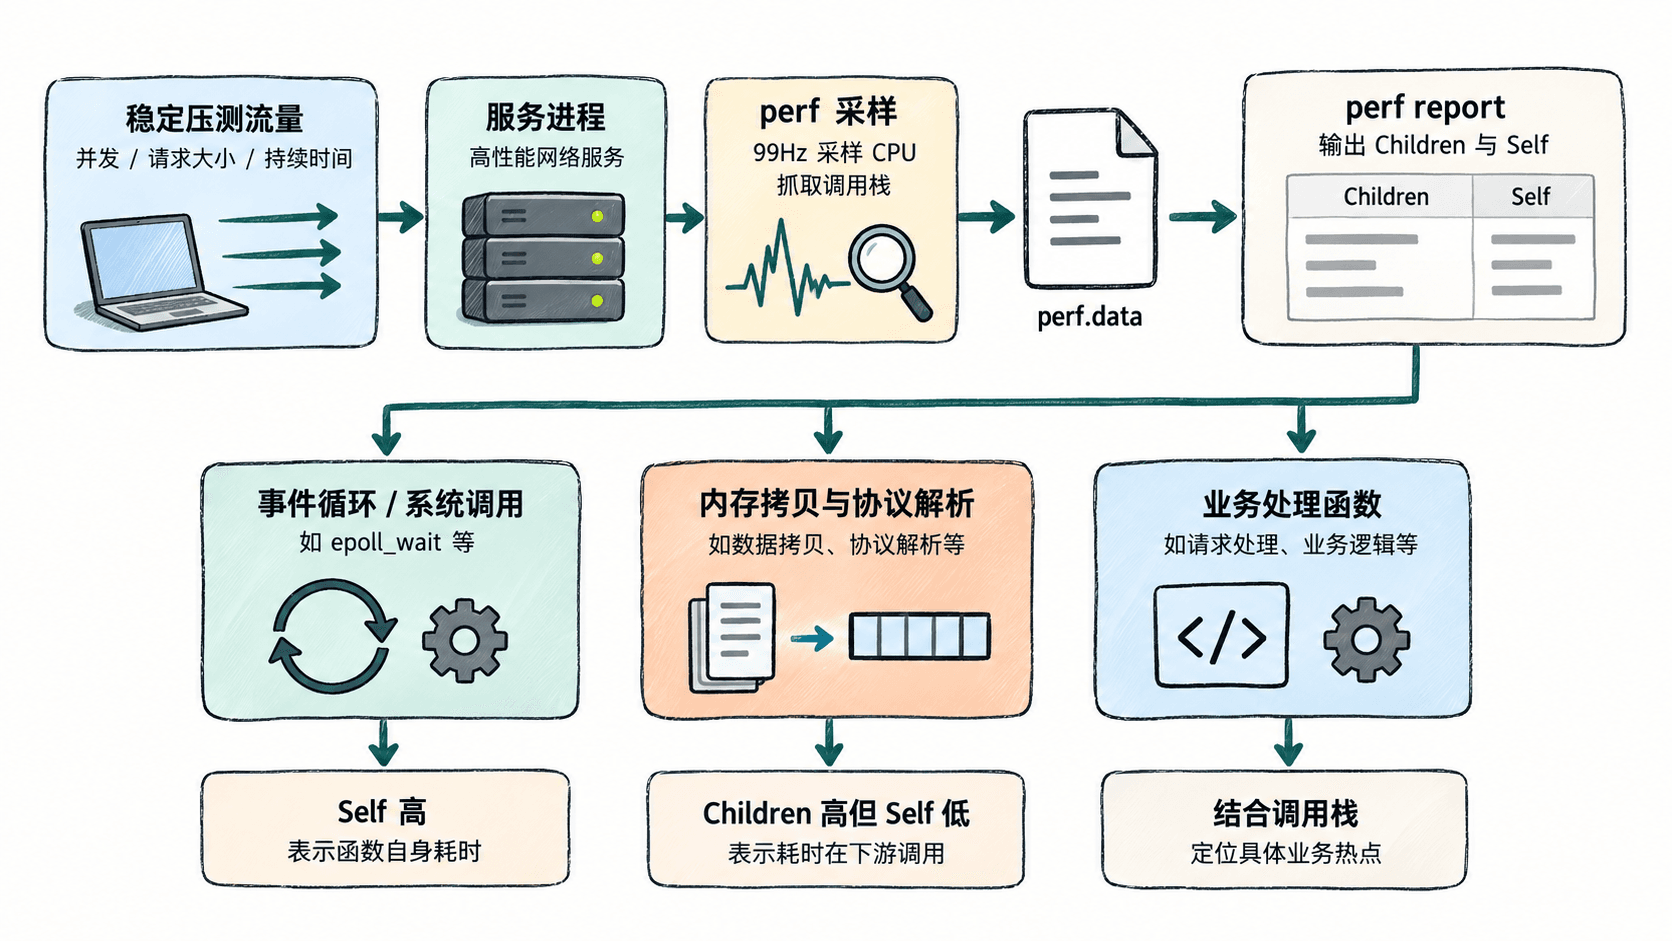
下面用软件事件 cpu-clock 以 99 Hz 采样 30 秒,同时记录调用栈。--children 会把子调用的开销向父节点累计,因此报告会同时显示 Children 与 Self,更适合判断热点到底位于当前函数还是其调用链下游。
perf record -F 99 -e cpu-clock -g -p <PID> -- sleep 30
perf report --stdio --children --percent-limit 1
预期输出
[ perf record: Captured and wrote <SIZE> MB perf.data ]
# Samples: <COUNT> of event 'cpu-clock'
# Children      Self  Command  Shared Object  Symbol
     <PCT>%    <PCT>%  server   <DSO>          <SYMBOL>
<PCT>% <PCT>% server <DSO> <SYMBOL><SIZE>、<COUNT>、<PCT>、<DSO> 和 <SYMBOL> 都由实际运行环境决定。若 perf 报权限错误,应先检查系统的 perf 访问限制;不要为了得到结果直接在生产环境长期放宽内核安全配置。若调用栈大量出现 [unknown] 或明显断裂,还应检查符号信息与栈展开方式,必要时使用保留帧指针的构建。
用 Self 和 Children 找真正热点
Self 表示样本直接落在该函数本身的比例。某个拷贝函数 Self 很高,通常说明 CPU 确实消耗在复制数据;如果事件循环函数 Children 很高而 Self 很低,则更可能是它调用的解析、业务逻辑或系统调用耗时,而不是循环框架本身。
网络服务里常见的几类热点可以这样判断:epoll_wait 占比高但整体 CPU 不高,往往只是线程在等待事件;memcpy、copy_user_* 或缓冲区处理函数占比高,需要检查不必要的数据复制;业务 handler、序列化或压缩函数占比高,则优化重点应回到业务路径,而不是更换 I/O 模型。
把调用栈变成下一步实验
定位到候选热点后,应通过一次只改变一个因素的实验验证。例如怀疑拷贝开销,就减少一次用户态缓冲区复制,再用同一压测参数重复 perf;若对应函数 Self 明显下降且吞吐或尾延迟改善,才说明判断成立。
如果热点主要集中在事件分发与系统调用路径,可以继续比较批量收发、事件批处理或 io_uring 提交方式;如果热点落在业务 handler,则换 I/O 模型通常不会带来同等收益。perf 的价值不是给出一个“最慢函数”标签,而是把 CPU 时间和真实调用路径连接起来,让优化建立在可验证的证据上。